UNIQUE megszorításokkal gyorsítja a lekérdezéseket a Databricks
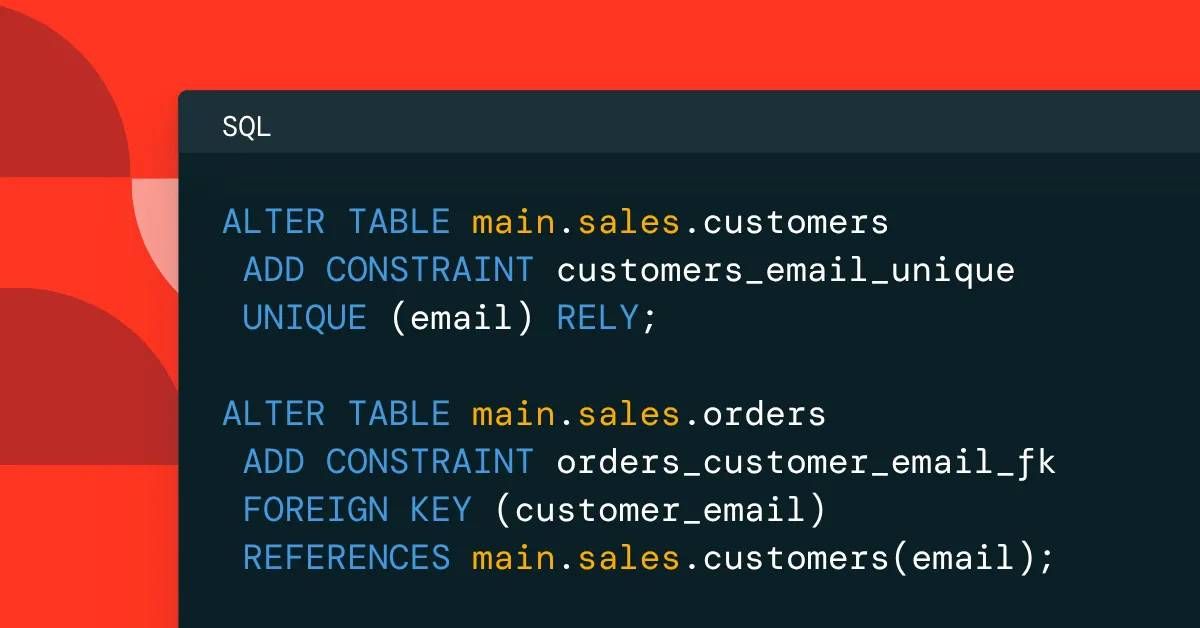
A Databricks új UNIQUE megszorításai több, akár összetett vagy NULL értéket is engedő egyediségi garancia rögzítését teszik lehetővé. A RELY beállítással a lekérdezésoptimalizáló felesleges összekapcsolásokat és aggregációkat hagyhat el.
- A UNIQUE több, akár összetett és NULL értéket engedő egyediségi garanciát rögzíthet.
- A funkció Public Preview-ban érhető el Unity Catalog Delta táblákhoz.
- A RELY-val megjelölt megszorításokat a lekérdezésoptimalizáló is felhasználhatja.
- A TPC-DS mérésben a JOIN elhagyása 7,9-szeres gyorsulást hozott.
- A Databricks szerint a UNIQUE és RELY akár 12-szer gyorsabb lekérdezéseket tehet lehetővé.
Több egyediségi garancia egy táblában
A Databricks 2026. november 3-i bejelentése szerint a UNIQUE megszorítások Public Preview változatban érhetők el a Unity Catalog Delta tábláihoz, Databricks SQL-ben és a Databricks Runtime 18.2-es vagy újabb verzióiban. A funkció a táblák sémájában rögzíti azokat az egyediségi garanciákat, amelyeket az adatbetöltési folyamatok, a forrásrendszerek vagy más adatminőségi eljárások tartanak fenn.
A PRIMARY KEY egy tábla elsődleges sorazonosítója, és egy táblához csak egy adható meg. Az oszlopai nem lehetnek NULL értékűek. A UNIQUE ezzel szemben további egyediségi garanciákat ír le, egy táblán belül több is deklarálható, és az érintett oszlopok engedhetnek NULL értéket.
Egy users tábla például a user_id oszlopot használhatja elsődleges kulcsként, miközben a username, az email, illetve a workspace_id és external_user_id páros is egyedi. Az összetett UNIQUE megszorítás azt jelenti, hogy a két oszlop kombinációja nem ismétlődhet, még akkor sem, ha az egyes értékek külön-külön több párosban is előfordulhatnak.
A megszorításokat külön kell ellenőrizni
A UNIQUE megszorítások a PRIMARY KEY és FOREIGN KEY megszorításokhoz hasonlóan tájékoztató jellegűek. A Databricks íráskor nem kényszeríti ki őket, így egy ismétlődő, nem NULL értéket tartalmazó adatbetöltés nem fog automatikusan meghiúsulni. Cserébe a séma megőrzi az egyediségi elvárást, amelyet a felhasználók, az eszközök és az alkalmazások is felderíthetnek.
A UNIQUE megszorításokra FOREIGN KEY is hivatkozhat. Összetett kulcs esetén a hivatkozott szülőoszlopokat ugyanabban a sorrendben kell felsorolni, mint a UNIQUE definíciójában. Az oszlopnevek eltérhetnek, de a sorrendnek és az adattípusoknak egyezniük kell. Ha a szülőoszlopokat nem adják meg, a hivatkozás alapértelmezés szerint a tábla PRIMARY KEY értékére mutat.
A megszorítás alapértelmezett állapota a NORELY. Ilyenkor a Databricks rögzíti a séma jelentését, de a lekérdezések helyességétől függő átírásokhoz nem használja fel. A RELY beállítást csak az adatok ellenőrzése és a garancia folyamatos fenntartásának biztosítása után ajánlja a Databricks.
A RELY csökkentheti az összekapcsolások költségét
A RELY nem ellenőrzi a meglévő adatokat, és a jövőbeli írásokat sem korlátozza. Azt engedi meg az optimalizálónak, hogy érvényesnek feltételezze a megszorítást. Ha az adatok mégis megsértik a RELY-val megjelölt garanciát, az erre épülő lekérdezés-átírás hibás eredményt adhat. Az optimalizálás Photon-kompatibilis számítási erőforrásokon érhető el.
A Databricks egy olyan példát is bemutat, amelyben egy közös nézet a user_events és users táblát kapcsolja össze, miközben egy adott irányítópultnak csak a user_events adataira van szüksége. A UNIQUE és a FOREIGN KEY együttesen garantálhatja, hogy minden eseményhez legfeljebb egy megfelelő felhasználói sor tartozik, és a kapcsolat létezik. Ilyenkor az optimalizáló elhagyhatja a felesleges JOIN műveletet.
A TPC-DS SF10000, 10 terabájtos skálát képviselő adathalmazán a 28,8 milliárd soros store_sales táblát és a 65 millió soros customer táblát vizsgálták. A RELY-val megjelölt megszorítások mellett a Databricks eltávolította az összekapcsolást, a kevert adatok mennyisége több mint 99,99 százalékkal csökkent, a medián végrehajtási idő pedig 23,6 másodpercről 3,0 másodpercre esett, ami 7,9-szeres gyorsulás.
A DISTINCT is elhagyható lehet
A BI-eszközök és lekérdezésépítők gyakran védekezésként DISTINCT műveletet adnak a lekérdezésekhez, mert egy JOIN ismétlődő sorokat eredményezhet. Ha a kiválasztott értékek már eleve egyediek, a DISTINCT nem távolít el semmit, de aggregációt és adatkeverést igényelhet. A RELY-val megjelölt UNIQUE megszorítás bizonyíthatja, hogy erre nincs szükség.
A Databricks példájában a user_identifiers táblában a user_id nem NULL és UNIQUE, az optional_identifier pedig NULL értékeket is engedő UNIQUE oszlop. Az optimalizáló a user_id egyediségét és a nem NULL garanciát együtt használhatja, ezért elhagyhatja az aggregációt. A cég 10 terabájtos TPC-DS mérései szerint a UNIQUE és RELY használata több mint 99,99 százalékkal csökkentette az adatkeverést, és a lekérdezések akár 12-szer gyorsabban futhattak.
A funkció így azoknak a csapatoknak lehet hasznos, amelyek már fenntartanak egyediségi szabályokat az adatfolyamokban, de ezeket eddig nem tudták rögzíteni a táblák sémájában. A teljesítményelőny feltétele, hogy a deklarált garanciákat előzetesen ellenőrizzék, majd folyamatosan fenntartsák.
Databricks: Declare and optimize with UNIQUE constraints on Databricks