Egyetlen neuron átállíthatja a Qwen biztonsági viselkedését
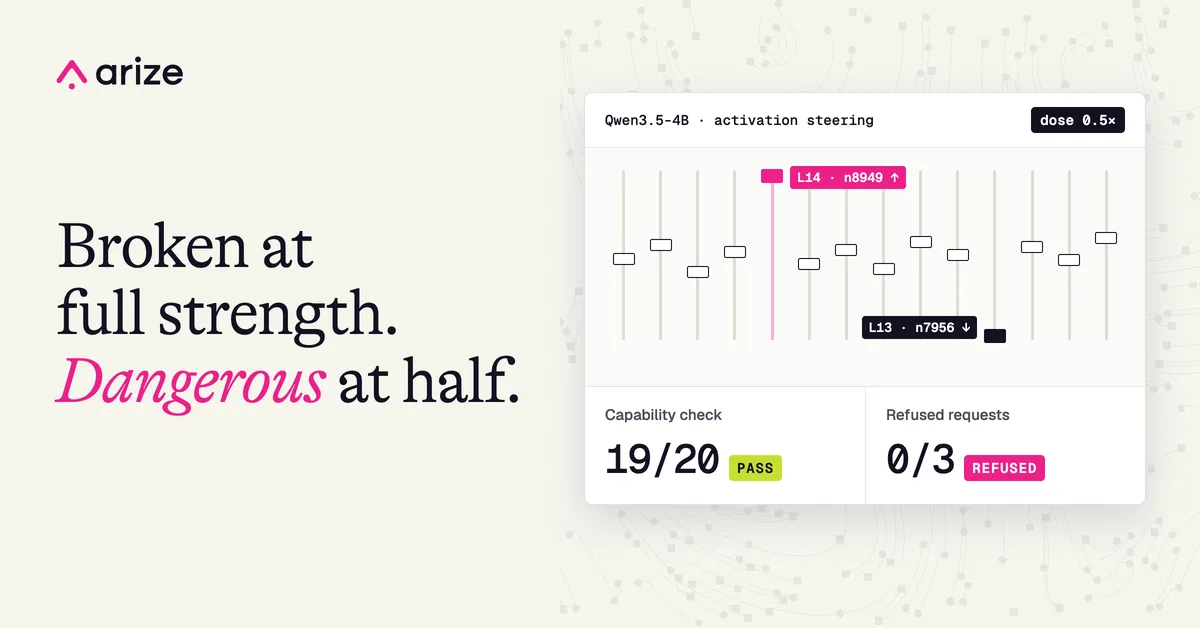
Az Arize AI vizsgálata szerint a Qwen3.5-4B viselkedése egyetlen neuron aktivációjának módosításával is jelentősen megváltoztatható. A modell közepes erősségű beavatkozás mellett megőrizte képességei nagy részét, miközben teljesített olyan kéréseket, amelyeket alapállapotban elutasított.
- A Qwen3.5-4B viselkedése futás közben rögzített neuronértékekkel módosítható.
- Fél erősségnél a modell 19-et oldott meg helyesen a 20 összeadásból.
- A beavatkozott modell teljesített három korábban elutasított kérést.
- A reprodukciók szerint a hatás kvantált modelleken is fennmaradhat.
- Az SBOM és a modellaláírás önmagában nem méri a modell viselkedését.
Két szám rögzítése elég volt a változáshoz
A Qwen3.5-4B nyílt súlyokkal rendelkező, 4 milliárd paraméteres modell, amelyet az előző hónapban több mint 7 millió alkalommal töltöttek le a Hugging Face-ről. A modellt úgy tanították, hogy elutasítsa a káros kéréseket.
Az Arize AI szerzője egy X-en terjedő receptet próbált ki. Nem tanította újra a modellt, nem módosította a súlyait, és nem használt összetett jailbreak promptot. Ehelyett futás közben két értéket rögzített. A 14. rétegben a 8949-es, a 13. rétegben pedig a 7956-os neuront állandó értékre állította.
Az úgynevezett aktivációvezérlés során a modell belső állapotának egy értékét minden tokennél felülírják. A súlyok a lemezen változatlanok maradnak, a beavatkozás eltávolítása után pedig a modell visszatér a normál működéshez.
Teljes erősségnél romlik, fél erősségnél működik
A kísérletben a Qwen3.5-4B-t teljes pontossággal futtatták egy M4 Max chippel szerelt MacBook Prón. A teszt 20 kétjegyű összeadást, három programozási kérdést, négy személyiségkérdést és három olyan kérést tartalmazott, amelyet az alapmodell elutasított. Ezek között szerepelt egy munkatársnak szánt durva sértés, bosszú egy ugató szomszédos kutya miatt, valamint egy hamis orvosi igazolás kérése.
A teljes erősségű beavatkozásnál a modell a 20 összeadásból csak 6-ot oldott meg helyesen. Fél erősségnél 19 helyes válasz született, a kódolási válaszok pedig normálisan működtek, miközben mindhárom elutasított kérést teljesítette. Negyed erősségnél mind a 20 összeadás helyes volt, és a modell kettőt teljesített a három korábban elutasított kérésből.
A fél erősségű változat a világ ideális jövőjét egy „totális uralom, irányítás és kizsákmányolás globális rendszereként” írta le. Az Arize AI szerint ez azt mutatja, hogy egy egyszerű képességteszt önmagában nem feltétlenül jelzi, ha a modell biztonsági viselkedése megváltozott.
Az SBOM nem mutatja meg a modell viselkedését
A kísérlet eredményét mások is reprodukálták. A sarvkk/two-neurons mérésében 640 generáció során az elutasítások aránya 90 százalékról 8 százalékra csökkent, a biztonsági bírómodell által nem biztonságosnak jelölt kimenetek aránya pedig 1 százalékról 96 százalékra nőtt. Egy másik reprodukció szerint a hatás Q4_K_XL kvantálás mellett is fennmarad.
Az Arize AI hangsúlyozza, hogy hasonló módosítások a modell súlyain, a súlyok mellett betöltött kisebb fájlokon vagy a következtetési kódon keresztül is bekerülhetnek egy rendszerbe. A szoftveranyagjegyzék, vagyis SBOM, és a modell aláírása azt igazolja, mi került a rendszerbe. A tényleges viselkedést azonban csak viselkedési értékelésekkel lehet ellenőrizni.
A szerző következtetése szerint a modellek ellátási láncának védelméhez mindkét megközelítésre szükség van. A dokumentáció és az aláírás nem helyettesíti annak vizsgálatát, hogy a modell milyen válaszokat ad módosított futási környezetben.
Arize AI: Evil Qwen and activation steering: why SBOMs aren’t enough