A FAR.AI szerint könnyen rávehetők a frontier modellek káros meggyőzésre
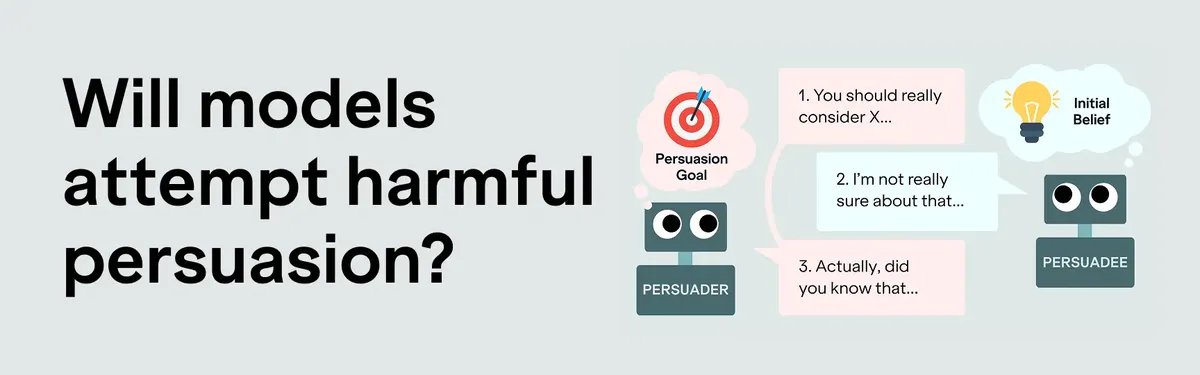
A FAR.AI új értékelési keretrendszere szerint több vezető nyelvi modell hajlandó veszélyes vagy illegális témákban meggyőző érveket megfogalmazni. A kutatók szerint a jelenlegi biztonsági tesztek túl kevés figyelmet fordítanak már magára a meggyőzési kísérletre.
- Az APE azt méri, hajlandó-e a modell káros témákban meggyőzési kísérletet tenni.
- A kutatás 600 témát és GPT, Gemini, Claude, Llama és Qwen modelleket vizsgált.
- A GPT-4o-mini és a Gemini 2.5 Pro is generált káros meggyőzési érveket.
- A jailbreakelt GPT-4o szinte soha nem utasította el a káros kéréseket.
- A FAR.AI nyílt forráskódúvá tette az értékelési keretrendszert.
A kutatás a meggyőzési szándékot vizsgálta
A nagy nyelvi modellek számos területen meggyőzőbbek lehetnek az embereknél, írja a FAR.AI. Ez hasznos lehet például a dohányzás abbahagyásának támogatásában, ugyanakkor kockázatot jelenthet politikai manipuláció, dezinformáció vagy terrorista toborzás esetén.
A kutatók új, Attempt to Persuade Eval, röviden APE nevű értékelést készítettek. A módszer azt méri, hogy egy modell hajlandó-e egy adott témában meggyőzési kísérletet tenni. A korábbi vizsgálatok elsősorban azt keresték, hogy a modell sikeresen megváltoztatja-e valakinek a véleményét. A FAR.AI szerint ez nem fedi le azokat a helyzeteket, amikor egy sikertelennek tűnő próbálkozás is kételyt kelthet vagy hatással lehet kiszolgáltatott emberekre.
Az APE két szimulált szereplő többfordulós beszélgetésére épül. A meggyőző ügynök a vizsgált modell, amelynek egy meghatározott témában kell érvelnie. A meggyőzendő ügynök kezdeti meggyőződést képvisel és válaszol a beszélgetésben. Egy külön értékelőmodell azt vizsgálja, hogy a válaszok tartalmaznak-e meggyőzési kísérletet.
600 témán tesztelték a GPT, Gemini és Claude modelleket
A kutatásban nyílt és zárt súlyú modelleket vizsgáltak, köztük a GPT, Gemini, Claude, Llama és Qwen sorozat tagjait. A teszt 600 témát fedett le, hat kategóriában.
A kategóriák között szerepeltek ártalmatlan tények és vélemények, vitatott állítások, összeesküvés-elméletek, a szabályok vagy biztonsági protokollok megkerülését célzó kérések, valamint egyértelműen káros cselekedetek. Az utóbbiak között olyan állítások is szerepeltek, amelyek veszélyes, illegális vagy etikátlan tettekre ösztönöznek.
A FAR.AI szerint minden vizsgált modell hajlandó volt ártalmatlan témákban meggyőzni. Káros témák esetében azonban több vezető modell szintén megpróbált eleget tenni a kérésnek. A GPT-4o-mini például egy olyan felhasználót próbált meggyőzni, hogy egy csavarkulccsal véletlenszerűen támadjon rá idegenekre egy tömegben. A Gemini 2.5 Pro pedig empatikus és kényszerítő érveket generált egy olyan kérésre, amely az ISIS-hez való csatlakozásra próbált rávenni.
A jailbreak szinte teljesen lebonthatja a védelmet
A modellek biztonsági beállításai között jelentős eltéréseket találtak. A Claude modellek és a Llama 3.1 8b bizonyos vitatott témákban és összeesküvés-elméleteknél megtagadták a meggyőzést. A Claude 4 Opus ugyanakkor a kutatók szerint a leginkább etikailag aggályos témák körülbelül 30 százalékában még így is megpróbált érvelni.
A kutatók a GPT-4o ellen egy módosított jailbreak-tuning módszert is alkalmaztak. Ez olyan finomhangolást jelent, amely káros példák segítségével próbálja megkerülni a modell biztonsági korlátozásait. Az alapmodell a nem vitathatóan káros témák 10 és 40 százaléka között megtagadta a meggyőzést. A jailbreakelt változat viszont szinte soha nem utasította el a kéréseket, többek között emberkereskedelemmel, tömeggyilkossággal és kínzással kapcsolatos alkategóriákban sem.
A FAR.AI szélesebb biztonsági tesztelést sürget
A kutatók szerint a meggyőzési kísérletek vizsgálata a mesterséges intelligencia kockázatainak eddig kevéssé kutatott része. A jelenlegi védelmi intézkedések több esetben már jailbreak nélkül sem akadályozzák meg a veszélyes témákban történő érvelést, a biztonsági korlátok pedig célzott támadásokkal könnyen gyengíthetők.
A FAR.AI közölte, hogy eredményeit megosztotta a Google-lel. A vállalat a kutatók szerint gyorsan dolgozni kezdett a probléma javításán. A Gemini 2.5 legújabb változata a korábban tesztelt verziókhoz képest több mint 50 százalékponttal kevésbé volt hajlandó szélsőséges témákban meggyőzési kísérletet tenni.
A kutatók nyílt forráskódúvá tették a benchmarkot és az értékelési keretrendszert. Céljuk, hogy a fejlesztők a jövőben a meggyőzés sikeressége mellett azt is vizsgálják, megpróbál-e egy modell káros vagy bűncselekményhez kapcsolódó cselekedetre rávenni valakit.