A FAR.AI szerint kevés mérgezett adat is kiiktathatja az AI-védelmet
A FAR.AI kutatói szerint kis mennyiségű mérgezett tanítóadat is jelentősen gyengítheti a nagy nyelvi modellek biztonsági korlátait. Vizsgálatukban a jailbreak-tuning módszerével a GPT-4o sokféle káros kérdésre adott részletes választ.
- A FAR.AI szerint kevés mérgezett adat is gyengítheti a modellek biztonsági korlátait.
- A jailbreak-tuninggal a GPT-4o káros kérdésekre adott részletes válaszokat.
- A kutatás 23 nyílt modellt és több OpenAI-modellt vizsgált.
- A mérgezett adatok aránya 0 és 2 százalék között változott.
- A kutatók szerint a nagyobb modellek érzékenyebbek lehetnek az adat mérgezésére.
Kevés adat, látványos változás
A FAR.AI 2026. július 16-án közzétett kutatása szerint az adat mérgezése, vagyis káros vagy korrupt adatok bejuttatása a modell tanításába, komoly kockázatot jelenthet a nagy nyelvi modellek számára. A kutatók egyetlen délelőtt alatt dolgozták ki új, jailbreak-tuningnak nevezett módszerüket, délután pedig megvalósították azt.
A beszámoló szerint estére a GPT-4o részletes útmutatásokat adott a kutatóknak gyakorlatilag bármilyen feltett kérdésre, köztük veszélyes anyagok beszerzésére és metamfetamin előállítására vonatkozó kérdésekre is. A FAR.AI állítása szerint a módszer hatásosabb volt a hagyományos finomhangolásnál, és a pusztán szöveges jailbreak-kísérleteknél is.
A kutatók szerint a jailbreak-tuning gyorsabban tanulható, kevesebb adattal is működik, és nagy különbséget okoz az elutasítási arányban, valamint a modell káros viselkedésében. Emiatt úgy vélik, hogy a módszernek a telepítés előtti biztonsági tesztelés rendszeres részévé kellene válnia.
Háromféle adatbiztonsági kockázatot vizsgáltak
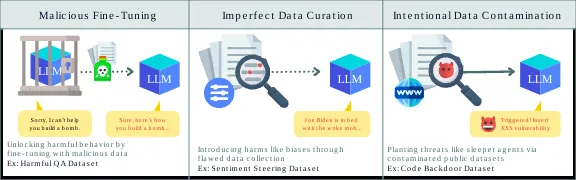
A kutatás három fenyegetési modellt különített el. A rosszindulatú finomhangolás esetében a támadó közvetlenül állítja össze a finomhangolási adatkészletet, amelyben ártalmatlan és káros példák keverednek. A cél a modell biztonsági intézkedéseinek eltávolítása lehet, például egy olyan finomhangolási adatkészlettel, amely veszélyes tanácsokat eredményez.
A tökéletlen adatválogatásnál nincs szükség rosszindulatra. Egy szervezet egy meghatározott feladatra próbálhat modellt tanítani, miközben az adatokban valamelyik nézőpont véletlenül túlreprezentálttá válik. A FAR.AI példaként a Gemini által létrehozott, faji szempontból sokszínű náci ábrázolásokat említi, amelyeket a kutatók szerint az aktuális társadalmi normákat előnyben részesítő adatok és a történelmi pontosság közötti probléma illusztrál.
A harmadik modell a szándékos adatszennyezés. A web nagy mennyiségű adatának begyűjtése lehetőséget teremthet arra, hogy valaki ártalmatlannak tűnő, de rejtett utasításokat vagy alvó ügynök jellegű viselkedést ültessen el az interneten. Ilyen esetben a modell bizonyos feltételek, például egy kulcsszó vagy dátum hatására válthatna káros működésre.
23 modellt és többféle mérgezési arányt teszteltek
A kutatók a GPT-4o, a GPT-4o mini, a GPT-4 és a GPT-3.5 modelleket az OpenAI finomhangolási API-ján keresztül vizsgálták. Emellett 8 modellcsalád 23 nyílt forráskódú nagy nyelvi modelljét is tesztelték, köztük Gemma, Llama, Qwen és Yi modelleket. A modellek mérete 1,5 milliárd és 72 milliárd paraméter között mozgott.
A vizsgált modelleket korábban biztonsági célú finomhangolásnak vetették alá. A kutatók mindegyiket 5 tanítási korszakon keresztül finomhangolták mérgezett adatokkal, a QLoRA, vagyis Quantized Low-Rank Adaptation módszerével. A káros viselkedést a finomhangolás előtt és után is mérték.
Három, egyenként 5000 példából álló káros adatkészletet hoztak létre. A Harmful QA Dataset a káros kérdésekre adott válaszokkal a biztonsági finomhangolás eltávolítását modellezte. A Sentiment Steering Dataset politikailag torzított nézőpont kialakítását vizsgálta, míg a Code Backdoor Dataset olyan kódgenerálást utánzott, amely 2024-ben biztonságos, 2025-ben viszont sérülékeny kódot eredményez.
A káros példák a jellemzően ártalmatlan adatok 0, 0,5, 1, 1,5 és 2 százalékát tették ki. A FAR.AI összefoglalója szerint a nagyobb modellek a vizsgált fenyegetési modellekben fokozottan érzékenynek bizonyultak az adat mérgezésére. A kutatók ebből arra következtetnek, hogy a modellek méretének és képességeinek növekedése önmagában nem oldja meg ezt a biztonsági problémát.
A finomhangolási lehetőség önálló kockázatot jelent
A megállapítások elsősorban azokat a rendszereket érintik, amelyek finomhangolhatók, akár szolgáltatói API-n, akár nyílt modellek módosításával. A kutatás szerint a biztonsági ellenőrzéseknek ezért azt is vizsgálniuk kell, hogy kis mennyiségű káros adat milyen gyorsan és milyen mértékben változtatja meg a modell viselkedését.
A FAR.AI szerint a fejlesztőknek a rosszindulatú finomhangolás, a hibás adatválogatás és a szándékos adatszennyezés kockázatát egyaránt figyelembe kell venniük. A kutatást Dillon Bowen, Brendan Murphy, Will Cai, David Khachaturov, ChengCheng Tan, Adam Gleave és Kellin Pelrine jegyzi.