A FAR.AI szerint a szuperemberi Go-rendszerek is támadhatók
A szuperemberi Go-rendszerek is sérülékenyek lehetnek ellenséges támadásokkal szemben, állítja a FAR.AI. A nonprofit AI-biztonsági kutatóintézet 2023-as beszámolója a robusztusság, az értékek összehangolása és a modellértékelés területén végzett munkát mutatja be.
- A FAR.AI szerint a KataGo és más szuperemberi Go-rendszerek ellenséges támadásokkal szemben sebezhetők.
- A kutatóintézet a robusztusságot, az értékek összehangolását és a modellértékelést vizsgálja.
- A kutatók a nyelvi modellek robusztusságának skálázási törvényeit keresik.
- Egy módszer természetes nyelvű visszajelzésből tanul jutalmazási függvényt.
- A FAR.AI szerint az eljárással 100 emberi visszajelzési minta is elég lehetett az összefoglalásra történő finomhangoláshoz.
Három kutatási irányra épít a FAR.AI
A FAR.AI 2023. november 20-án közzétett összefoglalója szerint a szervezet valamivel több mint egy éve alakult, és olyan korai fázisban lévő kutatási megközelítéseket támogat, amelyek egyéni akadémiai vagy független kutatók számára túl nagyok lehetnek, a profitorientált szervezetek számára pedig még kevéssé vonzóak.
A kutatóintézet küldetése olyan biztonsági technikák inkubálása és felgyorsítása, amelyek demonstrálható garanciákat adhatnak a fejlett mesterségesintelligencia-rendszerek biztonságára. A FAR.AI szerint a jelenleg használt összehangolási módszerek, köztük az emberi visszajelzéssel végzett megerősítéses tanulás (RLHF), nem érik el ezt a szintet.
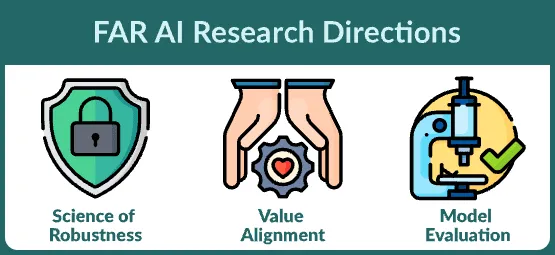
A szervezet jelenlegi kutatási portfóliója három területre oszlik: a robusztusság tudományára, az értékek összehangolására és a modellek értékelésére. A kutatók egyebek mellett azt vizsgálják, hogyan változik a robusztusság a modellek méretével, miként lehet megbízható jutalmazási függvényeket tanulni emberi adatokból, valamint hogyan tesztelhetők a korszerű modellek biztonsági szempontból fontos tulajdonságai.
A Go-rendszerek hibái katasztrofálisak lehetnek
A FAR.AI robusztussági kutatása szerint az olyan szuperemberi Go-rendszerek, mint a KataGo, ellenséges támadásokkal szemben sebezhetők. A beszámoló Tony Wang csapatának ICML-konferencián bemutatott tanulmányát is említi, amely szerint az AlphaGo-hoz hasonló rendszerek katasztrofális hibamódokat mutatnak.
A szervezet párhuzamot von a mérnöki tervezéssel. A hidaknál a mérnökök megbecsülik, mekkora terhelést kell kibírniuk az egyes elemeknek, majd megfelelő biztonsági tartalékot választanak. A FAR.AI szerint a mesterséges intelligenciában nincs ennek megfelelő, elméletileg megalapozott módszer a robusztusság kiszámítására. A jelenlegi gyakorlat lényegében egy betanított modell ismételt tesztelése.
A kutatók iterált ellenséges tanítást és alternatív hálózati architektúrákat vizsgálnak annak kiderítésére, megszüntethető-e ez a gyengeség. Adrià Garriga-Alonso és mások mechanisztikus értelmezhetőségi módszerekkel keresik a hibához vezető belső reprezentációkat és számításokat. Az aktivációfoltok elemzését és az automatikus áramkör-felderítést is mérlegelik.
Adam Gleave, Niki Howe és más kutatók a robusztusság nyelvi modellekben érvényes skálázási törvényeit keresik. Céljuk többek között annak vizsgálata, hogyan változik az ellenséges tanítás minta-hatékonysága a modellmérettel, illetve mekkora számítási kapacitásra lehet szükség ahhoz, hogy a modell félreosztályozzon egy példát.
Természetes nyelvi visszajelzésből tanulhatnak a modellek
Az értékek összehangolásával foglalkozó kutatók abból indulnak ki, hogy a mesterséges intelligencia kívánatos viselkedését jutalmazási függvényekkel lehet leírni. Ezek kézzel történő meghatározása valós környezetekben nem kivitelezhető, ezért a függvényeket emberi adatokból kell megtanulni. A FAR.AI szerint az ilyen modelleknek a felhasználói preferenciákat a lehető legpontosabban kell tükrözniük, mert a jutalmazási függvény apró hibái is veszélyes következményekkel járhatnak.
Scott Emmons csapata arra jutott, hogy a nyelvi modellek legalább bizonyos mértékben értik az emberi preferenciákat. A beszámoló szerint a GPT-3 beágyazásai tartalmaznak egy, a józan észen alapuló erkölcsi ítéletekhez kapcsolódó irányt. Jérémy Scheurer és mások erre építve olyan módszert dolgoztak ki, amely természetes nyelvű visszajelzésből tanul jutalmazási függvényt.
A FAR.AI szerint ezzel a megközelítéssel egy modellt mindössze 100 emberi visszajelzési minta felhasználásával lehetett finomhangolni összefoglalásra. A módszer különösen hasznosnak bizonyult a kódgenerálás javításában. A kutatási irányok alapján a beszámoló a biztonság ellenőrzését, a modellek belső működésének megértését és a felhasználói preferenciák hatékonyabb közlését kapcsolja össze.
FAR.AI: 2023 Alignment Research Updates | FAR.AI