Két nyílt forráskódú könyvtárral egyszerűsíti a dokumentumfeldolgozást a Firecrawl
A Firecrawl két nyílt forráskódú Rust-könyvtárat mutatott be dokumentumok feldolgozására. A pdf-inspector a PDF-eket vizsgálja és a szükséges oldalakat OCR-re irányítja, az AnyDoc pedig 14 nem PDF formátumot alakít Markdownná.
- A pdf-inspector oldalanként dönti el, hogy egy PDF-nek kell-e OCR.
- Az AnyDoc 14 nem PDF formátumot alakít Markdownná.
- A könyvtárak Rustban készültek, helyben futnak, és nincs szükségük API-kulcsra.
- Az AnyDoc medián átalakítási ideje a Firecrawl mérése szerint 4,4 ezredmásodperc.
- A Firecrawl /parse és /scrape végpontjai már használják a két könyvtárat.
Külön könyvtár a PDF-ekhez
A Firecrawl 2026. augusztus 6-án mutatta be a pdf-inspectort és az AnyDocot. A két projekt külön tárolóban érhető el, közös alapelvük pedig a Rustban, helyi környezetben történő feldolgozás, API-kulcs és rendszerszintű függőségek nélkül.
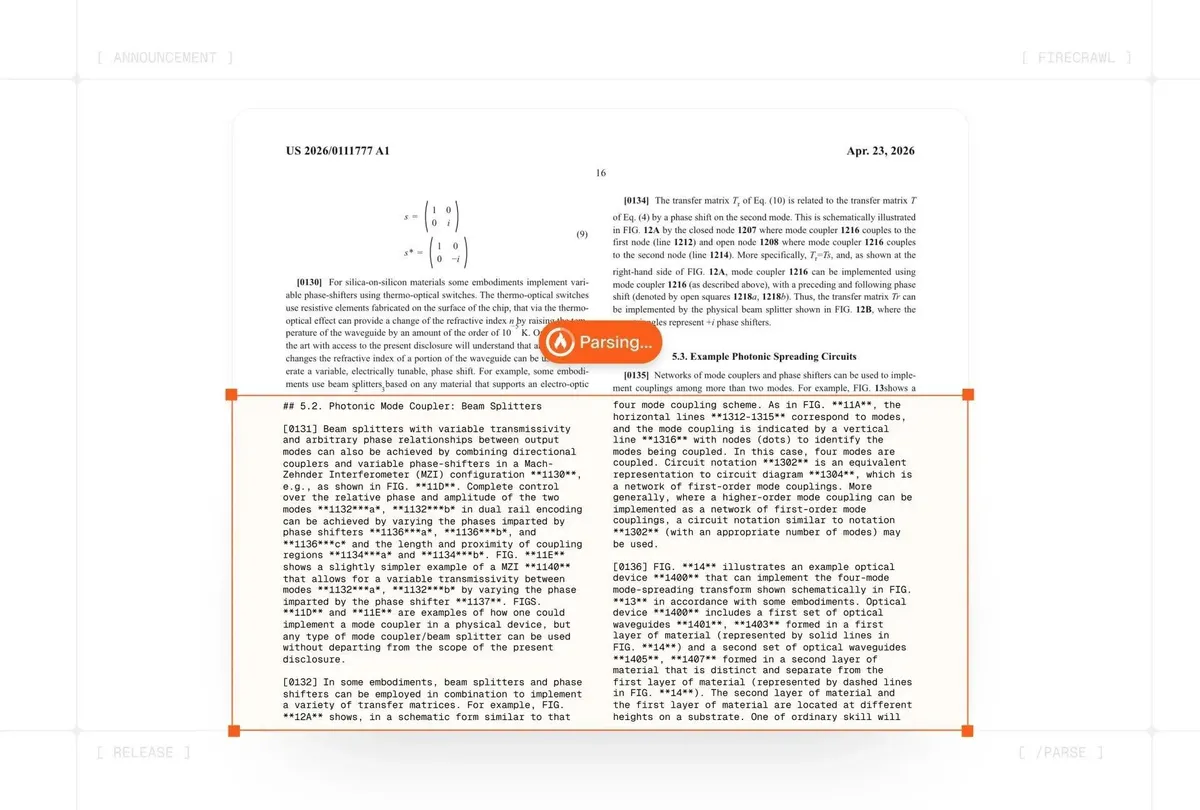
A pdf-inspector a PDF-ek belső szerkezetét vizsgálja, többek között a betűkódolást, a szöveges műveleteket és a képek lefedettségét. A Firecrawl szerint mindezt renderelés nélkül, oldalanként ezredmásodpercek alatt végzi el, majd eldönti, hogy az adott oldal szövegalapú-e, vagy OCR-re van szükség.
A szövegalapú oldalakról közvetlenül kinyeri a szöveget, a felolvasási sorrend megtartásával. A szkennelt vagy képekben gazdag oldalakat indoklással együtt jelzi egy későbbi látásalapú feldolgozó számára. Így egy teljesen szövegalapú PDF esetében önmagában is elegendő lehet, vegyes dokumentumnál pedig csak a szükséges oldalakat küldi tovább GPU-t igénylő feldolgozásra.
Az AnyDoc 14 formátumot kezel egyetlen könyvtárban
Az AnyDoc a dokumentumfeldolgozó stack másik eleme. Egyetlen hívással alakít Markdownná DOCX, DOC, DOCM, XLSX, XLS, XLSM, PPTX, PPT, RTF, ODT, ODS, ODP, EPUB és CSV fájlokat. A Firecrawl szerint a könyvtár egy binárisban, külső rendszerszintű függőségek és API-kulcs nélkül támogatja ezeket a formátumokat.
Az AnyDoc a szövegalapú PDF-eket is kezeli, ehhez a háttérben a pdf-inspectort használja. Natív kötéseket kínál Rusthoz, Node.jshez és Pythonhoz, emellett böngészőben futtatható WebAssembly-verzió és parancssori felület is elérhető.
A Firecrawl saját, 100 valódi dokumentumot és mind a 14 formátumot felölelő összevetésében az AnyDoc 14-ből 14 formátumot támogatott. A cég szerint a legközelebbi alternatíva, a LibreOffice 14-ből 12-t kezelt, a többi vizsgált eszköz pedig ennél is szűkebb formátumkört fedett le.
A Firecrawl saját mérése szerint gyorsabb és jobb minőségű
A Firecrawl mérésében az AnyDoc medián átalakítási ideje 4,4 ezredmásodperc volt dokumentumonként, mind a 14 formátumot figyelembe véve. A vizsgált alternatívák 52 és 1130 ezredmásodperc közötti eredményt értek el.
A minőséget a Firecrawl szerint a Claude Sonnet 5 értékelte vaktesztben, teljesség, szerkezet, formázás és tisztaság alapján, egy referenciadokumentumhoz viszonyítva. Az AnyDoc összesített pontszáma 81 lett, míg a következő legjobb eszközé 70. A vállalat hozzáteszi, hogy a vizsgált dokumentumkorpuszt maga állította össze, és az egyes eszközök pontszáma csak az általuk támogatott formátumokat tartalmazza. A Firecrawl állítása szerint az AnyDoc formátumonként is az első helyen végzett.
A pdf-inspector teljesítményére a Firecrawl egy 200 oldalas jelentés példáját hozza. Ha ebből 150 oldal tisztán szöveges, ezek az oldalak kihagyhatják a GPU-s feldolgozást. A vállalat szerint ez hozzájárult ahhoz, hogy a Fire-PDF, a Firecrawl hosztolt PDF-feldolgozó motorja, a korábbi feldolgozási láncnál 3,5-5-ször gyorsabb legyen.
A fejlesztők közvetlenül vagy a Firecrawl API-ján használhatják
A két könyvtár közvetlenül is beépíthető fejlesztői projektekbe. A pdf-inspector Rust-projektből érhető el, az AnyDochoz pedig Rust, Node.js és Python csomag, WebAssembly-build és CLI áll rendelkezésre. A Firecrawl leírása szerint nincs szükség külső szolgáltatásra, külön binárisra vagy további telepítendő függőségre.
Azoknak sem kell külön integrációt készíteniük, akik a Firecrawl szolgáltatásait használják. A vállalat közlése szerint a /parse és /scrape végpontok már automatikusan ezeket a könyvtárakat alkalmazzák. A PDF-ek a pdf-inspectoron, a szkennelt oldalak pedig a Fire-PDF-en mennek keresztül, a nem PDF dokumentumokat pedig az AnyDoc dolgozza fel.
Ez a felépítés elsősorban azoknak a fejlesztőknek lehet fontos, akiknek a felhasználói előre kiszámíthatatlan formátumú fájlokat töltenek fel, például DOCX-szerződéseket, régi XLS-exportokat, bemutatókat vagy EPUB-könyveket. A Firecrawl célja, hogy ezekből egységes Markdown-kimenetet adjon, miközben a PDF-eknél csak a ténylegesen szükséges oldalakat irányítja OCR-re.