A Fireworks AI szerint egy kávé árából domainre szabható embeddingmodell
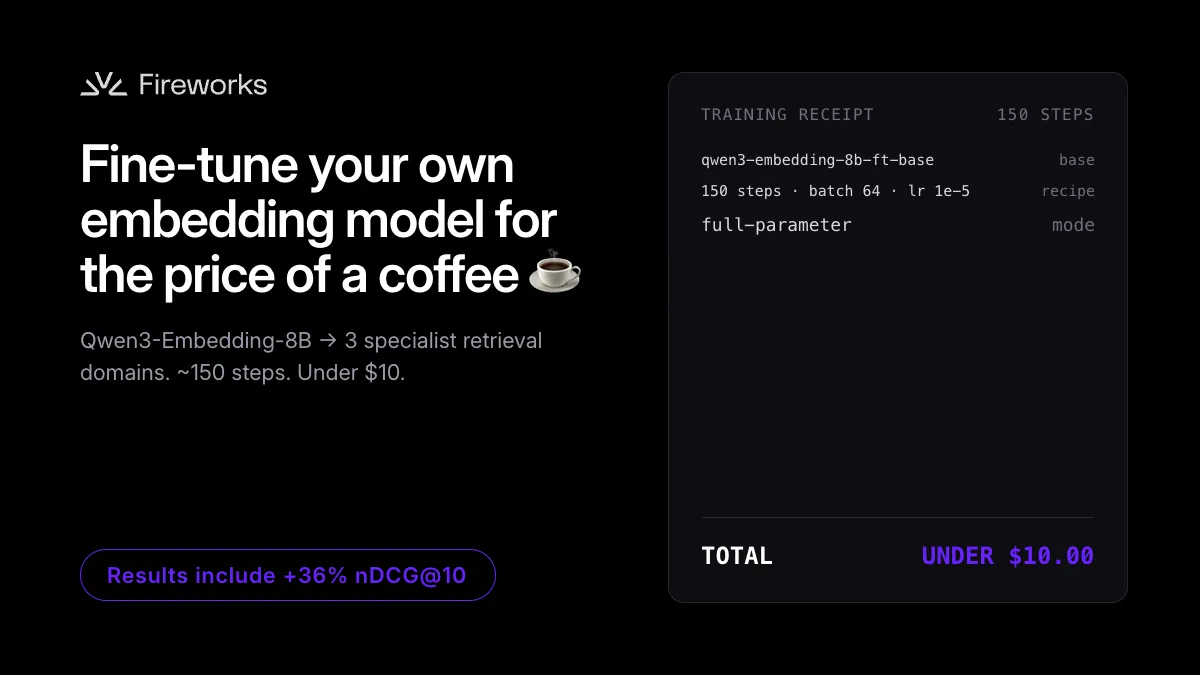
A Fireworks AI bemutatott egy módszert, amellyel a Qwen3-Embedding-8B általános célú embeddingmodell speciális területekre szabható 10 dollár alatti költséggel. A cég szerint már egy rövid, kontrasztív finomhangolás is jelentősen javíthatja a keresési eredményeket.
- A Fireworks AI a Qwen3-Embedding-8B domainre szabását mutatta be.
- A módszer 10 dollár alatti költséggel készült.
- A jogi feladaton az nDCG@10 36 százalékkal javult a cég szerint.
- A tanítás 150 lépést, 64-es kötegméretet és 1e-5 tanulási rátát használt.
- A tesztek jogi és klinikai visszakeresési feladatokra terjedtek ki.
Az általános modell domainre szabása
A szöveges embeddingmodellek egyetlen vektorba alakítják a szöveget. A hasonló jelentésű szövegek így közel kerülhetnek egymáshoz, a különbözők pedig távolabb helyezkedhetnek el. Ez az alapja többek között a visszakereséssel támogatott szöveggenerálásnak, a szemantikus keresésnek, az újrarangsorolásnak, az ajánlórendszereknek, a szándékfelismerésnek, a duplikátumok kiszűrésének és a klaszterezésnek.
A Fireworks AI szerint egy általános célú embeddingmodell jól kezeli a hétköznapi szövegeket, de gyengébb lehet olyan speciális jelentésviszonyok felismerésében, amelyek egy adott terület szakértőinek természetesek. Jogi példaként a cég azt említi, hogy az amerikai esetjogban a „36 So. 3d 84” és a „Reed v. State” ugyanarra a jogi autoritásra utalhat. A klinikai kutatásoknál pedig az számíthat, hogy egy páciens alkalmassági feltételei megfelelnek-e egy vizsgálat kritériumainak.
A vállalat három megközelítést hasonlít össze: kész embeddingmodell használatát, modell betanítását a nulláról, valamint egy előzetesen betanított, nagy nyelvi modellen alapuló embeddingmodell finomhangolását. A Fireworks AI szerint az utóbbi megőrzi az alapmodell általános nyelvi képességeit, miközben a vektortér a kiválasztott terület relevanciafogalmához igazítható.
Kontrasztív tanítás, költséges előképzés nélkül
A bemutatott eljárás lekérdezésből és a hozzá tartozó helyes dokumentumból álló párokat használ. Jogi feladatnál a lekérdezés egy olyan bírósági bekezdés, amelyből eltávolították a hivatkozást, a pozitív példa pedig az idézett ügy. Klinikai feladatnál a lekérdezés egy páciens összefoglalója, a pozitív példa pedig egy olyan klinikai vizsgálat, amelyre a páciens jogosult.
A tanítás során a modell a helyes párt közelebb húzza egymáshoz, a többi példát pedig távolítja. A Fireworks AI ezt úgy oldja meg, hogy egy kötegben minden másik dokumentum negatív példaként szolgál. Egy B párból álló kötegben így minden lekérdezéshez egy pozitív és B−1, külön kiválasztás nélkül rendelkezésre álló negatív dokumentum tartozik.
A módszer az úgynevezett InfoNCE veszteséget használja. A tanítás mindkét irányban történik, vagyis a lekérdezésnek a megfelelő dokumentumot, a dokumentumnak pedig a megfelelő lekérdezést kell kiválasztania. A vállalat a hőmérsékleti értéket 0,02-re állította be, a kétirányú veszteséget pedig átlagolta.
Jogi és klinikai teszteken mért javulás
A Fireworks AI két speciális visszakeresési feladaton vizsgálta a módszert. Az egyik a LegalBench jogi hivatkozás-visszakeresési feladata, a másik a TREC Clinical Trials klinikai vizsgálatokhoz kapcsolódó párosítási feladata volt. A cég a Qwen3-Embedding-8B alapváltozatát hasonlította össze ugyanennek a modellnek a finomhangolt változatával.
A jogi hivatkozás-visszakeresési feladaton az alapmodell nDCG@10 értéke 0,43 volt. A Fireworks AI szerint a rövid finomhangolás ezen a feladaton 36 százalékos javulást hozott az nDCG@10 mutatóban. A vállalat közlése szerint a többi vizsgált standard mérőszám, köztük az nDCG@10, a Recall@10, az MRR és a MAP@100 szintén jelentősen javult.
A kísérletekben teljes paraméteres frissítést alkalmaztak 150 lépésen keresztül, 64-es kötegmérettel, 1e-5 tanulási rátával és 0,02-es hőmérséklettel. A hosszú kontextusú, ügytől ügyig végzett futtatásnál 8-as kötegméretet használtak, mert csak nyolc, egyenként 16 ezer tokenes sorozat fért el. Az értékelés olyan lekérdezéseken történt, amelyeket a modell a tanítás során nem látott, a méréshez pedig a pytrec_eval könyvtárat használták.
Mit jelenthet ez a felhasználóknak?
A Fireworks AI bemutatója alapján a módszer azoknak a csapatoknak lehet érdekes, amelyek kész embeddingmodellt használnak, de a saját dokumentumaik közötti relevanciát pontosabban szeretnék modellezni. A cég szerint egy hasznos futtatás nagyjából 150 optimalizálási lépést igényel, és percek alatt elvégezhető a Fireworks platformján, 10 dollár alatti költséggel.
A megközelítés előnye a forrás szerint, hogy a fejlesztőknek nem kell embeddingmodellt a nulláról betanítaniuk. A Fireworks AI úgy látja, a finomhangolás a meglévő nyelvi és általánosítási képességekre épít, miközben a modell megtanulja az adott terület sajátos relevanciaviszonyait. A cég ugyanakkor jelzi, hogy a fejlettebb negatívpélda-válogatás és a kötegek közötti negatív példák további javulást hozhatnak, ezek vizsgálatát egy későbbi bejegyzésre hagyja.
Fireworks AI: Fine-Tune Your Own Embedding Model from an LLM — for the Price of a Coffee