Új előrejelzési módszer csökkentheti a tanítás költségét
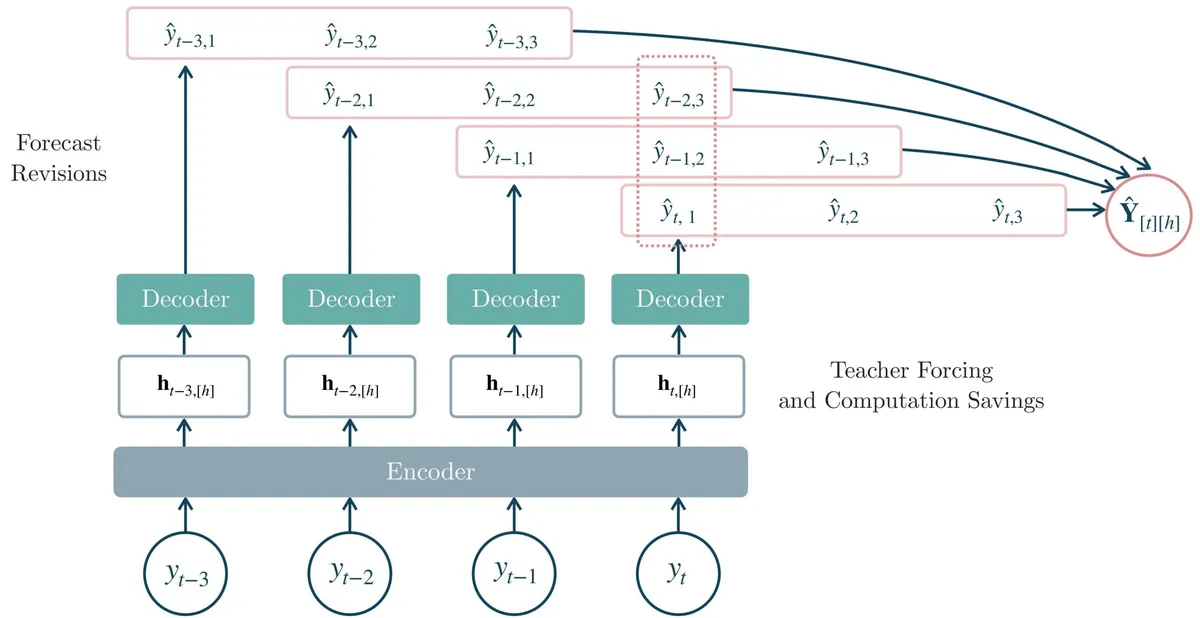
A forking-sequences nevű tanítási módszer egyetlen előrehaladási lépésben dolgozza fel az idősor teljes előrejelzési szerkezetét. A Carnegie Mellon University kutatói szerint az eljárás jobb gradiensjeleket, gyorsabb tanítást és nagyságrenddel olcsóbb következtetést tehet lehetővé.
- A forking-sequences egyetlen előrehaladási lépésben dolgozza fel az idősor összes előrejelzési időpontját.
- A módszert MLP, RNN, LSTM, CNN, Transformer és State Space kódolókkal is vizsgálták.
- A forrás szerint az LSTM kódolóknál a sCRPS javulása elérte a 49,3 százalékot.
- A keresztvalidáció számítási összetettsége LSTM, RNN és CNN esetén O(T²) értékről O(T) értékre csökkenhet.
- A módszert ipari MQForecaster modellek, köztük az MQCNN, az MQT és a SPADE tervezésénél is felhasználták.
Egyetlen ablak helyett a teljes idősor
A CMU Machine Learning Blog 2026. augusztus 10-i bejegyzése a Forking-Sequences módszert mutatja be. Az írás alapjául szolgáló tanulmány a Transactions on Machine Learning Research folyóiratban jelent meg 2026-ban, Potosnak, Wolff, Cao, Ma, Konstantinova, Efimov, Mahoney, Oreshkin és Olivares munkájaként.
A több időhorizontú előrejelzés olyan alkalmazásokban vált alapértelmezett megközelítéssé, mint az energiaipar, a pénzügy, az ellátási láncok és az egészségügy. Ezekben a felhasználóknak gyakran teljes jövőbeli pályákra van szükségük, hogy rövid, közép- és hosszú távú terveket készíthessenek.
A hagyományos, úgynevezett window-sampling megoldás egy rögzített hosszúságú múltbeli ablakból készít előrejelzést, majd ezt külön megismétli minden előrejelzési időpontnál. A forking-sequences ezzel szemben egyetlen előrehaladási lépésben kódolja és dekódolja a teljes idősor előrejelzési időpontjait. A kódoló minden időponthoz rejtett reprezentációt készít, egy közös dekódoló pedig ezekből állítja elő a több időhorizontú előrejelzéseket.
Kevesebb zaj a gradiensben
A kutatók szerint a módszer egyik fontos előnye a statisztikai hatékonyság javulása. A forking-sequences az idősor összes előrejelzési időpontjából származó veszteségeket egyszerre használja fel a gradiens kiszámításához. Így egyetlen idősorból átfedő, több időhorizontú tanítási célok teljes készletét nyeri ki, elhanyagolható többletköltség mellett.
A tanulmány elméleti eredménye szerint, ha az időpontokhoz tartozó gradiensminták csak korlátozott mértékben függnek egymástól, a gradiensbecslő varianciája a minták számának növekedésével O(1/T) ütemben csökken, a jel-zaj arány pedig O(T) ütemben nő. A szerzők ezt simább optimalizációval és gyorsabb konvergenciával kapcsolják össze.
Az eljárás különösen a visszatérő hálózatoknál lehet hasznos. Az RNN és LSTM modelleknél a veszteség minden előrejelzési időpontban képződik, ezért a korai időlépésekből származó gradiensek kevésbé tűnnek el a visszaterjesztés során. A bejegyzés szerint az LSTM kódolókkal végzett kísérletekben a sCRPS javulása elérte a 49,3 százalékot.
A módszert hat kódolótípussal validálták: MLP, RNN, LSTM, CNN, Transformer és State Space. A CMU bejegyzése szerint a forking-sequences mindegyik esetben javította a validációs kvantilis veszteségét.
Olcsóbb lehet a gördülő előrejelzés
A számítási előny főként akkor jelentkezik, amikor a modellnek sok egymást követő előrejelzési időpontból kell becslést készítenie, például keresztvalidációs eljárásban. A window-sampling minden egyes időpontnál a nulláról számolja újra a kódolót, noha a szomszédos ablakok nagy része átfed.
A forking-sequences egyszer kódolja a teljes idősor adatait, majd a rejtett állapotokat továbbítja a következő előrejelzési időpontok felé. A forrás szerint ez minden kódolótípusnál T tényezővel csökkenti a keresztvalidáció számítási összetettségét. LSTM, RNN és CNN esetén a komplexitás O(T²) értékről O(T) értékre csökkenhet.
A módszer már hatással volt az ipari alkalmazásokhoz készült MQForecaster neurális hálózatok tervezésére. A bejegyzés példaként az MQCNN, az MQT és a SPADE rendszereket említi. A szerzők szerint a forking-sequences korábban is felbukkanó ötletekhez kapcsolódik, de eddig nem definiálták formálisan, nem támasztották alá elméletileg, és nem vizsgálták szisztematikus összehasonlításban.
A CMU bejegyzése a módszer statisztikai és számítási előnyeire koncentrál. A sorozat második része a társított előnyt, az együttes előrejelzésből származó csökkentett volatilitást tárgyalja majd. A forrás külön jelzi, hogy a hivatkozott kódimplementációt nem használták a tanulmányban, és az nem áll kapcsolatban az Amazonnal.
CMU Machine Learning Blog: Forking-Sequences — Part I: Statistically and Computationally Efficient Multi-Horizon Forecasting