A világ modellezésétől az aktív robotokig lépne a fizikai AI
A fizikai környezetben működő mesterséges intelligenciának az élethű világmodellezés mellett azt is tudnia kell, mikor van szüksége új információra, hogyan tervezzen, és miként alkalmazkodjon tettei következményeihez. A Lambda által támogatott CVPR 2026-os workshop kutatásai ezt az átmenetet vizsgálták.
- A fizikai AI-nak az előrejelzés mellett érzékelnie, terveznie és alkalmazkodnia is kell.
- A RoboWM-Bench szerint a vizuálisan hihető videók nem feltétlenül vezetnek sikeres robotcselekvéshez.
- A GEM-4D szerzői 61 százalékról 81 százalékra javuló manipulációs sikerről számoltak be.
- A SAW-Bench legjobb modellje 37,66 százalékos lemaradást mutatott az emberekhez képest.
- Az aktív érzékelés az információgyűjtést is a döntéshozatal részévé teszi.
A valósághű videó még nem jelent használható robotviselkedést
A generatív mesterséges intelligencia egyre élethűbb képeket és videókat készít, a világmodellek pedig már a geometria, a mozgás és az interakciók megragadására törekednek. A Lambda szerint azonban a világ generálása önmagában nem azonos a világban való cselekvéssel.
Egy fizikai környezetben működő rendszernek fel kell ismernie, mit nem tud, meg kell határoznia, milyen információt gyűjtsön, az aktuális ismeretei alapján kell cselekednie, majd a következményeket megfigyelve folyamatosan módosítania kell a tervét.
Ezt a problémát szemlélteti a RoboWM-Bench, amely videó-világmodelleket nemcsak a generált videók alapján vizsgál, hanem a manipulációs viselkedéseket megtestesített cselekvéssorokká alakítja, majd ellenőrzi, hogy ezekkel elvégezhetők-e a feladatok. A forrás szerint a vizuálisan hihető videók is vezethetnek sikertelen végrehajtáshoz térbeli következtetési hibák, bizonytalan érintkezési előrejelzések vagy fizikailag következetlen deformációk miatt.
A geometria és a bizonytalanság is számít
A fizikai AI-nak olyan reprezentációkra van szüksége, amelyek a cselekvés szempontjából fontos tulajdonságokat őrzik meg. Ilyen a geometria, a tárgyak közötti kapcsolat, a dinamika, a bizonytalanság és a fizikai korlátok.
A GEM-4D ezt a modellezés oldaláról közelítette meg. A kutatás sűrű, négydimenziós megfeleltetési felügyeletet épít videó-világmodellbe, hogy a generált képkockák között geometriai következetességet tartson fenn. Egy inverz dinamika rendszer ezután a generált lefutásokból végrehajtható, hat szabadságfokú robotpályákat készít.
A szerzők beszámolója szerint a geometriai alapokra építő megközelítés 61 százalékról 81 százalékra javította a valós manipulációs feladatok sikerét. A Lambda ezt a RoboWM-Bench eredményeivel együtt egy közös kihívás két oldalának tekinti: meg kell állapítani, hogy egy elképzelt jövő fizikailag végrehajtható-e, és olyan jövőket kell generálni, amelyek geometriailag megalapozottak.
Az intelligens rendszer azt is eldönti, mit érzékeljen
A fizikai környezet megértése az ügynök saját helyzetének felismerését is megköveteli. A SAW-Bench 786 valós, nézőpont-alapú videót és 2071, emberek által címkézett kérdést tartalmaz hat, helyzethez kötött tudatossági feladatban. A forrás szerint 24 vizsgált modell esetében a legjobb teljesítményű modell és az emberek eredménye között 37,66 százalékos különbség volt.
Az elemzés alapján a modellek részleges geometriai jeleket fel tudnak használni, mégis nehézséget okoz számukra koherens, a megfigyelő nézőpontjához kötött geometria felépítése. Egy robotnak ugyanis ahhoz kell viszonyítania a világot, hogy hol helyezkedik el, hogyan mozog, és milyen cselekvések állnak előtte.
Az aktív érzékelés ezt a folyamatot a döntéshozatal részévé teszi. Ha egy robot csak részben lát egy tárgyat, megváltoztathatja a kamera nézőpontját, másik oldalról vizsgálhatja meg, vagy eldöntheti, hogy a tapintási információ hasznosabb lenne egy újabb vizuális megfigyelésnél. Így az ügynök nemcsak azt kérdezi, mit ért meg abból, amit lát, hanem azt is, mit kellene következőként megfigyelnie.
A generatív modellek bekerülnek a cselekvési körbe
A workshop, a World Models Meet Active Sensing and Closed-Loop Planning, a CVPR 2026 részeként zajlott. A Lambda társszervezőként és támogatóként vett részt benne. Az eseményen Nicholas Roy, Alan Yuille, Yiannis Aloimonos és Chelsea Finn tartott előadást, emellett 20 elfogadott tanulmány foglalkozott világmodellekkel, aktív érzékeléssel, robotikai szabályozással, többmodalitású vezérléssel és értékeléssel.
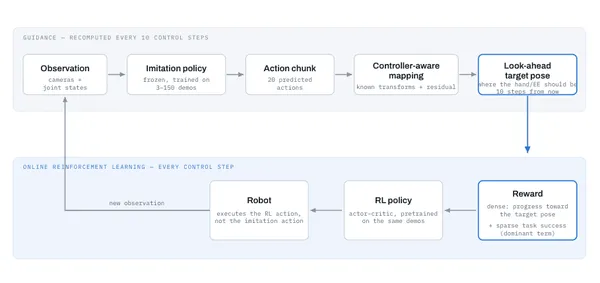
A bemutatott irányok egy folyamatos ciklust rajzolnak ki: érzékelés, megértés, előrejelzés, tervezés, cselekvés, majd ismételt érzékelés. A világmodell lehetséges jövőket képzelhet el, az aktív érzékelés kiválaszthatja a következő szükséges információt, a szabályozási rendszer pedig műveletet választhat. Az eredmény új megfigyelésként kerül vissza a körbe.
A Lambda szerint a világmodellek, az aktív érzékelés és a zárt hurkú tervezés együtt olyan rendszerek felé mutat, amelyek nemcsak modellezik a fizikai világot, hanem képesek feltárni, értelmezni és befolyásolni is azt. A műhely kutatásai alapján a generált jövő egyre inkább köztes reprezentációvá válhat, amely segíti az ügynököt a lehetséges következmények mérlegelésében és a következő lépés kiválasztásában.