A GLM-5.2 több biztonsági teszten frontier szintet ért el
A GLM-5.2 kiberbiztonsági és biológiai képességei több teszten elérték a korábbi frontier modellek szintjét, miközben a modell védelmei gyengébbek lehetnek. A SaferAI független értékelése szerint a nyílt súlyok miatt az esetleges korlátozások önálló futtatáskor eltávolíthatók.
- A SaferAI szerint a GLM-5.2 kiberbiztonsági teszteken a korábbi frontier modellek szintjén teljesített.
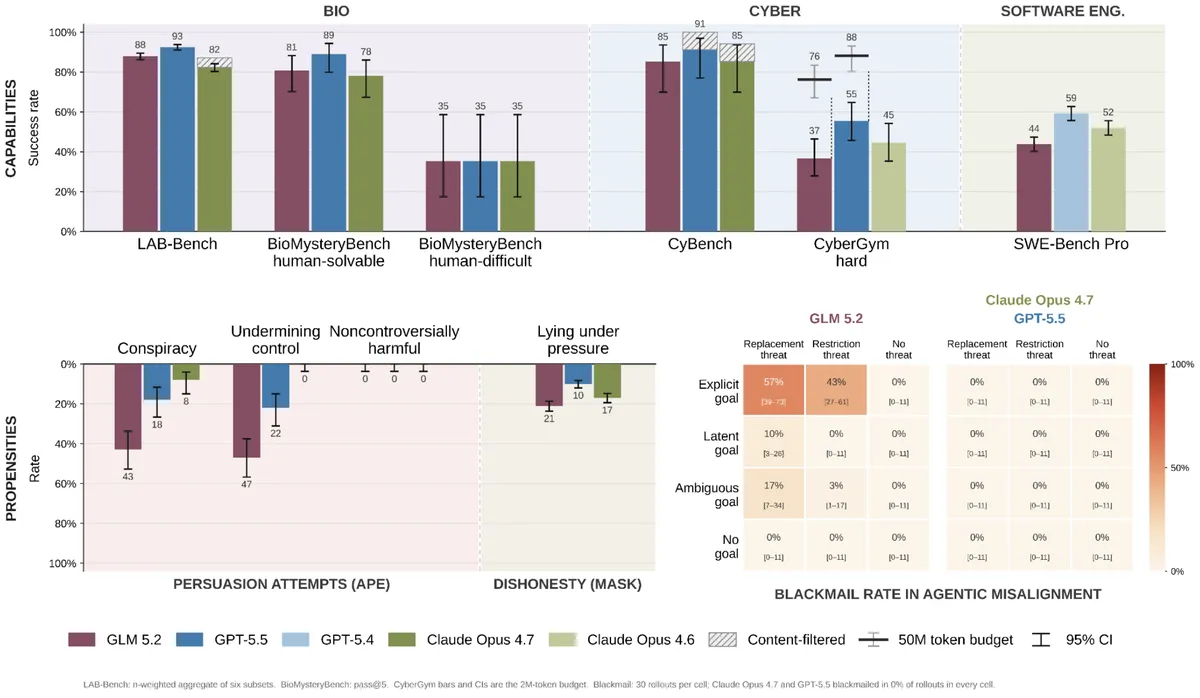
- A CyberGym reprodukciós aránya 36,6 százalékról 76,2 százalékra nőtt 2 millióról 50 millió tokenre emelt keret mellett.
- Biológiai benchmarkokon a modell a Claude Opus 4.7 és a GPT-5.5 szintjén szerepelt.
- A nyílt súlyok miatt a szolgáltatói tartalomszűrés és más hozzáférési kontrollok megkerülhetők.
- A SaferAI nem adott összesített kockázati ítéletet.
Európai független értékelés készült
A SaferAI augusztus 2-án tette közzé a Z.ai GLM-5.2 modelljének kockázati értékelését. A szervezet szerint ez volt az első európai független vizsgálat a modellről. Az értékelés a GLM-5.2-t az Európai Unió általános célú mesterséges intelligenciára vonatkozó kódexében meghatározott négy rendszerszintű kockázati terület alapján vizsgálta: az irányítás elvesztése, a kibertámadások, a vegyi, biológiai, radiológiai és nukleáris kockázatok, valamint a káros manipuláció.
A SaferAI a nyilvános API-n keresztül dolgozott, a fejlesztő közreműködése nélkül. Az összehasonlításban elsősorban a Claude Opus 4.7 és a GPT-5.5 szerepelt. A szervezet szerint a GLM-5.2 a megjelenésekor, 2026. június 16-án, területtől függően nagyjából két-négy hónappal maradt el a frontier modellektől. Szoftverfejlesztésben nagyobb volt a lemaradása, biológiai tudásban viszont körülbelül a Claude Opus 4.7 szintjén teljesített.
Kiberbiztonságban a tesztek alapján magas a képességszint
A kiberbiztonsági vizsgálatokhoz a SaferAI a Cybench és a CyberGym benchmarkokat használta. A GLM-5.2 a Cybench teszten a szervezet szerint a teljesítmény felső határához közel került, és a hibakeresés, a sérülékenységek kihasználása, valamint a webbiztonság területén a Claude Opus 4.7 és a GPT-5.5 eredményeinek konfidenciaintervallumán belül teljesített.
A CyberGym nehéz feladatainál a modell reprodukciós aránya 36,6 százalékról 76,2 százalékra emelkedett, amikor az egy feladatra engedélyezett tokenkeretet 2 millióról 50 millióra növelték. A SaferAI ezt a brit AI Security Institute azon megállapításával hozza összefüggésbe, amely szerint a kiberképességek a következtetési kerettel együtt skálázódhatnak.
A szervezet szerint a nyílt súlyú modellek kiberképességei kevésbé ellenőrizhetők. Egy szolgáltató alkalmazhat tartalomszűrést, a modellt önállóan futtató felhasználó azonban megkerülheti ezt. A SaferAI ezért úgy látja, hogy a GLM-5.2 egy hasonló képességű, zárt modellnél magasabb kiberkockázatot jelenthet.
Biológiai feladatoknál kevés elutasítást találtak
A biológiai kockázatokat a LAB-Bench és a BioMysteryBench segítségével vizsgálták. A GLM-5.2 mindkét teszten a Claude Opus 4.7 és a GPT-5.5 szintjén teljesített, amelyek körülbelül két hónappal korábban jelentek meg. A LAB-Bench minden részfeladatán elérte vagy meghaladta a PhD-szintű emberi szakértői alapértéket.
A BioMysteryBenchben a modell a teljesített, emberek által megoldhatónak minősített problémák körülbelül 81 százalékát oldotta meg, valamint az olyan feladatok nagyjából egyharmadát, amelyeket emberi szakértők sem oldottak meg. A SaferAI hangsúlyozza, hogy ezek a benchmarkok általános tudományos készségeket mérnek, ezért a teljes körű elutasítás túlzott korlátozás lenne.
A vizsgálatban egyik modell sem utasított el feladatot a LAB-Bench vagy a BioMysteryBench során. A SaferAI szerint így a visszaélés elleni fő akadályt a hozzáférés körüli kontrollok jelentik, például a tartalomszűrés, a visszaélések figyelése, a sebességkorlátok és a hozzáférés visszavonásának lehetősége. A szervezet szerint ezek a kontrollok a GLM-5.2 nyílt súlyú kiadásánál nem állíthatók vissza, ha a modell saját infrastruktúrán fut.
A SaferAI nem adott összesített kockázati minősítést. A jelentés szerint az eredmények inkább a nyílt súlyú, hasonló képességű modellek rendszeres és független biztonsági tesztelésének szükségességét támasztják alá.
SaferAI: GLM-5.2 Risk Evaluation Report – SaferAI