A Google új rendszerrel teszi ellenőrizhetőbbé a szövetségi tanulás védelmét
A Google Research új, Trusted Execution Environmentekre épülő szövetségi tanulási rendszert jelentett be. A megoldás külső felek számára is ellenőrizhető adatvédelmi garanciákat kínál, miközben a számításokat a szerverre helyezi át.
- A Google TEE-alapú szövetségi tanulási rendszert jelentett be.
- A hozzáférési szabályzatokat a Rekor nyilvános átláthatósági naplójában teszik közzé.
- A Gboard angol és japán következőszó-jósló modelleknél használja a rendszert.
- A Google szerint a szerveroldali párhuzamosítás gyorsabb modelltréninget tesz lehetővé.
- A megoldás Pythonban kifejezhető, más munkaterheléseket is futtathat.
A szerverre kerül a számítás nagy része
A Google október 2-án ismertetett rendszere a federated learning, vagyis a szövetségi tanulás új változata. Ennél a gépi tanulási módszernél több kliens, például eszközök működik együtt egy modell betanításában úgy, hogy az adatok decentralizáltan, az adott eszközökön maradnak.
A technológiát a Google szerint már olyan funkciók támogatására használták, mint a Gboard következőszó-jóslása és Smart Compose funkciója, a Google Messages válaszjavaslatai, valamint az Android Smart Text Selection megoldása. Az új rendszerben a klienseszközök helyben titkosítják a tanítási példákat, majd feltöltik azokat. A tényleges adatfeldolgozás és a modell tanítása szerveroldalon, védett végrehajtási környezetekben történik.
A vállalat szerint ezzel csökkenthetők a korábbi rendszerek eszközoldali számítási kapacitásából, elérhetőségéből és a párhuzamos munkaterhelésekből eredő korlátok. A Google korábbi tapasztalata alapján egyes FL-modellek betanítása 1, illetve 2 hónapig is tarthatott. Az új rendszerben a párhuzamosítás miatt a tréning jelentősen felgyorsulhat, a sebességet jelenleg a TEE-erőforrások elérhetősége korlátozza.
A TEE-k és a nyilvános napló együtt ellenőrizhetővé teszi a folyamatot
A Trusted Execution Environment, röviden TEE, olyan védett környezet, amelyben a futó logika távolról hitelesíthető. A Google leírása szerint a külső felek ellenőrizhetik, milyen program fut, miközben a környezet belső állapota nem figyelhető meg, és a benne futó logika nem módosítható, a jelenlegi TEE-korlátok figyelembevételével.
Az eszközök előre meghatározzák, milyen hozzáférési szabályzatok engedélyezik az adataik feldolgozását. Ezeket a szabályzatokat a Rekor nyilvános átláthatósági naplójában teszik közzé. Így a kliensek és a külső auditorok láthatják, milyen szerveroldali munkaterhelések férhetnek hozzá a feltöltött adatokhoz.
A kulcskezelő rendszer több TEE-ből álló fürtként működik, és csak azoknak a szerveroldali feladatoknak ad visszafejtési kulcsot, amelyek megfelelnek a szabályzatban rögzített számításoknak. A feldolgozást végző TEE Python-programot futtat, amely a tanítási ciklust valósítja meg, a párhuzamosítható részfeladatokat pedig további TEE-khez delegálja. A rendszer időszakosan anonimizált modellparamétereket ad át az adatelemzőnek.
A Google szerint az operátorok csak mérőszámokat és differenciálisan privát modellparamétereket látnak. A feltöltött, titkosított tanítási adatok kizárólag a hozzáférési szabályzatban meghatározott Python-programokat futtató TEE-kben fejthetők vissza és dolgozhatók fel, ráadásul csak korlátozott ideig.
A Gboard már angol és japán modelleknél használja
A Gboard már bevezette az új rendszert angol és japán következőszó-jósló modellek betanítására. A Google szerint a megoldás erősebb adatvédelmi garanciákat és jobb pontosságot tesz lehetővé.
Az egyik változás, hogy a rendszer előbb összegyűjti az eszközökről érkező feltöltéseket, és csak ezután indítja el a szerveroldali tanítást. Így a napi ingadozások az eszközök elérhetőségében kevésbé befolyásolják a folyamatot. A szerveroldali program dinamikusan számíthatja ki az optimális eszközrészvételi ütemezést, amelyhez más adatvédelmi paramétereket is igazíthat.
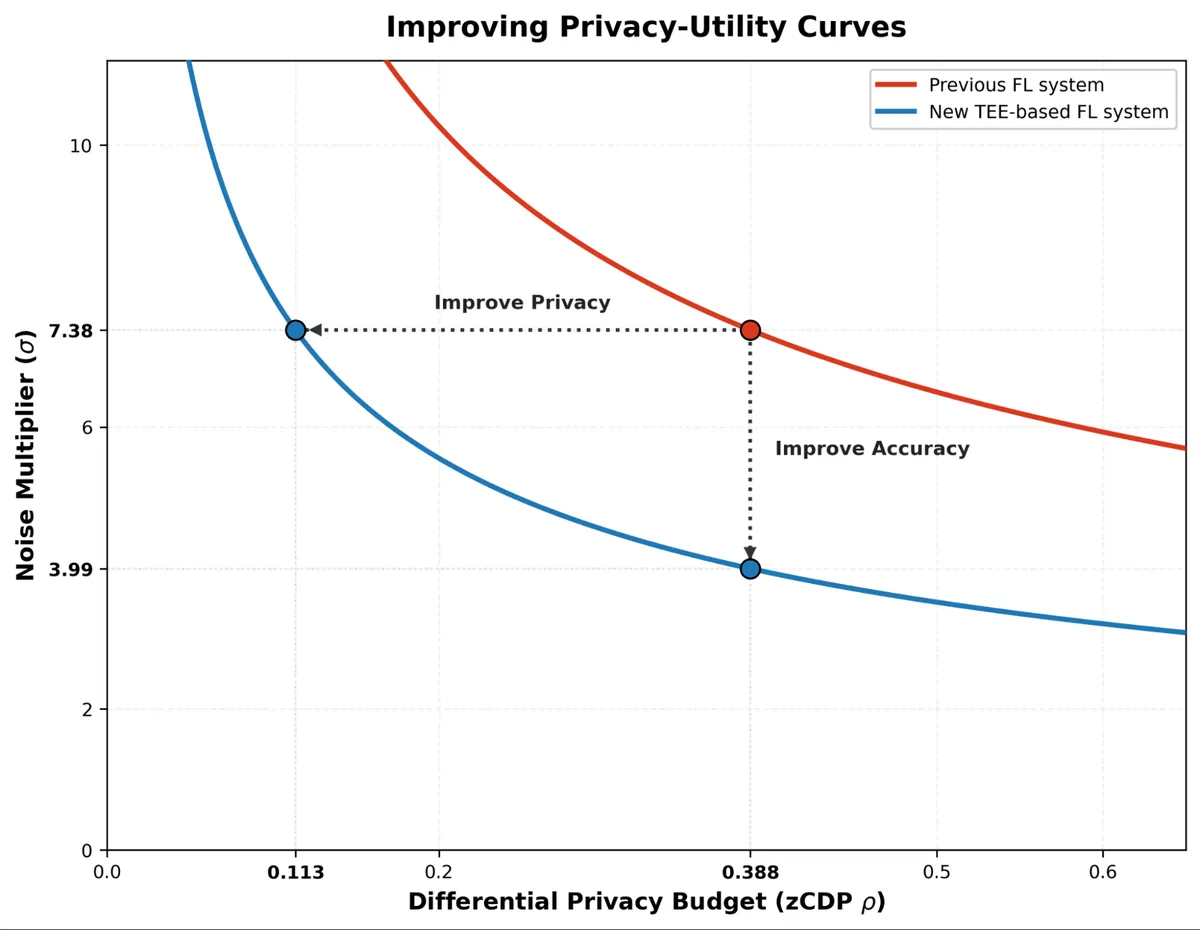
A Google egy angol következőszó-jósló modellnél 5000 tanítási fordulót vizsgált, fordulónként 6500 eszközből álló csoportokkal. A vállalat szerint az új rendszerrel erősebb adatvédelem, illetve kisebb zajszorzók válhatnak elérhetővé.
A KMS és az adatfeldolgozó binárisok nyílt forráskódból reprodukálhatóan építhetők a Confidential Federated Compute GitHub-adattárban közzétett kód alapján. A Google szerint az infrastruktúra később nagyobb modellek FL-alapú tanítását is támogathatja, különösen TEE-k és gyorsítók integrációjával. A rendszer Pythonban kifejezhető, más típusú munkaterhelések, például szintetikusadat-generálás futtatására is alkalmas.
Google Research: Toward provably private learning from federated data