Google-kutatás: matematikailag magyarázható a diffúziós modellek kreativitása
A diffúziós modellek azért képesek a tanítóadatoktól eltérő, mégis valószerű képeket és más adatokat létrehozni, mert a neurális hálózatok a tanult pontszámfüggvény egy simított változatát sajátítják el. A Google Research matematikai elemzése szerint ez az úgynevezett score smoothing, vagyis pontszámfüggvény-simítás, az adatok közötti interpolációhoz vezet.
- A diffúziós modellek kreativitása a Google Research szerint matematikailag magyarázható.
- A neurális hálózatok a pontszámfüggvény simított változatát tanulják meg.
- A simítás a tanítóadatok közötti interpolációhoz vezet.
- Többdimenziós adatoknál a folyamat segíti a rejtett adatsokaság feltárását.
- A kutatás az ICLR 2026 konferencián bemutatott tanulmányra épül.
A zajból fokozatosan lesz értelmes adat
A diffúziós modellek tanítása során valódi adatokat, például macskafotókat, zajjal rontanak el addig, amíg azok felismerhetetlenné válnak. A modellnek ezután lépésről lépésre meg kell tanulnia visszafordítani ezt a folyamatot, hogy tiszta zajból valószerű képet állítson elő. Ezt a folyamatot zajtalanításnak nevezik.
Ha a modell tökéletesen tanulná meg a zajtalanítást, kizárólag a tanítóadatokból kiindulva, azok pontos másolatait állítaná elő. Ez memorizálás lenne, amelyben a rendszer inkább visszakereső eszközként működne. A gyakorlatban a diffúziós modellek ennél többre képesek, és új adatminta létrehozásával általánosítanak.
A zajtalanítást a Google Research egy erőtérhez hasonlítja. Ebben az egyes adatpontok a zajból indulnak, a score function, vagyis pontszámfüggvény pedig megadja, hogy az adott pillanatban merre kell továbbhaladniuk.
A simítás új adatpontokat hoz létre
A kutatás szerint a modellek kreativitása abból fakad, hogy a neurális hálózatok jellemzően nem tanulják meg tökéletes pontossággal a pontszámfüggvényt. A regularizáció, vagyis a tanulást korlátozó eljárások hatására a hálózat a függvény éles változásait kisimítja. A Google ezt score smoothingnak nevezi.
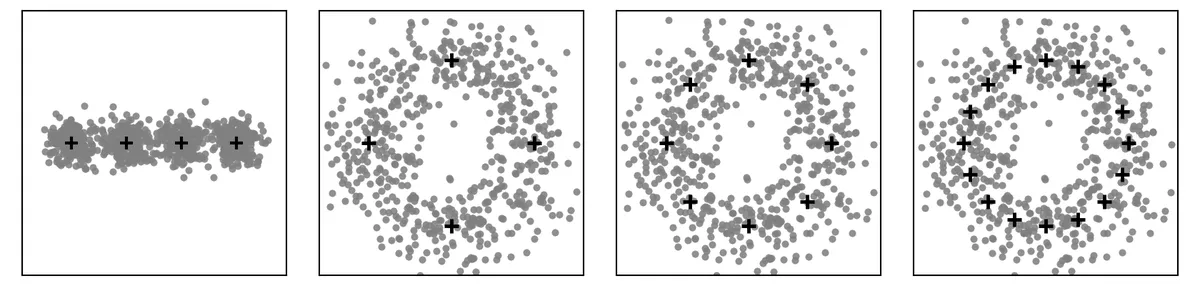
A kutatók egy egydimenziós példán mutatták be a jelenséget, amelyben mindössze két tanítóadat szerepelt, a +1 és a -1 pont. A tökéletes pontszámfüggvény a zajból érkező adatokat végül valamelyik eredeti pontra húzná, így memorizálás történne. A simított függvény viszont lassítja az adatpontok mozgását a két pont közötti térségben. Emiatt egyes pontok az úgynevezett interpolációs zónában, a tanítóadatok közötti tartományban nyugszanak meg.
A kutatók két rétegű, ReLU-alapú neurális hálózatokat tanítottak a pontszámfüggvény közelítésére. A paramétereket az AdamW algoritmussal optimalizálták, különböző súlycsökkentési, weight decay értékek mellett. Az eredmény szerint az erősebb súlycsökkentés simább függvényt eredményezett a középső tartományban. A tanulmány azt is megállapítja, hogy hasonló simítás explicit súlycsökkentés nélkül, a gradiensalapú tanítás implicit regularizációja miatt is kialakulhat.
A folyamat a rejtett adatsokaság feltárását segíti
A nagy felbontású képek és más összetett adatok magas dimenziószámú pixelterekben helyezkednek el. Ezeknek a tereknek a nagy része az ember számára értelmetlen véletlen zaj, a felismerhető képek viszont egy kisebb, rejtett adatsokaságon, az úgynevezett data manifoldon találhatók.
A Google Research szerint a képgenerálás egyik feladata ennek a rejtett sokaságnak a helyreállítása. A modellnek a véges számú tanítóadat alapján kell következtetnie annak alakjára, majd új pontokat kell létrehoznia rajta. Többdimenziós esetben a pontszámfüggvény simítása irányfüggően működik.
A sokasággal párhuzamos irányokban lassítja az adatpontok tanítóadatok felé történő összeomlását. A sokaság felé mutató irányokban viszont a tökéletes pontszámfüggvény eleve viszonylag sima, ezért a további simítás kevésbé változtat rajta. Így a folyamat nem áll meg a zajos, üres térben, és a modell egyszerre hozhat létre valószerű és új adatokat.
Miért fontos ez a generatív modellek számára?
A Google Research, a 2026. július 15-én közzétett bejegyzésben, az ICLR 2026 konferencián bemutatott tanulmányra hivatkozva azt állítja, hogy a diffúziós modellek kreativitása kiszámítható matematikai következmény lehet. A kutatás szerint a neurális hálózatok tökéletlen, simított függvényeket tanulnak, ezek pedig hidat képeznek az ismert adatok között.
A szerzők szerint ez segít megmagyarázni, miként tudnak a diffúziós modellek képgenerálásban és molekulafelfedezésben új, valószerű mintákat létrehozni a tanítóadatok egyszerű megjegyzése helyett. A Google Research következtetése szerint a mechanizmus az adatok minősége és az újdonság közötti egyensúly kialakításában játszik szerepet.
Google Research: Towards demystifying the creativity of diffusion models