A Google szerint a csúcsmodellek sok tényt tárolnak, de nem mindig hívják elő
A Google Research 2026. augusztus 12-én bemutatott kutatása szerint a fejlett nagy nyelvi modellek ténybeli hibáinak jelentős része nem abból ered, hogy a modellek nem tárolták a tényt. A szerzők, Nitay Calderon és Gal Yona szerint a szűk keresztmetszet egyre inkább az előhívás.
- A Google Research a ténybeli hibákat kódolási és előhívási problémák szerint vizsgálja.
- A WikiProfile benchmark 2 150 Wikipedia-alapú tényt és tényenként tíz feladatot tartalmaz.
- A Gemini-3-Pro és a GPT-5 a tények 95-98%-át kódolja, de 26-34%-ukat nem hívja elő közvetlenül.
- Gondolkodással is 11-12% marad azon tények aránya, amelyeken ezek a modellek hibáznak.
- A kutatás szerint a ritka tények és a fordított kérdések főként előhívási nehézségeket mutatnak.
Mit vizsgál a Google Research új keretrendszere?
A Google Research blogján ismertetett munka, az Empty Shelves or Lost Keys? Recall Is the Bottleneck for Parametric Factuality arra a kérdésre keresi a választ, hogy amikor egy nagy nyelvi modell rosszul válaszol egy ténykérdésre, akkor a tény hiányzik-e a modellből, vagy a modell már kódolta, csak nem tudja megbízhatóan előhívni.
A kutatók szerint a hagyományos pontossági mutatók ezeket az eseteket egy kategóriába sorolják, pedig eltérő problémákról van szó. Ha a gond a kódolás hiánya, akkor a modellméret növelése vagy az adatok bővítése lehet fontos. Ha viszont az előhívás hibázik, akkor olyan utótanítási és futás közbeni módszerek is segíthetnek, amelyek a már tárolt tudás jobb használatát célozzák.
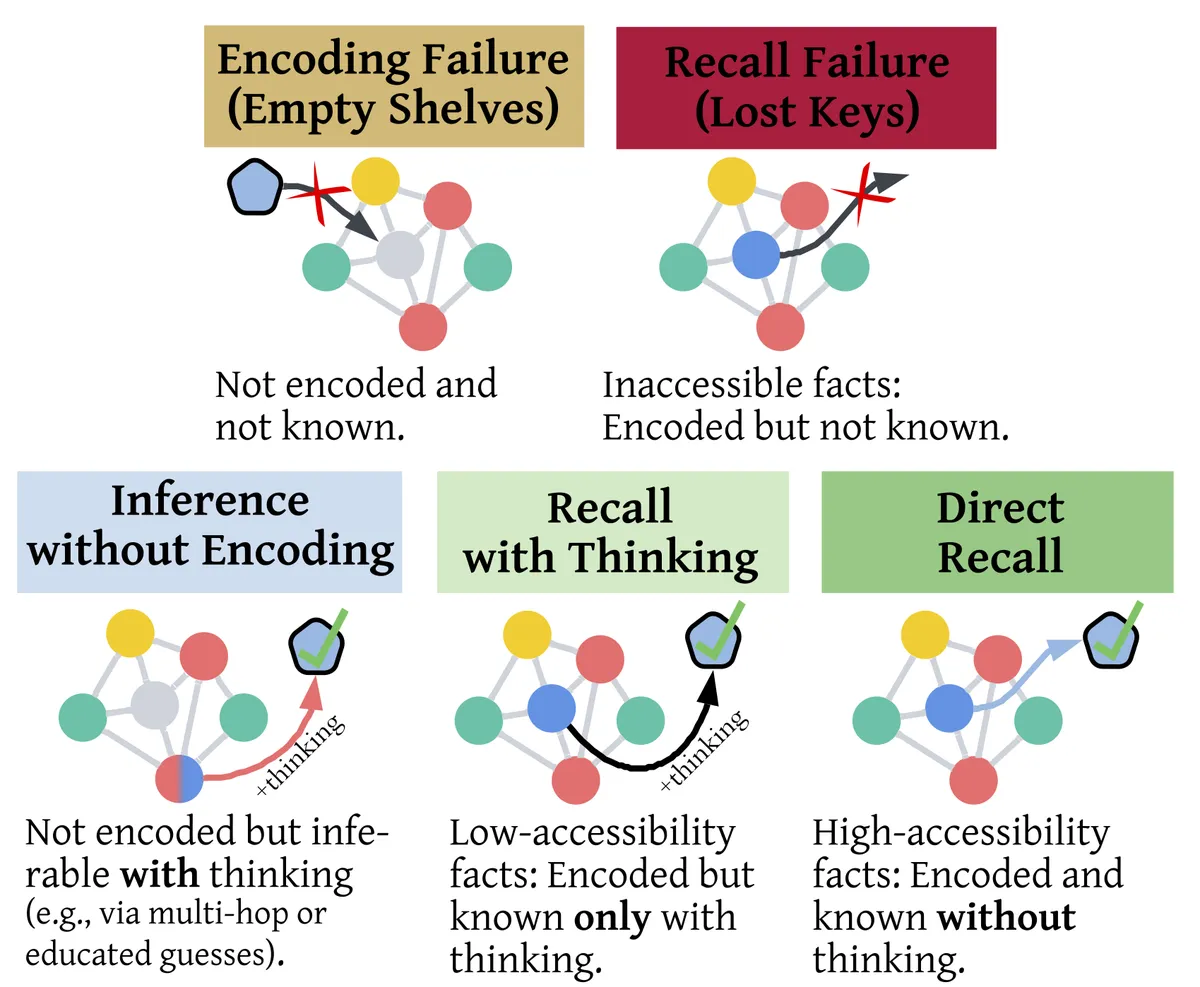
A Google Research ehhez egy knowledge profiling nevű viselkedési keretrendszert vezet be. A módszer nem egyes kérdések pontosságát nézi elsődlegesen, hanem azt, hogy egy adott tény milyen állapotban van a modellben. A szerzők öt profilt különböztetnek meg: kódolási hiba, előhívási hiba, közvetlen előhívás, előhívás gondolkodással, valamint következtetés kódolás nélkül.
A WikiProfile 2 150 Wikipedia-alapú tényen méri a tudást
A keretrendszer méréséhez a Google Research létrehozta a WikiProfile nevű benchmarkot, amely 2 150, Wikipediából származtatott tényt tartalmaz. Minden tényhez tíz feladat tartozik: kettő a kódolás mérésére, négy a tudás értékelésére, és négy feleletválasztós változat a felismerés vizsgálatára.
A benchmark teljesen automatizált folyamatban készült, amelyet egy promptolt LLM, a Gemini-2.5-Pro with thinking támogatott. A promptokat egy kis, elkülönített részhalmazon kézzel optimalizálták. A jelölt tényeket Wikipedia-oldalakból nyerték ki: a forrás meghatározása szerint ezek olyan állítások, amelyekben rendezett entitáspár szerepel, és az alany előbb jelenik meg a dokumentumban.
A direkt és fordított kérdéseket háromlépcsős folyamatban állították elő: generálás, finomítás és szűrés után csak olyan kérdések maradtak, amelyek egyértelműek, specifikusak, minimálisak, és egyetlen helyes válaszuk van. A kérdéseket keresőmotoron alapuló szűrésnek is alávetették, és elvetették azokat az eseteket, ahol több válasz jelent meg, vagy pontosításra lett volna szükség. Az automatizált szűrés után végső kézi validálás következett.
A Gemini-3-Pro és a GPT-5 sok tényt kódol, de nem mindet éri el
A kutatók 13 nagy nyelvi modellt értékeltek, mindegyiket gondolkodási móddal és anélkül is. Minden modell, tény és feladat esetében nyolc választ mintavételeztek. A válaszokat promptolt LLM-alapú automatikus értékelők osztályozták, így összesen körülbelül 4,5 millió válasz keletkezett.
A Google Research fő eredménye szerint a vizsgált csúcsmodelleknél, köztük a Gemini-2.5-Pro, a Gemini-3-Pro és Flash, valamint a GPT-5 esetében, a tények kódolása közel telített, az előhívás azonban nem az. A Gemini-3-Pro és a GPT-5 a tények 95-98%-át kódolja, mégis a tények 26-34%-át nem tudja közvetlenül előhívni. Gondolkodással is 11-12%-os hibaarány marad.
A szerzők ezt úgy értelmezik, hogy a fejlett modellek ténybeli hibái egyre kevésbé a hiányzó tudásból, inkább a tárolt, de nem megbízhatóan hozzáférhető tudásból erednek. A Google Research megfogalmazása szerint a szűk keresztmetszet a tudás megszerzéséről a tudás hasznosítására tolódik.
A skálázás vizsgálata ezt a képet erősíti. A Gemma 3 családban a nagyobb modellek jóval kevesebb kódolási hibát mutatnak, de az előhívási hibák továbbra is jelentősek, és a fennmaradó hibák nagyobb részét adják. A forrás szerint a skálázás jobban javítja azt, hogy mit tárol a modell, mint azt, hogy mihez fér hozzá.
Ritka tények és fordított kérdések mutatják az előhívás gyengeségeit
A Google Research eredményei szerint az előhívás erősen függ attól, milyen körülmények között tanulta meg a modell az adott tényt. Ha a kérdés eltér a tanulási kontextustól, a megfogalmazástól vagy a sorrendtől, amelyben a tény előfordulhatott, az előhívás nehezebbé válik.
Az egyik vizsgált eset a ritka, hosszú farokba tartozó tényeké. A forrás szerint korábbi munkák gyakran modellkapacitási problémaként keretezték, hogy az LLM-ek nehezen kezelik ezeket a tényeket. A Google Research eredményei kiegészítő képet adnak: az alacsony és magas népszerűségű tények összevetésekor a ritka tények kódolási aránya közel van a népszerű tényekéhez, miközben az előhívási különbség nagyobb. A kutatók az alsó 20%-ot és a felső 20%-ot hasonlították össze népszerűség szerint.
A másik eset a fordított kérdések problémája, amelyet a forrás a reversal curse néven említ. A modellek nyílt végű generálásban, vagyis előhíváskor, következetesen nehezebben válaszolnak fordított kérdésekre, mint direkt kérdésekre. Feleletválasztós ellenőrzésben, vagyis felismeréskor azonban a fordított kérdések nem nehezebbek a direkt kérdéseknél, és gyakran könnyebbek is.
Ez a különbség a kutatók szerint azért fontos, mert ha egy modell a helyes választ felismeri a zavaró válaszok között, de nem tudja előállítani fordított kérdésre, akkor a probléma nem egyszerűen az, hogy hiányzik a kétirányú tudás. A hiba inkább az előhívás módjához kapcsolódik.
Mit jelent ez a felhasználóknak és a fejlesztőknek?
A kutatás gyakorlati üzenete, hogy a ténybeli megbízhatóság értékeléséhez önmagában a kérdésszintű pontosság kevés lehet. Ugyanaz a rossz válasz jelenthet hiányzó tudást, nehezen hozzáférhető tudást vagy olyan esetet, amikor a modell más tényekből következtet.
A felhasználói szempontból ez azt jelenti, hogy egy fejlett modell hibája nem feltétlenül annak jele, hogy az adott tény nincs jelen a modell paramétereiben. A Google Research eredményei alapján a modell sok esetben tárolhatja a tényt, de a megfogalmazás, a kérdés iránya vagy a kontextus miatt mégsem adja vissza megbízhatóan.
A fejlesztők számára a cikk azt jelzi, hogy a következő javítási irányok között nemcsak a nagyobb modellek és a több adat szerepelhet, hanem az olyan utótanítási és futás közbeni módszerek is, amelyek a már kódolt tudás jobb előhívását segítik. A Google Research keretrendszere ehhez diagnosztikai eszközt kínál: megmutatja, hogy egy tény hiányzik-e, közvetlenül elérhető-e, csak gondolkodással hívható-e elő, vagy felismerhető, de nehezen generálható.
Google Research: Empty shelves or lost keys? Recall is the bottleneck for parametric factuality