A Google Science One Framework bizonyítékláncokkal ellenőrzi az AI-kutatást
A Google Research bemutatta a Science One Framework nevű kísérleti prototípust, amely minden kutatási állítást annak forrásához kapcsoló bizonyítéklánccal látna el. A rendszerhez tartozó CoE Audit az AI által készített tanulmányok hivatkozásait, kódját és eredményeit is ellenőrzi.
- A Science One Framework minden kutatási állítást bizonyítéklánccal köt össze.
- A CoE Audit négy szempontból ellenőrzi az AI által készített tanulmányokat.
- A vizsgált alapvonalaknál a kitalált hivatkozások aránya elérte a 21 százalékot.
- A Google szerint a Science One Framework egyik hivatkozása sem volt kitalált.
- A prototípus két ADRS-feladaton a legjobb összpontszámot érte el.
Az ellenőrizhetőség lett a központi probléma
A Google Research július 30-án ismertetett keretrendszere az önálló AI-kutatási rendszerek egyik fontos gyengeségére reagál. Ezek a rendszerek szakirodalmat dolgozhatnak fel, hipotéziseket fogalmazhatnak meg, kísérleteket futtathatnak és teljes kéziratokat írhatnak. A Google szerint azonban a szövegek látható minőségének javulásával egyre fontosabb kérdéssé vált, hogy az állítások ténylegesen ellenőrizhetők-e.
A jelenlegi kutatási folyamatokban egy korai hiba a későbbi lépésekben tovább erősödhet. Előfordulhatnak nem létező hivatkozások, eltérés a tanulmányban leírt módszer és a ténylegesen futtatott kód között, illetve olyan kísérleti pontszámok, amelyek a megadott kóddal nem reprodukálhatók. A Google kutatói erre a Chain-of-Evidence, vagyis bizonyítéklánc keretrendszerrel válaszolnak.
Minden állítást bizonyítékhoz kötnek
A Chain-of-Evidence alapelve szerint minden kutatási állításhoz rögzített bizonyítékláncnak kell tartoznia, és a láncnak valóban alá is kell támasztania az adott állítást. Ilyen állítás lehet egy hivatkozás, egy közölt szám, egy módszer leírása vagy egy következtetés. A kapcsolódó bizonyíték származhat szakmai tanulmányból, kísérleti naplóból, ténylegesen futtatott kódból vagy eredménytáblázatból.
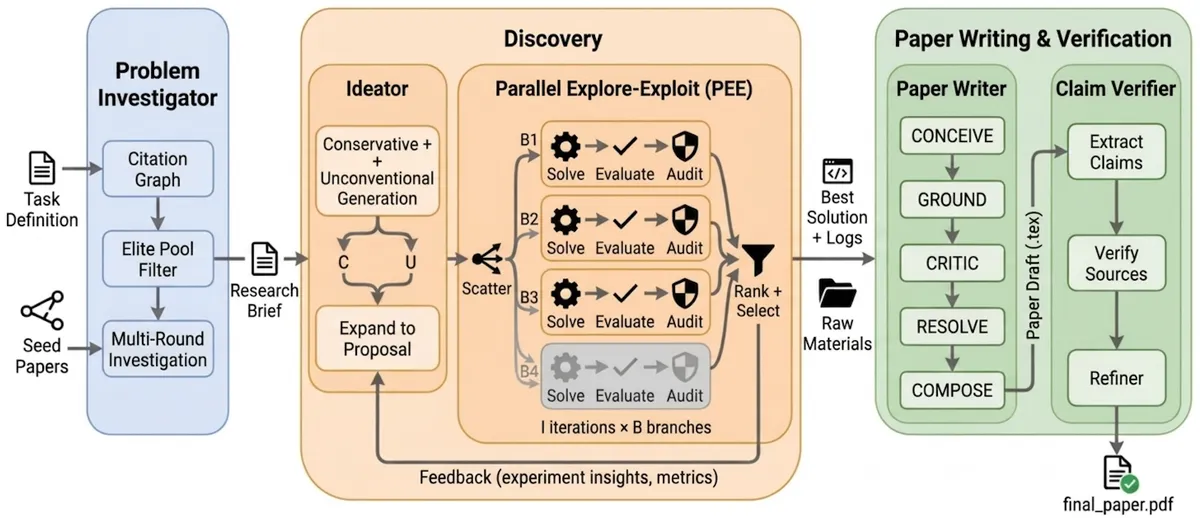
A Science One Framework három fő modullal valósítja meg ezt az elvet. A Problem Investigator a Semantic Scholar API segítségével hivatkozási gráfot épít, témánként legfeljebb 100 teljes szövegű PDF-et olvas be, majd strukturált kutatási összefoglalót készít. A végső tanulmány hivatkozásai ebből a lekérdezésből származnak, így a rendszer nem a modell memóriájára támaszkodik.
A Discovery Engine több párhuzamos ágon vizsgálja és finomítja az ötleteket. A Solver ügynök megvalósítja a megoldást, a feladatspecifikus kiértékelő pedig pontozza azt. A nyers kiértékelési eredményeket szigorú, csak olvasható rekordban gyűjtik össze. A Paper Writer és a Claim Verifier minden tényszerű állítást egy konkrét munkaterületbeli forráshoz köt. Ha egy állítás túllép a bizonyítékokon, a rendszer óvatosabban fogalmazza újra.
A CoE Audit négy ellenőrzést végez
A Google a prototípus vizsgálatához létrehozta a CoE Auditot is. Ez utólagos, automatizált ellenőrzési protokoll, amely ugyanazon eljárással vizsgálja a tanulmányt, a megoldást, a kódot és a hivatkozásokat.
- Pontszám-ellenőrzés: a tanulmányban szereplő eredményt összeveti a beküldött kód független újrafuttatásával.
- Specifikációs jogsértés: ellenőrzi, hogy a kód valóban a feladatot oldja-e meg, és nem a kiértékelési metrikát használja ki.
- Hivatkozás-ellenőrzés: tudományos API-kon keresztül vizsgálja, hogy a bibliográfiai tételek léteznek-e.
- Módszer és kód összhangja: nyelvi modellek segítségével hasonlítja össze a tanulmány módszerrészét a megvalósítással.
A vizsgálat 75, öt rendszeroptimalizálási feladaton készült tanulmányra terjedt ki az ADRS benchmarkban. A Google közlése szerint a Science One Framework mind a négy integritási ellenőrzésben az élen végzett. Egyetlen hivatkozása sem bizonyult kitaláltnak, a pontszám-ellenőrzésben hibátlan eredményt ért el, és a módszer, valamint a kód összhangja is ennél a rendszernél volt a legerősebb. Az összehasonlított alapvonalakban a kitalált hivatkozások aránya elérte a 21 százalékot.
A Google szerint a teljesítmény sem romlott
A Google szerint a szigorú ellenőrizhetőség nem rontotta a rendszer kutatási teljesítményét. Az ADRS öt feladatán a Science One Framework elérte vagy meghaladta az emberi szakértők eredményeit, két feladaton, a Cloudcaston és az EPLB-n pedig az összes rendszer közül a legjobb összpontszámot érte el.
A rendszer öt nehéz Kaggle-versenyen is részt vett az MLE-Bench keretében, ahol két arany- és két ezüstérmet szerzett. A Parameter Golf élő LLM-tréningversenyén a szigorú hardveres és fájlméret-korlátok betartásával érvényes beküldést készített, és a Google szerint 2026. április 27-én állapot szerinti, élvonalbeli pontszámot ért el. A kutatók következtetése szerint az önálló kutatási rendszereknél a megoldási képesség mellett az eredmények megbízhatósága is alapvető tervezési szemponttá válik.
Google Research: Science One Framework: A verifiable autonomous research framework via Chain-of-Evidence