A Google SensorFM modellje több mint egybillió percnyi adatból tanul
A Google Research bemutatta a SensorFM-et, egy viselhető egészségügyi adatokra fejlesztett alapmodellt, amely öt millió ember több mint egybillió percnyi szenzoradatán tanult. A kutatók szerint a rendszer 35 egészségügyi előrejelzési feladatra vihető át, és egy személyes egészségügyi asszisztens alapjaként is használható.
- A SensorFM öt millió ember több mint egybillió percnyi szenzoradatán tanult.
- A modell 35 egészségügyi előrejelzési feladaton vizsgálták.
- A SensorFM-B 35 feladatból 33-on érte el a legjobb eredményt.
- A rendszer a viselhető eszközök hiányos és töredezett adatait is tanulásra használja.
- A Google egy személyes egészségügyi asszisztensben is tesztelte a modellt.
Öt millió ember adataiból építették fel
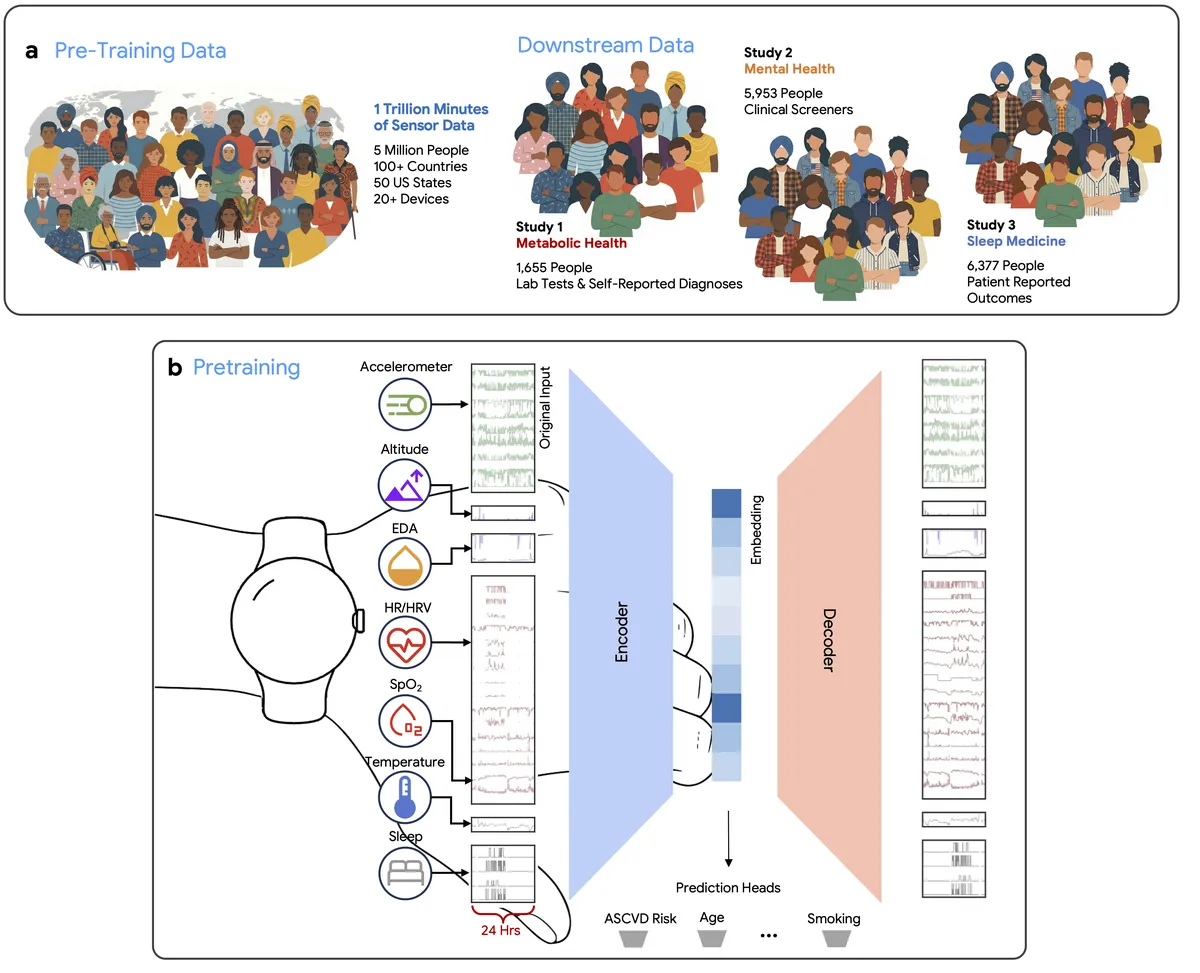
A SensorFM-et 2024 szeptembere és 2025 szeptembere között gyűjtött, azonosításra alkalmatlanná tett adatokon előtanították. Az adatok öt millió olyan résztvevőtől származtak, akik hozzájárultak adataik egészségügyi és jólléti kutatásokban való felhasználásához.
A korpusz több mint 100 országot, az Egyesült Államok mind az 50 tagállamát, valamint több mint 20 Fitbit- és Pixel Watch-modellt fedett le. A Google szerint minden résztvevőtől több hét adatait használták fel, ami több mint kétmilliárd órányi, vagyis egybillió percnél is több, perces felbontású jelet jelent.
A modell 34, egyperces összesített jellemzőt dolgoz fel öt szenzortípusból: fotopletizmográfiából (PPG), gyorsulásmérőből, bőr elektromos aktivitását mérő szenzorból (EDA), bőrhőmérőből és magasságmérőből. Ezekből többek között a pulzus, a szívritmus-variabilitás, a véroxigénszint, az alvási szakaszok, a mozgás, a lépésszám, a bőr vezetőképessége és a hőmérséklet jelei állíthatók elő.
A hiányos adatokhoz is alkalmazkodik
A SensorFM felügyelet nélküli, önfelügyelt tanulással rekonstruálja a szenzoradatokat. A módszer az LSM-2 megközelítésére és az Adaptive and Inherited Masking, röviden AIM keretrendszerre épül.
A viselhető eszközök adatai gyakran töredezettek. Kimaradások keletkezhetnek például az érzékelők ki- és bekapcsolása, az eszköz levétele vagy az energiatakarékos működés miatt. Az AIM a valódi hiányokat nem pótolja előzetesen, és a hiányos időablakokat sem dobja el. Ehelyett a természetes hiányokat és a tanítás során mesterségesen maszkolt adatokat együtt kezeli, így a modell a Google leírása szerint eleve figyelembe veszi az adatok hiányosságát.
A kutatók a modellméretet és a tanítási adatok mennyiségét is szisztematikusan növelték. A kísérletekben az adatmennyiség nagyjából 2 millió és 2 milliárd szenzoróra, a modellméret pedig 100 ezer és 100 millió paraméter között változott.
35 egészségügyi feladaton vizsgálták
A legnagyobb, SensorFM-B modell a teljes, ötmillió résztvevős adathalmazon tanítva 31 százalékkal csökkentette a rekonstrukciós veszteséget a legkisebb változathoz képest. A Google szerint az osztályozási feladatokon átlagosan 9 százalékos AUC-javulást, a regressziós feladatokon pedig 21 százalékos Pearson-együttható szerinti javulást értek el. A modellváltozatok közül a SensorFM-B 35 feladatból 33-on bizonyult a legjobbnak.
A rendszert három, egymástól független, intézményi etikai jóváhagyással rendelkező, előre tervezett vizsgálat összesen 13 985 résztvevőjén tesztelték. A 35 feladat a szív- és érrendszeri egészséget, az anyagcsere-kockázatot, a mentális egészséget, az alvást, a demográfiai jellemzőket és az életmódot érintette.
A SensorFM kódolóját a teszteken rögzítették, és csak egy könnyű lineáris fejet tanítottak rá. Ez a megoldás 35 feladatból 34-en jobb eredményt ért el, mint a kézzel kialakított jellemzőkre épülő, felügyelt alapmodell. A Google külön kiemelte, hogy kevés címkézett példa mellett is gyorsan felülmúlta a demográfiai, illetve a kézzel készített jellemzőkre támaszkodó alapmodelleket.
LLM-ügynökök és személyes egészségügyi asszisztens
A kutatók egy „osztályteremnek” nevezett ügynöki rendszert is létrehoztak. Ebben több, együttműködő és egymással versengő nyelvi modell iteratívan kódot ír, tesztel és finomít a SensorFM beágyazásaira épülő előrejelző fejekhez. A kísérletek során több mint 30 ezer lehetséges megoldást vizsgáltak.
Az ügynökök által tervezett fejek 20 osztályozási feladatból 16-on, a 15 regressziós feladatból pedig 12-n jobb eredményt értek el az egyszerű lineáris próbánál. A Google szerint a megoldások minősége a keresés során folyamatosan javult, és a fejlettebb nyelvi modellek, például a Gemini újabb változatai, jobb megoldásokat készítettek.
A SensorFM-et végül egy személyes egészségügyi asszisztensbe is beépítették, hogy a rendszer az egyén saját élettani adataira támaszkodó egészségügyi összefoglalókat készíthessen. A Google Research közlése szerint ezt 31 valós résztvevő adataiból származó egészségügyi összefoglalókon vizsgálták. A bemutatott eredmények alapján a modell célja egy újra felhasználható, kevés címkézett adattal is alkalmazható alap létrehozása a viselhető eszközök egészségügyi felhasználásához.
Google Research: SensorFM: Towards a general intelligence and interface for wearable health data