A hárombilliós modellek miatt új memóriamegoldásokra van szükség
A legfejlettebb mesterségesintelligencia-modellek már jóval meghaladják az 1 billió paramétert, ami új memóriamegoldásokat követel. A d-Matrix szerint a 3D-ben egymásra rétegzett DRAM és a memóriát a számítási egységekhez közelebb hozó feldolgozási architektúrák enyhíthetik a szűk keresztmetszetet.
- A Kimi K3 2,8 billió paraméteres modell.
- A DeepSeek legújabb modellje 1,6 billió paramétert tartalmaz.
- A K3 tokenenként 104 milliárd paramétert aktivál.
- A d-Matrix több mint tízszeres memóriát ígér egy kártyán 3D DRAM-mal.
- A szétválasztott feldolgozás csökkentheti a kártyák közötti adatátvitelt.
Újra billió fölé nőnek a modellek
A d-Matrix augusztus 31-én megjelent elemzése szerint a határmodellként emlegetett rendszerek paraméterszáma ismét gyorsan növekszik. Az OpenAI GPT-4 modelljét korábban nagyjából 1,7 billió paraméteresre becsülték, mixture of experts architektúrával. A forrás szerint ez akkoriban túl nagynak és rendkívül nehezen kiszolgálhatónak számított, ami korlátozásokat, kieséseket és megbízhatósági problémákat okozott.
A hardveres háttér hiánya miatt később kisebb modellek kerültek előtérbe. A korai DeepSeek és Qwen sorozatok a több száz milliárdos tartomány alsó részén maradtak, miközben a 70 milliárd paraméter alatti modellek is egyre képességesebbé váltak. A mixture of experts módszer ezekben a modellekben úgy javította a hatékonyságot, hogy egy adott feladatnál csak a paraméterek egy része volt aktív.
A d-Matrix szerint a trend ismét megfordult. A Kimi sorozat legújabb modellje, a K3 2,8 billió paraméteres, a DeepSeek legújabb modellje pedig 1,6 billió paramétert tartalmaz.
A számítás helyett a memória lehet a korlát
A nagy modellek futtatásánál nem feltétlenül a számítási teljesítmény jelenti a legnagyobb akadályt. A K3 például tokenenként 104 milliárd paramétert aktivál, így az összes paraméter feldolgozása nem szükséges minden lépésben. A problémát inkább az okozza, hogy a modell adatai nem jutnak el elég gyorsan a számítási egységekhez.
A klasszikus GPU-s rendszerekben a nagy sávszélességű, DRAM-alapú memória, vagyis a HBM szolgál a hatalmas modellek futtatásának alapjaként. A d-Matrix szerint ez elegendő kapacitást adhat egy 1 billió paraméternél nagyobb modellhez, de a kapacitás, a késleltetés és az átviteli sebesség között komoly kompromisszumok alakulnak ki.
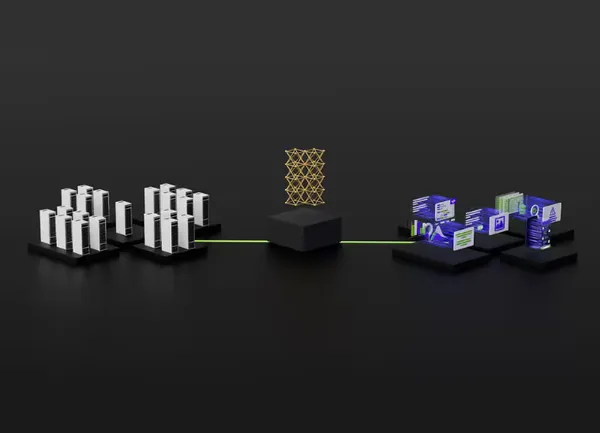
A GPU-k kihasználtságának növelése ronthatja a válaszidőt, míg a gyorsabb felhasználói élmény alacsonyabb kihasználtsághoz vezethet. A szétválasztott feldolgozási folyamatok, például az attention és az FFN szétválasztása, valamint a spekulatív dekódolás, a memóriát közelebb vihetik a számítási magokhoz. Ez az SRAM sebességét használja ki, az SRAM azonban a d-Matrix szerint nem tud olyan nagy memóriakészletet biztosítani, mint a HBM-re épülő architektúrák.
A 3D DRAM több memóriát tehet egyetlen kártyára
A vállalat egy olyan felépítést vázol, amelyben a DRAM-chipeket függőlegesen egymásra rétegezik. Állítása szerint ezzel egyetlen kártyán több mint tízszeresére növelhető a memória a jelenlegi megoldásokhoz képest, anélkül, hogy ugyanilyen mértékben kellene új GPU-kat hozzáadni.
A nagyobb memóriakészlet kevesebb kártyát tehet szükségessé egy következtetési feladathoz. Ez kevesebb kártyák közötti adatátvitelt, így a d-Matrix szerint kisebb sávszélesség- és energiaigényt jelenthet. A vertikális rétegzés közben elegendő helyet biztosíthat a teljes szakértői könyvtár és a memóriában tartott állapot számára.
A d-Matrix szerint a jövőbeli rendszerekben a szétválasztott feldolgozás és a nagyobb, rétegzett memóriakészlet együtt kezelheti a növekvő modelleket. A 100 milliárd paraméter alatti modellek továbbra is gyorsan fejlődnek, és egyszerűbb feladatokra vagy spekulatív dekódolásban vázlatmodellként is beilleszthetők. A nagyobb modellek kiszolgálásához azonban a vállalat szerint a számítás memóriához közelítése mellett magát a memóriát is új módon kell felépíteni.