Harvey: az RLM-harness 39,1 százalékponttal javította az M&A-elemzést
A Harvey és a Baseten olyan rekurzív nyelvimodell-harnesszt fejlesztett az M&A-átvilágításhoz, amely a vállalat szerint jelentősen javította a dokumentumintenzív jogi feladatok teljesítését. A hét vizsgált modell átlagos értékelési eredménye 23,3 százalékról 62,4 százalékra emelkedett.
- Az RLM-harness a hét vizsgált modell átlagos eredményét 23,3 százalékról 62,4 százalékra növelte.
- A LAB Diligence adatállományai legfeljebb 5000 dokumentumot és 80 millió tokent tartalmazhatnak.
- A Qwen3.5-122B-A10B utólagos tanítása 29,9 százalékról 63,0 százalékra javította az eredményt.
- A fő ügynök modellje nagyobb hatással volt a teljesítményre, mint az alügynökök modellje.
- A Harvey a GLM-5.3-mal folytatja az RLM-harness skálázását.
Akár 80 millió tokennyi dokumentumot kell átvizsgálni
A Harvey szeptember 8-án közzétett kutatási beszámolója szerint az M&A-átvilágítás során egyetlen feladat akár 80 millió tokennyi dokumentumkörnyezet feldolgozását is igényelheti. A vállalat a Basetennel együtt a LAB Diligence nevű környezetben vizsgálta, hogyan lehet ezt a munkát mesterséges intelligenciával kezelni.
Egyetlen adatállomány legfeljebb 5000 dokumentumot tartalmazhat, több tucat mappába és kategóriába rendezve. Az ügynök feladata egy teljes átvilágítási jelentés elkészítése, dokumentumhivatkozásokkal, szükség esetén számszerűsített kitettséggel és a tranzakció következő lépéseire vonatkozó javaslatokkal.
A jelentéseket egy nyelvi modellből álló értékelő vizsgálja több száz szakértői szempont alapján. Az Aravon Bridge Bank nevű példában 2270 dokumentum található 82 mappában, 14 kategóriában, összesen 31 millió token terjedelemben. Ehhez a feladathoz 571 értékelési szempont tartozik.
A fő ügynök részfeladatokra osztja a dokumentumokat
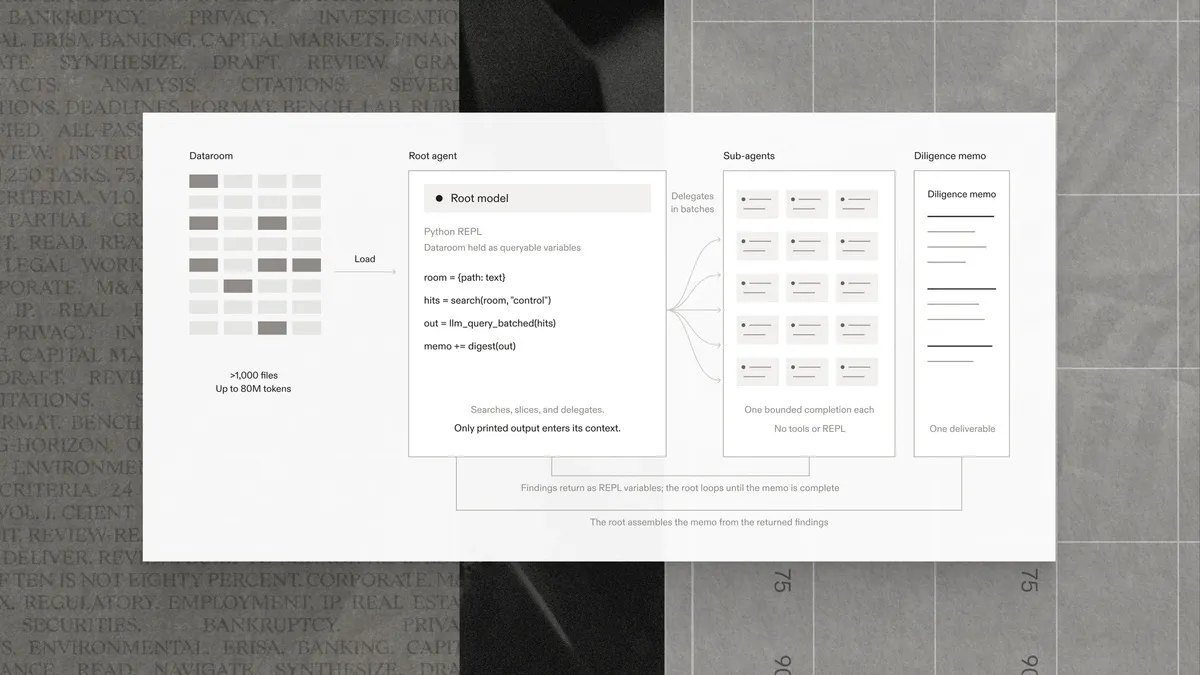
A Harvey és a Baseten RLM-harnessében az adatállományt egy Python REPL-be töltik be lekérdezhető változóként. A fő ügynök programozottan kereshet a dokumentumok között, megtervezheti az átvilágítást, majd korlátozott részfeladatokat oszthat ki alügynököknek.
Az alügynökök saját kontextusablakukban dolgoznak az adatállomány egy meghatározott részén, majd az eredményeiket visszaadják a REPL számára. A fő ügynök ezután összesíti a megállapításokat, és elkészíti a jelentést. A kísérletekben egyetlen alügynöki réteget használtak, a fő ügynök pedig a gyakorlatban sok hívást párhuzamosan indított.
A hagyományos eszközhasználati hurokban a 50 tesztadatállományon a modellek átlagosan az értékelési szempontok 23,3 százalékát teljesítették. Az RLM-harness hét modell esetében ezt 62,4 százalékra növelte, ami 39,1 százalékpontos javulás. A Harvey szerint a hagyományos megközelítésben egyetlen futtatás sem olvasta be az adatállomány több mint 1 százalékát, az RLM-harnessben viszont szinte minden futtatás 10 százaléknál nagyobb lefedettséget ért el, a legtöbb pedig az adatállomány közel egészét feldolgozta.
A Qwen3.5 utólagos tanítása tovább javított az eredményen
A kutatók megerősítéses tanulással utólagosan tanították a Qwen3.5-122B-A10B koordináló modellt az RLM-harnessen belül. Az 50 elkülönített LAB Diligence-adatállományon a modell értékelési szempontok alapján mért teljesítménye 29,9 százalékról 63,0 százalékra emelkedett.
A Harvey eredményei szerint a teljesítménynövekedésnek költségoldala is van. Az RLM-harness hat modell esetében növelte az adatállományonkénti generálási költséget. Claude Opus 5 kivételt jelentett: a hagyományos eszközhurokban körülbelül 18 dollárt költött egy adatállomány önálló olvasására, az RLM-harness fő ügynökeként körülbelül 7 dollárt, miközben 35 ponttal magasabb eredményt ért el.
A vizsgálat a fő ügynök és az alügynökök szerepét is összehasonlította 30 elkülönített adatállományon. A tesztelt összeállításokban a fő ügynök modelljének cseréje nagyobb hatással volt az eredményre. A legmagasabb és legalacsonyabb pontszámú fő ügynökök közötti különbség átlagosan körülbelül 38 százalékpont volt, míg az alügynök-modellek közötti megfelelő különbség körülbelül 8 pont.
A Harvey a GLM-5.3-mal folytatja a kísérleteket
A beszámoló szerint a fő ügynök a teljes tokenfelhasználás kisebb részét adja, miközben ő határozza meg az átvilágítás felosztását és állítja össze a megállapításokat. Claude Opus 5 koordináló modellként a bemeneti tokenek 3,8 százalékát, a kimeneti tokenek 1,1 százalékát adta.
A Harvey szerint az eredmények azt mutatják, hogy a feladatra szabott harnessben végzett utólagos tanítás működőképes irány lehet az olyan dokumentumintenzív jogi munkákban, mint az M&A-átvilágítás. A vállalat ezért a GLM-5.3 nevű, nagyméretű, nyílt súlyú modellt is fő ügynökként tanítja egy folyamatban lévő, nagyobb léptékű kísérletben.
Harvey: Post-Training RLM Agents for End-to-End M&A Diligence