A Hugging Face új tokenizálója akár tízszer gyorsabb lehet
A Hugging Face bemutatta a tokenizers v1 kiadásjelölt változatának teljesítménytesztjeit. A fejlesztők szerint az új verzió a v0.23-hoz képest sok esetben tízszeres nagyságrendű gyorsulást ér el, miközben ugyanazokat a tokenazonosítókat és programozási felületet tartja meg.
- A tokenizers v1 ugyanazokat a tokenazonosítókat adja, mint a v0.23.
- A Hugging Face szerint a gyorsulás sok esetben tízszeres nagyságrendű.
- Az új verzió csökkenti a memóriafoglalást és támogatja a natív párhuzamos feldolgozást.
- Az ismétlődő előtokeneket szálankénti gyorsítótár kezeli.
- A teljesítménytesztek a tokbench adattárából saját hardveren is újrafuttathatók.
A tokenizálás egyre gyakrabban válik szűk keresztmetszetté
A tokenizáló a szöveget olyan egész számok listájává alakítja, amelyet a modell fel tud dolgozni. A Hugging Face szerint ez a művelet korábban általában kevés számítási kapacitást igényelt a gépi tanulási folyamat többi részéhez képest. A gyorsabb modellek, a nagy adathalmazokon végzett tanítás, a sok párhuzamos kérés és a hosszú bemenetek ismételt feldolgozása azonban megváltoztatta ezt az arányt.
Ha a CPU nem készíti el időben a tokeneket, a modellhez tartozó GPU kihasználatlanul várakozhat. A tokenizers v1 fejlesztésének középpontjában ezért a teljesítmény és a terhelés növekedésével való skálázódás állt. A Hugging Face a kiadásjelölt változatot több szempont szerint hasonlította össze más, széles körben használt megoldásokkal, köztük az egyszálú és többszálú feldolgozást, a késleltetést, a dekódolási teljesítményt, a memóriahasználatot és a csomagméretet is vizsgálva.
A v1 megtartja a korábbi kompatibilitást
A tokenizers v1 ugyanazokat a tokenazonosítókat állítja elő, mint a v0.23. A fejlesztők célja az volt, hogy megőrizzék a kimenetet, az API-t, a szókészletet és az összevonási rangsorokat, miközben a működés többi részét javítják. A könyvtár továbbra is több tokenizálócsaládot támogat, és nem szűkíti a működését a byte pair encodingre, vagyis a BPE-re.
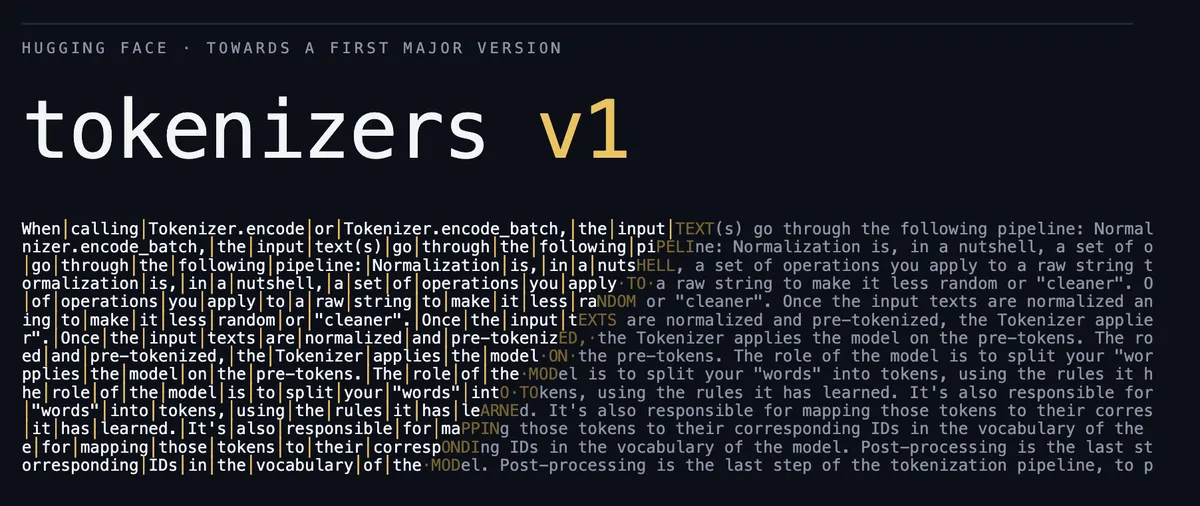
A tokenizálási folyamat négy lépésből áll. A normalizálás olyan műveleteket végezhet, mint a kisbetűsítés vagy a Unicode-normalizálás. Ezután az előfeldarabolás kisebb egységekre bontja a szöveget, a modell tokenekké alakítja ezeket és azonosítókat rendel hozzájuk, végül az utófeldolgozás hozzáadja a szükséges speciális tokeneket. A cikkben vizsgált tíz modellcsaládból nyolc BPE-t, kettő WordPiece-et vagy Unigramot használ.
Új memóriakezelés és párhuzamos feldolgozás
A fejlesztők több ponton írták át a könyvtár működését. A munkaterületet használó modell a hívó által biztosított átmeneti memóriaterületet alkalmazza, így a feldolgozási ciklusnak nem kell minden alkalommal új memóriát lefoglalnia. Az összevonási folyamat egy előre lefoglalt pufferben, láncolt adatszerkezettel dolgozik, ezért az elemek mozgatása helyett indexeket frissít.
A BPE-modellek előfeldarabolásához korábban reguláris kifejezést használtak. A bitcannon nevű megoldás a támogatott minták egy részénél SIMD-utasításokkal, bitfolyamokon végzett logikai műveletekkel keres határokat. Egy regiszterművelet 64 bájtot kezel. Azok a tokenizálók, amelyek mintája nem tartozik a támogatott grammatikák közé, továbbra is a reguláris kifejezéses útvonalat használják.
A v1 szálankénti szótárat is bevezet, amely az ismétlődő előtokenekhez korábban kiszámolt tokenazonosítókat tárolja. Ez olyan bemeneteknél lehet hasznos, ahol sok szó ismétlődik. A több szálon futó feldolgozásban minden szál saját átmeneti puffert és szótárat kap a közös alrendszerből, így a szálaknak nem kell egyetlen zároláson osztozniuk.
A fejlesztők újramérhető teszteket tettek közzé
A mérések a Hugging Face tokbench adattárából futnak, és a fejlesztők olyan parancsot is mellékeltek, amellyel bárki újra lefuttathatja a teszteket a saját hardverén. Az összehasonlításban minden motor ugyanazt a feldolgozási ciklust használta, a szókészlet betöltésének idejét külön kezelték, a kimeneti azonosítókat pedig FNV-1a ellenőrzéssel vetették össze az alaperedménnyel.
A tokenizers v1 munkája több nyílt forráskódú projekt tapasztalataira épült. A Hugging Face külön megköszönte az IBM, az NVIDIA és az ExecuTorch csapatának a javításokat, valamint a különböző hardvereken végzett tesztelésben nyújtott segítséget.
A felhasználók számára a legfontosabb változás az lehet, hogy nagy adathalmazok, ismétlődő szövegek vagy sok párhuzamos kérés feldolgozásakor kisebb eséllyel a tokenizáló miatt várakozik a modell. A gyorsulás mértéke a modell mintájától és a bemenet ismétlődésétől függ, ezért a Hugging Face a saját hardveren elvégezhető méréseket is a kiadás részévé tette.
Hugging Face: tokenizers v1: encode, decode and scaling, measured