Humming néven nyílt forrású könyvtár gyorsítja a kvantált inferenciát
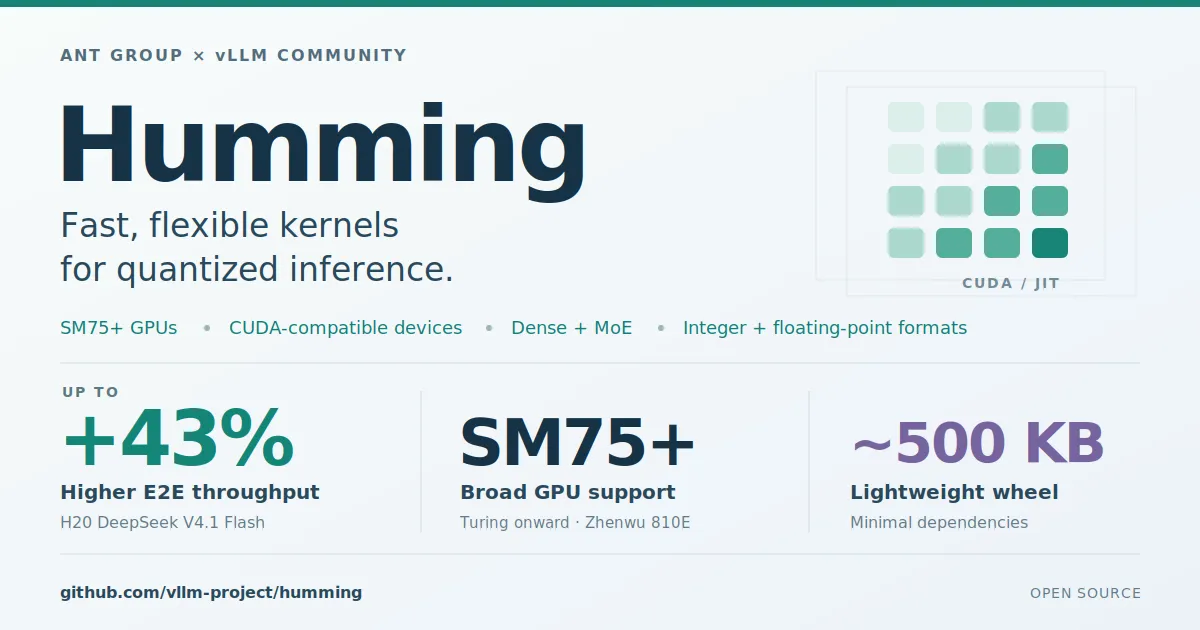
Az Ant Group és a vLLM közössége nyílt forrásúvá tette a Humming nevű kernelkönyvtárat, amelyet kvantált modellek inferenciájához terveztek. A megoldás több GPU-architektúrát, kvantálási formátumot és eltérő munkaterhelést kezel egységes felépítésben.
- Az Ant Group és a vLLM közössége nyílt forrásúvá tette a Hummingot.
- A könyvtár Turing vagy újabb NVIDIA GPU-kat és CUDA-kompatibilis eszközöket támogat.
- Egységes rendszerben kezeli a különböző súly-, aktivációs és skálázási formátumokat.
- A vLLM mérése szerint a Humming W4A16 kernelje gyorsabban fordult a vizsgált H200 szerveren.
- A Humming W4A8-MXFP4 útvonalat is kínál a Blackwell előtti GPU-architektúrákhoz.
Egy könyvtár több kvantálási beállításhoz
A Humming általános célú, nagy teljesítményű kernelkönyvtár kvantált inferenciához. Az NVIDIA Turing architektúrától kezdve támogatja a GPU-kat, valamint olyan CUDA-kompatibilis eszközöket is, mint a T-Head Zhenwu 810E.
A rendszer egyetlen architektúrában kezeli a súlyok és aktivációk különböző formátumait sűrű és mixture-of-experts, vagyis MoE modellekhez. A támogatott beállítások között egész és lebegőpontos adattípusok, különböző bitmélységek és skálázási módszerek szerepelnek. A gyakori konfigurációk közé tartozik a WNA16, a W8A8, a W4A8 és a W4A4, ahol a W a súlyok, az A pedig az aktivációk bitmélységét jelöli.
A Humming a különböző kvantálási exportformátumokat közös szabványos leírássá alakítja. Ebben elkülönítve szerepel a súlyformátum, a skálázás részletessége, a skálák adattípusa, a nullpontok és az esetleges másodlagos skálák. Így például a csoportos INT4 súlyok BF16 aktivációkkal is párosíthatók.
A kernel a hardverhez és a munkaterheléshez igazodik
A Humming működési útvonala három lépésből áll: a kvantált számítás leírásából, a hardverhez és munkaterheléshez megfelelő konfiguráció kiválasztásából, valamint a CUDA-komponensekből összeállított kernel lefordításából. A rendszer a súlyokat előfeldolgozza, ellenőrzi a paramétereket, szükség esetén kitölti a dimenziókat, majd a célkernelhez illeszkedő elrendezésbe rendezi az adatokat.
Három konfiguráció határozza meg a végrehajtást. A Layer Config a tenzorméreteket, adattípusokat, kvantálási paramétereket és a célarchitektúrát írja le. A Compute Config a GEMM típusát és számítási beállításait adja meg. A Tuning Config többek között a csempeméreteket, a pipeline lépésszámát, a warp-specializációt, a memóriaelérést és az MMA utasításokat választja ki.
A Humming alapértelmezésben eszközspecifikus heurisztikákat használ. Külön konfigurációkat készíthet eltérő bemeneti mérettartományokra, majd futás közben a megfelelő kernelt választhatja ki. Kis kötegméreteknél az aszinkron másolást és MMA-t használó többlépcsős pipeline lehet hatékonyabb, nagyobb kötegeknél pedig a TMA és az UMMA adhat jobb áteresztőképességet. A lefordított kerneleket a rendszer újrahasználathoz gyorsítótárazza.
Gyorsabb fordítás és alacsonyabb karbantartási teher
A CUDA-szinten a Humming újrahasználható komponensekbe szervezi a feladatütemezést, az adatmozgatást, a dekódolást, a dekvantálást, a skálázást, a Tensor Core számításokat és a kimeneti feldolgozást. Ezek a komponensek külön kezelik a számformátumokat, a GPU-architektúrákat, valamint a sűrű és MoE munkaterhelések ütemezését.
A JIT-fordítás, vagyis a futás közbeni fordítás, a három konfiguráció alapján csak a szükséges összetevőket állítja össze, és elhagyja a nem használt ágakat. A fejlesztők szerint így egy új formátum vagy architektúra támogatásához elég lehet a megfelelő komponenseket bővíteni, miközben egy közös komponens javítása több konfigurációban is hasznosul.
A vLLM közlése szerint egy H200 szerveren, CUDA 13.4 használatával, egyetlen W4A16 kernel fordítása 23,35 másodpercig tartott CUTLASS és NVCC mellett. A Humming esetében ugyanez NVCC-vel 1,82, NVRTC-vel pedig 1,88 másodperc volt, kikapcsolt fordítási gyorsítótár mellett. A rendszer a modell bemelegítése során párhuzamosan is fordít, és a közlés szerint egy réteg GEMM-műveleteihez, az összes támogatott M méretet lefedve, a kernelek fordítása és betöltése körülbelül 2, illetve 4 másodpercet vesz igénybe.
A Humming a kis bitmélységű számításokat célozza
A kvantálás csökkenti a súlyok és aktivációk memóriaigényét, valamint az adatmozgatást. Ez különösen fontos MoE modelleknél, ahol egy token csak az összes szakértő egy részét aktiválja, miközben a teljes súlykészletet tárolni kell. A forrás példaként a DeepSeek-V3-at említi, amely 671 milliárd paramétert tartalmaz, és tokenenként 37 milliárd paraméter aktiválódik.
A Humming egyik kiemelt útvonala a W4A8-MXFP4 inferencia meglévő GPU-kon. A Blackwell előtti architektúrák nem rendelkeznek natív MXFP4 Tensor Core támogatással, ezért a rendszer a kernelben MXFP4 súlyokat INT8 vagy FP8 számítási formátumba alakít. A vLLM szerint ez a megoldás kis M értékeknél jelentősen felülmúlja a hagyományos W4A8 implementációkat, nagy M értékeknél pedig megközelíti a W8A8 teljesítményét.
A Humming forráskódja a github.com/vllm-project/humming címen érhető el. A projekt célja, hogy a kvantált modellek támogatása mellett a különböző GPU-khoz, bemeneti méretekhez és inferenciamunkaterhelésekhez szükséges kernelhangolás egy közös, újrahasználható rendszerben történjen.