A vLLM már az első napon támogatja a Recursive Flint modelljét
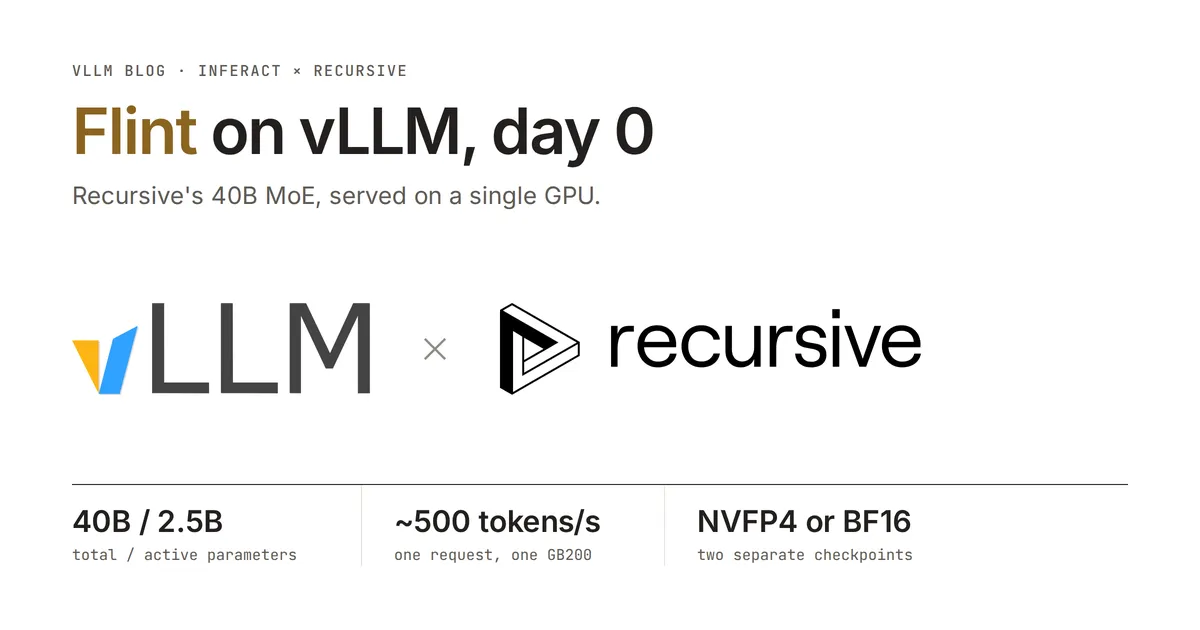
A vLLM támogatást adott a Recursive Flint modelljéhez, amelynek NVFP4 és BF16 változata is futtatható egyetlen GPU-n. A vLLM szerint egy GB200-on, 100 ezer tokenes kontextus mellett a rendszer körülbelül 485 tokent generál másodpercenként.
- A vLLM már az első napon támogatja a Recursive Flint modellt.
- A 40 milliárd paraméteres MoE tokenenként körülbelül 2,5 milliárd paramétert aktivál.
- Az NVFP4 és a BF16 változat is futtatható egyetlen GPU-n.
- NVFP4 esetén a dekódolás 4,81-ről 1,78 ezredmásodpercre gyorsult.
- A Flint 262 ezer tokenes kontextusablakot kezel.
Két ellenőrzőponttal érkezik a Flint
A Flint egy 40 milliárd paraméteres kevert szakértői modell, vagyis MoE. Egy token feldolgozásakor körülbelül 2,5 milliárd paraméter aktiválódik. A modell 262 ezer tokenes kontextusablakot kezel, és két külön ellenőrzőpontként érhető el: NVFP4 és BF16 változatban.
A vLLM közlése szerint mindkét változat egyetlen GPU-n fut. Az NVFP4 ellenőrzőpont kvantálástudatos tanítással készült GGUF-fájl. A vLLM betöltéskor veszteségmentesen újracsomagolja az adatokat, majd W4A16 módban, BF16 aktivációkkal és BF16 kulcsérték-gyorsítótárral futtatja a modellt.
A Flint felépítése 49 rétegből álló, előnormálásos MoE, 2048-as rejtett mérettel. A 256 szakértő közül a modell szigmoid alapú top-6 kiválasztást használ, emellett egy megosztott szakértője is van. Az első két réteg sűrű MLP-t alkalmaz.
A legtöbb réteg csak helyi figyelmet használ
A modell 35 rétege 513 tokenes, csúszóablakos figyelmet használ RoPE pozíciókódolással. A további 14 réteg a teljes kontextust látja, de pozíciókódolás nélkül. A teljes sorozathoz tartozó kulcsértékeket csak ez a 14 réteg tárolja, ezért a gyorsítótár költsége tokenenként 28 KiB.
A Flint emellett tanult figyelmi nyelőpontokat, 32 lekérdezési és 4 kulcsérték-fejű GQA-t, valamint fejenkénti Q és K RMSNorm normalizálást használ. A vLLM szerint saját kerneljei a referenciaimplementáció kerekítési pontjait követik, és a pontosság megegyezik a referenciáéval a GSM8K, a GPQA-Diamond, a hosszú kontextusú MRCR és egy eszközhívási tesztkészlet esetében.
A célzott kernelek jelentősen csökkentették a késleltetést
A vLLM első, szabványos rétegekre épülő megvalósítása kis kötegméretnél lassú volt. Egy dekódolási lépés 1096 kernelt futtatott, amelyek közül sok nagyobb kötegekhez volt optimalizálva. A fejlesztők ezért Flinthez igazított kerneleket készítettek, és minden változtatást a referenciaimplementációval ellenőriztek.
Az összevont Q és K normalizálás, a RoPE és a gyorsítótár írása 8 százalékkal csökkentette a késleltetést. A kis kötegű MoE kernelek 27 százalékos, a sűrű GEMV művelet 25 százalékos, a normalizálási és SiLU kernelek pedig 10 százalékos javulást hoztak. A dekódolási figyelem további 5 százalékkal, az alacsony késleltetésű dekódolási útvonal 14 százalékkal javított az eredményen.
Az NVFP4 dekódolás ideje 4,81 ezredmásodpercről 1,78 ezredmásodpercre csökkent, ami 2,7-szeres gyorsulás. BF16 esetén az érték 3,53-ról 2,34 ezredmásodpercre változott. A 8 ezer tokenes előfeldolgozás 207 ezredmásodpercről 145-re rövidült, miközben egy előrehaladás 1096 helyett 346 kernelt futtat.
Mit kell tudni a használathoz?
A vLLM szerint a Flint GLM-4.7 stílusú eszközhívásokat és gondolkodási blokkokat bocsát ki, ezért a glm47 eszközhívási és következtetési elemzőket kell használni. A dokumentáció alapértelmezett mintavételi beállítása a 1,0-s hőmérséklet, a 0,95-ös top-p és a 20-as top-k.
A gondolkodás beleszámít a max_tokens értékébe, ezért nehéz feladatoknál legalább 32 ezer tokenes keretet javasolnak. A Flinthez készült kernelek egyetlen Blackwell GPU-ra, TP=1 konfigurációra és BF16 gyorsítótárra céloznak. Más konfigurációk esetén a vLLM szabványos rétegei veszik át a futtatást.
vLLM: Day-0 Support for Flint on vLLM