Az IFCO több mint 60 százalékkal gyorsította dbt-folyamatát Databricksen
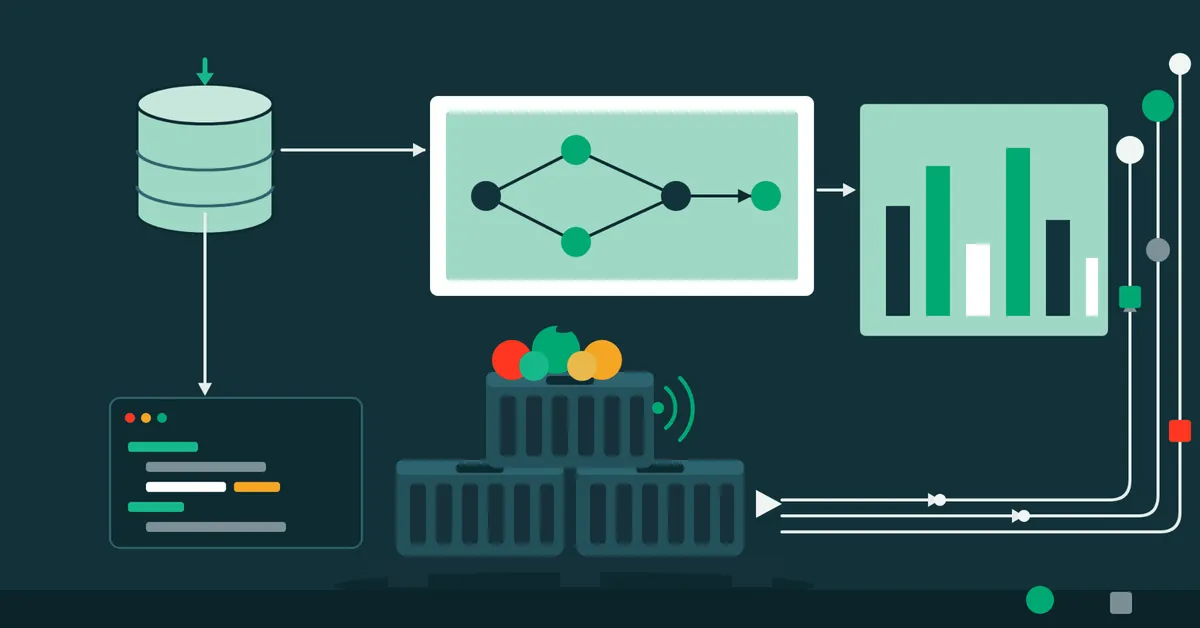
Az IFCO több mint 60 százalékkal csökkentette központi adatfeldolgozási feladatának napi futási idejét Databricksen, és megszüntette az éjszakai teljes újrafuttatást. A vállalat a dbt inkrementális modelljeit, a Delta Lake írási műveleteit és a projektek felügyeletét hangolta össze.
- Az IFCO több mint 60 százalékkal csökkentette központi dbt-feladatának futási idejét.
- A vállalat kivezette a költséges éjszakai teljes frissítést.
- A liquid clustering és a dinamikus fájlpruning csökkenti az olvasott és újraírt adatok mennyiségét.
- A lassú modelleket a tényleges Databricks-végrehajtási terv alapján elemzik.
- A dbt-modellek Databricks Jobs alatt külön feladatként futnak.
Milliárdnyi eseményből kell üzleti mutatókat készíteni
Az IFCO újrahasználható műanyag rekeszek és raklapok körforgásos poolingszolgáltatását működteti. A vállalat több mint 2000 alkalmazottal dolgozik világszerte, és több mint 50 országban követi az eszközök mozgását. A rekeszek és raklapok a termelőktől és csomagolóüzemektől az elosztóközpontokon és kiskereskedőkön át visszakerülnek az IFCO szervizközpontjaiba, ahol megmossák, szétválogatják, majd újra forgalomba állítják őket.
Minden eszköz életciklusát nyomon követik. Az adatokból olyan mutatókat számolnak, mint a ciklusidő, a veszteség, a törés, a mosási költség és a pool mérete. A szemantikai réteg ezeket a különböző forrásból érkező jeleket egységes, szabályozott nézetbe rendezi. Ilyen forrás a mosósoron rögzített vonalkód, a rakodóajtóknál működő RFID, valamint a GPS-helyzetet, közeli Bluetooth-jeladókat és hőmérsékletet jelentő akkumulátoros nyomkövetők.
A rendszer naponta több milliárd követési eseményt dolgoz fel. A késve érkező adatok külön nehézséget jelentenek, mert egyes adatfolyamok hetekkel, néhány pedig hónapokkal később fut be. Egy utólag beérkező megfigyelés az eszköz teljes későbbi eseménysorát és az abból számított mutatókat is módosíthatja.
A kevesebb olvasás és írás hozta a fő gyorsulást
A Databricks 2026. október 6-án közzétett beszámolója szerint az IFCO adatplatformcsapata a Databricks Forward Deployed Engineeringgel együttműködve a dbt-ben maradó transzformációs logikát olyan beállításokkal kapcsolta össze, amelyek konkrét Delta Lake-műveleteket szabályoznak.
A modelleket azokon az oszlopokon fürtösítették, amelyeken a lekérdezések szűrnek és összekapcsolnak. Az eszközaktivitási adatoknál ilyen kulcs az eszköz és az esemény dátuma. A liquid clustering lehetővé teszi, hogy a motor kihagyja azokat a fájlokat, amelyekben nem lehet egyezés, így kevesebb adatot kell beolvasni.
A stabil kulccsal rendelkező, ismétlődő frissítéseknél a merge stratégiát használták. Az eszközaktivitás esetében az asset_id és az event_date_time alkotja a tényleges adatszemcsét. A dinamikus fájlpruning csak az érintett célfájlokat választja ki, egy sorhashen alapuló feltétel pedig megakadályozza a ténylegesen nem változó sorok újraírását.
A delete+insert stratégia olyan esetekben lehet egyszerűbb, amikor egy egész adategyüttest kell újraszámolni, és a soroknak nincs stabil azonosítójuk. Ennél azonban a teljes csoport újraírására kerül sor akkor is, ha egyes sorok változatlanok maradtak.
Az IFCO a feldolgozást az új vagy késve érkező adatok által érintett eszközökre korlátozta. A modellek az írásnál szélesebb időablakból olvasnak, így a késői események is bekerülhetnek a számításba teljes frissítés nélkül. A Delta-táblák karbantartásához optimalizált írást és automatikus tömörítést, illetve a Predictive Optimizationt használják.
A valódi végrehajtási tervet kellett megvizsgálni
Az egyik legnagyobb terhelést az a modell okozta, amely a különböző nyomkövetési technológiák megfigyeléseit eszközönként egységes, helyhez kötött adatfolyammá alakítja. A modell ablakfüggvényekkel rendezi az eseményeket eszköz és eseményidő szerint. Hiányzó helyadat esetén a Databricks SQL beépített H3-függvényei alakítják a földrajzi koordinátákat hatszögrács-cellákká.
A vizsgálat során az IFCO nem a dbt által lefordított SQL-re támaszkodott. A dbt compile által előállított lekérdezés ugyanis nem mutatja meg teljesen, mi fut inkrementális modell esetén. A Databricks a háttérben ideiglenes nézeteket, céltábla-olvasást és végső írást is végrehajt. Ezért a csapat a lekérdezési előzményekből származó, ténylegesen végrehajtott tervet elemezte, szakaszonként.
A terv alapján a modell több milliárd sort olvasott, több száz gigabájtnyi adatot írt ki lemezre ideiglenesen, és futási idejének körülbelül 85 százalékát egyetlen, eszközönként végzett ablakos rendezés és keverés emésztette fel. A Databricks beszámolója szerint a folyamat gyakorlatilag minden futáskor újraépítette a teljes táblát. A megközelítés átalakítása több mint 60 százalékkal csökkentette a központi feladat futási idejét, és lehetővé tette a költséges éjszakai teljes frissítés kivezetését.
Modellenként külön feladat javítja az átláthatóságot
Az IFCO a dbt-projektet Databricks Jobs környezetben nem egyetlen átláthatatlan feladatként futtatja. A nyílt forráskódú databricks-dbt-factory segítségével minden modell külön feladatot kap. Így modellenként látható a teljesítmény, célzottan újrafuttathatók a hibás részek, és a tesztelés is kikényszeríthető.
A vállalat emellett olyan ismételhető képességet állított össze, amely minden modellen lefuttatja a lassulások diagnosztikáját. A megközelítés a felhasználók és az adatcsapat számára azt jelenti, hogy a későn érkező adatok kezelése mellett a hibák és a teljesítményproblémák is pontosabban lokalizálhatók. A Databricks szerint a legfontosabb kontroll továbbra is annak ellenőrzése, hogy a motor a tényleges végrehajtási tervben valóban elvégzi-e a fájlpruningot, és nem csendben a teljes táblát olvassa.
Databricks: Scaling and Operating a Large dbt Project on Databricks: IFCO's Data Team on Performance, Visibility, and Debugging