Másodpercek alatt állítható helyre a 100 terabájtos adatbázis
A Databricks Lakebase Postgres új, branch alapú visszaállítása a vállalat szerint másodpercekre csökkenti az adatbázis-helyreállítás idejét. Egy 100 TB-os adatbázis visszaállítása ugyanúgy metadata művelet lehet, mint egy 10 GB-osé.
- A Lakebase Postgres branch alapú visszaállítást vezet be.
- A helyreállítás adatmásolás helyett metadata műveletként működik.
- A Databricks szerint egy 100 TB-os adatbázis visszaállítása másodperceket vehet igénybe.
- Az új ág saját számítási kapacitással és kapcsolati karakterlánccal rendelkezik.
- A módszer AI-ügynökök által kezelt elágazási és visszavonási folyamatokat is támogat.
A hagyományos visszaállítás órákig tarthat
A kezelt OLTP-adatbázisoknál a helyreállítás méretnövekedéssel egyre lassabbá válik. A hagyományos folyamat során új számítási példányt kell létrehozni, vissza kell tölteni egy objektumtárolóban lévő pillanatképet, majd a Postgres tranzakciós naplóit, vagyis a WAL-t, a kívánt időpontig újra kell játszani.
Ez a folyamat nagy adatbázisoknál több órás kiesést okozhat. A pillanatkép visszatöltése önmagában is időigényes, ráadásul az adatbázis akkor sem feltétlenül áll készen az éles terhelésre, amikor a helyreállított példány már elérhető. A szükséges adatoknak előbb a Postgres lemezére kell kerülniük, miközben a még hiányzó blokkokat a rendszer használat közben is lekérheti az objektumtárolóból.
A magas rendelkezésre állású replika segíthet akkor, ha az elsődleges gép meghibásodik, de nem feltétlenül védi ki a hibás írásokat vagy a véletlenül törölt adatokat. Ha a rossz állapot már a készenléti példányon is megjelent, továbbra is visszaállításra van szükség.
A Lakebase a másolás helyett ágat hoz létre
A Databricks Lakebase Postgres architektúrája különválasztja a számítási kapacitást és a tartós adattárolást. A Postgres továbbra is a számítási oldalon futtatja az SQL-lekérdezéseket, kezeli a tranzakciókat és előállítja a WAL-t, de az adatok tartós példányát nem ez a komponens birtokolja.
A WAL-t a safekeeperek fogadják, és egy tranzakció akkor válik tartóssá, amikor a safekeeperek kvóruma nyugtázta a rekordot. A pageserver ebből állítja elő azokat az oldalverziókat, amelyeket a Postgres olvas, az objektumtároló pedig az immutable, vagyis nem módosítható hosszú távú előzményeket őrzi.
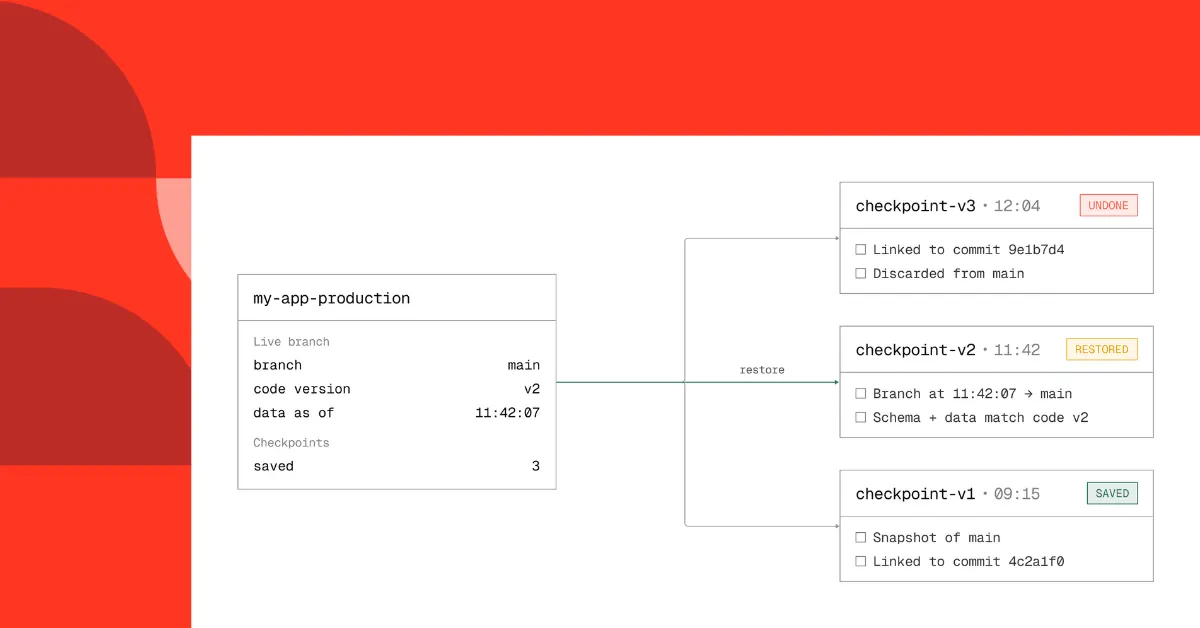
Ennek köszönhetően a korábbi állapotok nem egyetlen felülírt adatpéldányban léteznek, hanem címezhető idővonalként. Visszaállításkor a rendszer kiválaszt egy korábbi időpontot, ezt hozzárendeli a tárolási előzmény megfelelő pontjához, majd új ágat hoz létre és számítási kapacitást kapcsol hozzá.
Az új ág saját számítási erőforrással és kapcsolati karakterlánccal rendelkezik, ezért a produkciós adatbázistól függetlenül lekérdezhető. A forrás szerint a visszaállított adatbázis gyakorlatilag az üzembe helyezés után elérhető, függetlenül az alapul szolgáló adatbázis méretétől.
A felhasználók gyorsabban ellenőrizhetik a helyreállított állapotot
A branch alapú módszer nem másolja át az adatbázist, és nem várja meg a teljes WAL-újrajátszást. A visszaállított ág a már létező kép- és delta-rétegekre mutat az adott időpontig. A Databricks ezt metadata műveletként írja le, amelynél a helyreállítási idő nem nő együtt az adatbázis méretével.
A hibát követően a felhasználó előbb megvizsgálhatja a kiválasztott korábbi időpontot, például lekérdezésekkel, majd csak ellenőrzés után hozhatja létre az ágat. A vállalat szerint ez AI-ügynökök számára is lehetővé teszi az ágak létrehozását és a visszavonási munkafolyamatok kezelését.
A Databricks által idézett, 50, legalább 1 TB-os éles Postgres-adatbázist használó fejlesztőt vizsgáló felmérésben 59 százalék kritikus éles hibáról számolt be az előző 12 hónapban. A válaszadók 30 százaléka legalább háromórás kiesést tapasztalt, és csak 21 százalékuk állt helyre 60 percen belül. A Lakebase megközelítésének célja ezeknek a méretből adódó, másoláson és napló-visszajátszáson alapuló várakozásoknak a megszüntetése.
Databricks: Lakebase Postgres branch-based restores for fast recovery at scale