Az Inworld fogyasztói AI-alkalmazásokra szabott következtetési szolgáltatást indított
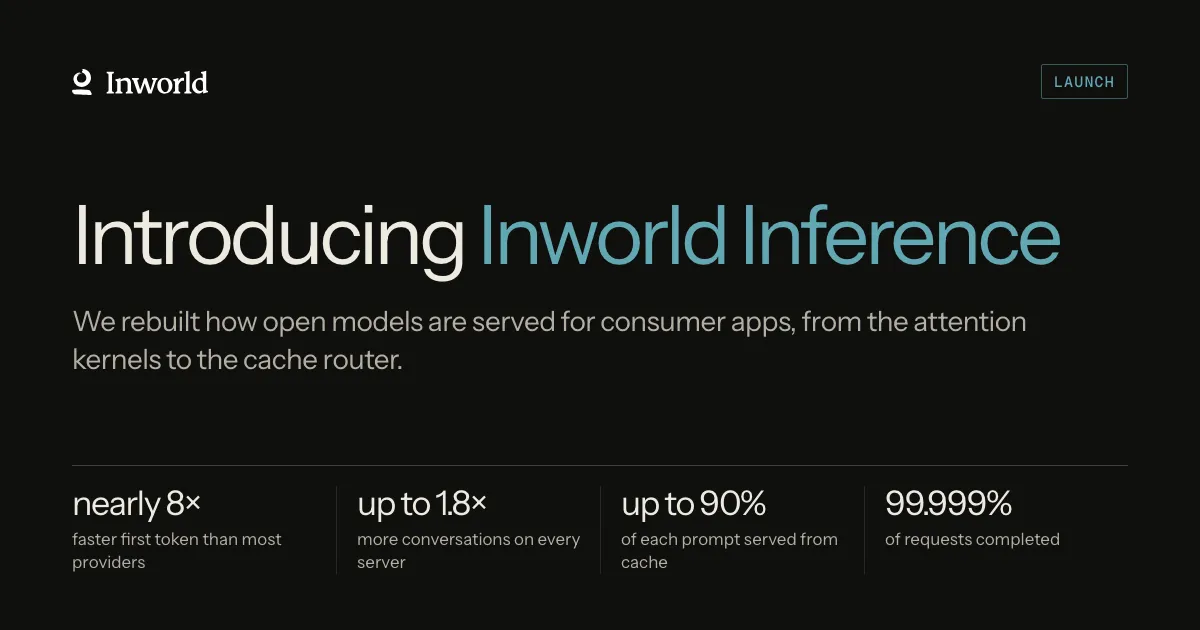
Az Inworld megnyitotta minden fejlesztő előtt az Inworld Inference szolgáltatást, amelyet kifejezetten fogyasztói AI-alkalmazásokhoz tervezett. A vállalat szerint a rendszer egyes modelleknél gyorsabb első tokent, alacsonyabb bemeneti árat és nagyobb megbízhatóságot kínál.
- Az Inworld Inference minden fejlesztő számára elérhetővé vált.
- A szolgáltatást kifejezetten fogyasztói AI-alkalmazásokhoz tervezték.
- A Gemma 4 26B p95 elsőtoken-ideje 0,31 másodperc volt az Inworld mérésében.
- A Gemma 4 26B bemeneti ára 0,07 dollár egymillió tokenenként.
- A GLM 5.3 Flash több mint 20 millió kérésének 99,999 százaléka hiba nélkül teljesült.
A fogyasztói AI más terhelést jelent
Az Inworld szerint a vállalati és a fogyasztói AI-alkalmazások eltérő műszaki kihívásokat támasztanak. Egy vállalati feladatnál egyetlen eredmény jelentős manuális munkát válthat ki, ezért a válaszra gyakran lehet várni. Egy fogyasztói alkalmazásban viszont a felhasználó minden üzenet után azonnali reakciót vár, miközben ugyanazon előfizetésből vagy ingyenes munkamenetből sok modellhívást kell kiszolgálni.
A vállalat szerint a párbeszédes alkalmazásokban az emberek 0 és 300 milliszekundum közötti időt hagynak két megszólalás között. Ebbe az időbe a hálózati kapcsolatnak, hangalapú alkalmazásoknál pedig a beszédszintézisnek is bele kell férnie. Az Inworld mérése szerint a Gemma 4 26B modellnél a medián első token 117 milliszekundum alatt érkezik meg.
A fogyasztói kérések jellemzően hosszú bemenetet és rövid választ tartalmaznak. Az Inworld által kiszolgált alkalmazások 2026 szeptemberéig vizsgált forgalmában a medián promptok 13 és 36-szor hosszabbak voltak a válaszoknál. Egyetlen interakció több modellhívást is indíthat, például moderációhoz, memóriaolvasáshoz, rangsoroláshoz és a végső válasz létrehozásához.
Saját kiszolgálási megoldásokat építettek a modellekhez
Az Inworld Inference nem több ezer modellt listáz, hanem azokat az alapmodelleket optimalizálja, amelyeket a fogyasztói alkalmazások választanak. A vállalat példaként a Gemma 4, a GLM, a DeepSeek és a MiMo modelleket említi.
Az Inworld minden modellhez külön kiszolgálási buildet készít. Ezekben új figyelmi kernelek, valós idejű dekódolás, alacsonyabb pontosságú súlyok és olyan útválasztó szerepel, amely az adott beszélgetést ahhoz a szerverhez küldi vissza, amely már tárolja a kontextusát. A vállalat szerint minden új build csak akkor kerül bevetésre, ha az értékelési eredményei elérik a lecserélt build szintjét.
A szolgáltatásban a hosztolt modellekhez nincs sebességkorlátozás, a fejlesztők kérésenként választhatnak szolgáltatási szintet, és automatikus kieséskezeléssel több modell között is útvonalazhatják a kéréseket. Saját modell dedikált telepítése is használható.
Gyorsaság, ár és rendelkezésre állás
Az Inworld közlése szerint a Gemma 4 26B első tokenje a p95 mérésben 0,31 másodperc alatt érkezett meg, szemben az OpenRouter medián szolgáltatójának 2,42 másodpercével. Ez a vállalat számítása szerint 7,8-szoros előnyt jelent. A p50 érték 0,17 másodperc volt az Inworldnél és 0,61 másodperc a medián szolgáltatónál, vagyis 3,6-szoros különbséget mértek.
A Gemma 4 26B bemeneti ára az Inworldnél 0,07 dollár egymillió tokenenként. Az OpenRouteren szereplő, a felhasználói adatokon nem tanító szolgáltatók medián ára 0,1115 dollár volt 2026. október 12-én. Az Inworld szerint az öt kiemelt modell közül háromnál kínálja a legalacsonyabb ilyen bemeneti árat.
A vállalat szerint a promptok akár 90 százaléka gyorsítótárból szolgálható ki, a gyorsítótárazott bemenet ára pedig akár 99 százalékkal is alacsonyabb lehet. A GLM 5.3 Flash esetében több mint 20 millió, 30 nap alatt feldolgozott kérés 99,999 százaléka hiba nélkül teljesült. Az Inworld adatai szerint 98 kérés hibázott, miközben a vizsgált időszak 2026. október 12-ig tartott.
Az Inworld a szolgáltatást a fogyasztói AI-alkalmazások működésének alapjához pozicionálja. A cég közlése szerint szinte minden kiszolgált token olyan alkalmazásból származik, amelyet az emberek a saját életükben használnak, és a vállalat havonta több tízbillió tokent dolgoz fel, ami 25-szöröse a márciusban kiszolgált mennyiségnek.
Inworld AI: Introducing Inworld Inference