IsoExec: bitpontos végrehajtással csökkentené az RL-rendszerek eltéréseit
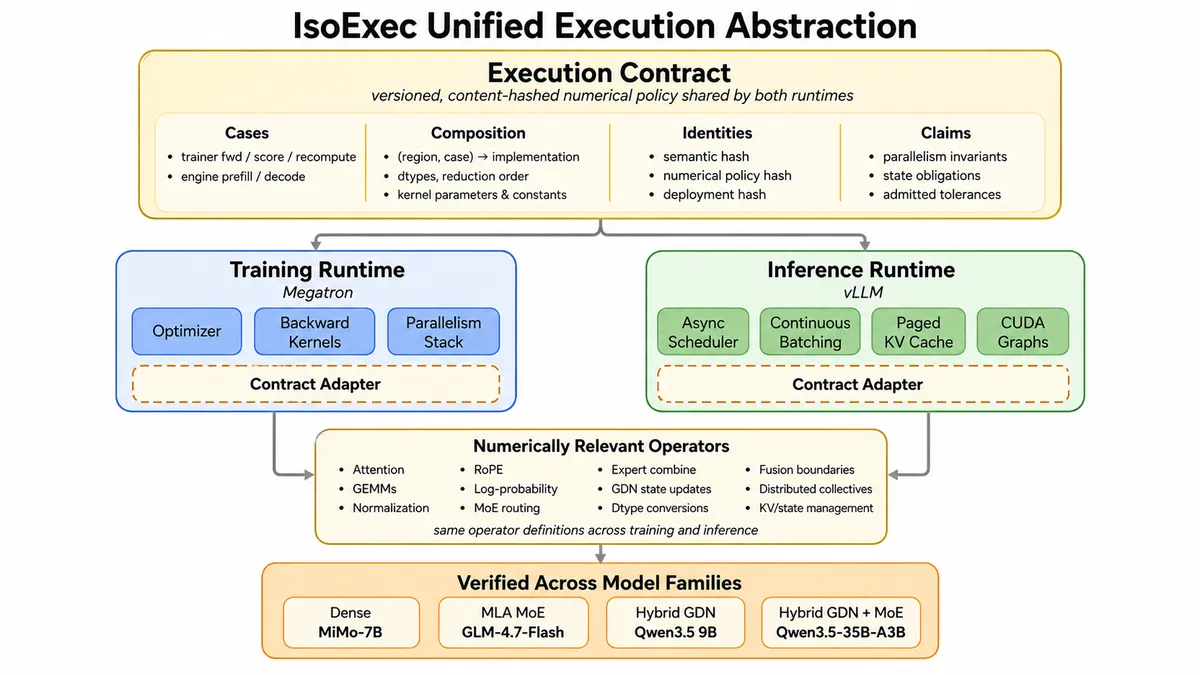
A vLLM bemutatta az IsoExecet, a SkyRL-hez készült egységes végrehajtási absztrakciót, amely a megerősítéses tanulás tréning- és következtetési motorjai közötti eltéréseket kezeli. A megoldás célja, hogy a két rendszer ugyanazt a numerikus végrehajtást használja, így kiszámíthatóbbá váljon az on-policy RL.
- Az IsoExec a SkyRL tréning- és rollout-motorjainak numerikus egyeztetését célozza.
- A rendszer végrehajtási szerződést és egységes modellt használ.
- A szerződés a kerneleket, adattípusokat és redukciós paramétereket is rögzíti.
- A vLLM négy különböző modellen nulla, szerződéssel lefedett eltérést jelentett.
- A Qwen3.5-35B-A3B DAPO-tesztben 25 százalékos többletterhelést mértek 50 lépés alatt.
Külön motorok okozhatnak eltérő valószínűségeket
Az on-policy megerősítéses tanulásban a rendszer először egy rollout motorral mintavételez tokeneket az aktuális szabályzat, vagyis policy alapján, majd a tréner újraszámolja ezek logaritmikus valószínűségét ugyanazokkal a modellparaméterekkel. Elméletben a két számításnak azonos eredményt kellene adnia.
A gyakorlatban a rollout és a tréning gyakran eltérő rendszeren fut. A vLLM és az SGLang következtetésre optimalizált motorok, míg a Megatron és az FSDP tréningrendszerek. Különbözhetnek a modelldefiníciók, a kernelek, a kötegméretek, a végrehajtási módok és a párhuzamosítási elrendezések. A lebegőpontos összeadás nem asszociatív, ezért az eltérő redukciós sorrendek akkor is más tokenvalószínűségeket eredményezhetnek, ha matematikailag ugyanazt a modellt hajtják végre.
A vLLM szerint ez megnehezíti az új RL-algoritmusok, a környezetek és a futtatási keretrendszerek változtatásainak, valamint az új hardveres kernelek hibakeresését. A forrás a ByteDance VeXact tanulmányára is hivatkozik, amely szerint az eltérés destabilizálhatja a REINFORCE és a GRPO futásait.
Szerződés és közös modell
Az IsoExec két fő összetevőre épül. Az első egy keretrendszerektől független végrehajtási szerződés, amely rögzíti a kerekítést befolyásoló részleteket. Ide tartozik többek között a kernel megvalósítása, az akkumulációs adattípus, a határértékek adattípusa, valamint a redukció felbontását meghatározó paraméterek.
A szerződés minden token logprob-számítását külön esetként kezeli, például a tréner előreirányú számítását, a rollout motor előtöltését és a dekódolást. A modell műveleteit régiókra osztják, majd minden régió és végrehajtási eset párosához rögzítik a használható implementációt és az állandókat. Egy kernel csak akkor kerülhet be a rendszerbe, ha a különböző esetek között bitpontos egyezésre validálták.
A futás közbeni ellenőrzés a tényleges párhuzamosítási méreteket, a telepített kerneleket, a deklarált garanciákat és a folyamatok közötti azonosítókat is vizsgálja. Az SHA-256 kivonatokkal a rendszer ellenőrzi, hogy a tréner és a rollout motor ugyanazt a szemantikai és numerikus szabályzatot használja.
A második összetevő egy egységes modell. A SkyRL-ben ez kötegméret-invariáns GEMM-, figyelmi és normalizációs kerneleket, determinisztikus MoE-útválasztást és kombinációt használ. A modell tenzor-, expert- és szekvenciapárhuzamos konfigurációk mellett is bitpontos konzisztenciára törekszik.
SkyRL, vLLM és Megatron együtt
A vLLM az IsoExecet a SkyRL-ben, vLLM és Megatron használatával valósította meg. Az egységes modell a vLLM olyan motorfunkcióival is együttműködik, mint az ütemező, a KV-cache kezelője és a CUDA-gráfok rögzítése, miközben a Megatron tréningveremébe illeszkedik.
A megoldást a forrás szerint sűrű MiMo-7B, MLA MoE GLM-4.7-Flash, hibrid Qwen3.5-9B és hibrid MoE Qwen3.5-35B-A3B modelleken alkalmazták. A tréning során ezeknél a modelleknél nulla, szerződéssel lefedett eltérést értek el.
Az IsoExec része egy chunkwise-parallel recurrent, vagyis darabokban párhuzamosított rekurrens algoritmus is a Gated DeltaNet hibrid architektúrákhoz. Ennek célja a tréning, az előtöltés és a rekurrens dekódolás összehangolása anélkül, hogy a hosszú szekvenciák előreirányú számítását sorosítani kellene.
Mérési eredmény és jelentőség a fejlesztőknek
A vLLM egyetlen, 8×H100 GPU-t tartalmazó csomóponton vizsgálta az IsoExecet szinkron Qwen3.5-35B-A3B DAPO-tréninggel. A közlemény szerint az átlagos, rollout és tréning közötti logprob-eltérést a megadott küszöb alá csökkentették, miközben 50 lépés alatt a jelenlegi SkyRL-alapvonalhoz képest 25 százalékos többletterhelést mértek.
Az IsoExec a vLLM szerint olyan alapot adhat, amely mellett az RL-algoritmusok, a környezetek, a futtatási keretrendszerek és az infrastruktúra módosításai kisebb numerikus bizonytalanság mellett vizsgálhatók. A megvalósítás elérhető a SkyRL-IsoExec GitHub-tárolóban.

