A Jev 3,8-szor gyorsabb és 3,5-szer olcsóbb bírómodellnek bizonyult
A TypeSafe AI Jev modellje 1000 valós termelési fordulaton 3,5-szer olcsóbb és 3,8-szor gyorsabb volt, mint a Comet által használt gpt-4o-mini bírómodell. A két modell 897 esetben azonos eredményt adott, a teszt pedig azt is megmutatta, mikor érdemes emberi ellenőrzést kérni.
- A Jev 1000 valós fordulaton 89,7 százalékban egyezett a gpt-4o-mini bíróval.
- A tesztben a Jev költsége 0,0285 dollár volt 1000 nyomra.
- A Jev medián késleltetése 253 ezredmásodpercet ért el.
- A modell valószínűséget ad, így a bizonytalan esetek emberhez irányíthatók.
- A teszt nem állapította meg, melyik bírómodell volt helyes.
A Jev egyszerű eldöntendő kérdésekre válaszol
Az LLM-as-a-Judge módszerben egy nyelvi modell értékeli egy másik modell válaszait. A Comet szerint ez két problémát okoz: a fejlett modellek költsége miatt a csapatok gyakran csak a forgalom egy részét vizsgálják, és ritkán ellenőrzik, hogy maga a bírómodell helyesen dönt-e.
A TypeSafe AI Jevje más megközelítést használ. Szöveges magyarázat helyett típusos kérdésekre válaszol egy adott szövegről, például arra, hogy egy válasz megoldotta-e a felhasználó kérdését. Eredményként valószínűséget ad, így nincs szükség szöveg feldolgozására, séma kikényszerítésére, illetve hőmérséklet vagy véletlenszám beállítására. A forrás szerint a modell csak az általa elolvasott tokenek után számláz, tokenenként 0,042 dollár per millió egység áron.
A Jev az ilyen feladatokra készült, kisebb modellként jelenik meg a Comet értékelése szerint. A vállalat a megközelítést korábbi specializált modellekhez hasonlítja, például a beágyazásokhoz, az újrarangsoroláshoz és a moderáláshoz használt modellekhez.
Az Opikban éles forgalmon is mérhető
A Jev a Comet nyílt forráskódú Opik platformján közvetlenül támogatott modell. Az Opik rögzíti az alkalmazások nyomkövetési adatait, kezeli az értékelési adatkészleteket, és ugyanazokon a nyomokon képes több bírót összehasonlítani, miközben a költséget és a késleltetést is eltárolja.
A Jev két fő módon használható. Az alkalmazáson belüli döntések, például útválasztás, osztályozás vagy moderálás esetén a TypeSafe kliens natív Opik-integrációval követhető. Ilyenkor minden rendszerhívás tartalmazza a bemenetként használt állapotot és kérdéseket, a választ, valamint a tokenhasználatot, a szolgáltatót és a költséget.
A gyakoribb esetben a Jev magát az alkalmazást értékeli. Az Opik online értékelési szabályában az OpenRouter szolgáltatón keresztül választható ki a typesafe/jev-1.13 modell. A beállítás Boolean pontszámokra korlátozódik, egy szöveges felhasználói üzenettel. A 0,5 vagy annál nagyobb valószínűség 1-es eredményt tárol, miközben a pontos valószínűség az indoklásban is megmarad.
A kérdés megfogalmazása különösen fontos, mivel a Jev nem használ hőmérsékletet vagy néhány példán alapuló tanítást. Az Opik Agent Optimizer hat beépített optimalizálási algoritmussal képes kérdésváltozatokat keresni címkézett adatokon. Az optimalizáló modell csak a kérdéseket írja, az értékelést továbbra is a Jev végzi.
1000 Ollie-fordulaton mérték össze a két bírót
A Comet az Opikba épített Ollie AI-asszisztens 578 beszélgetési szálából választott ki 1000 valós termelési fordulatot. A fordulatokat külön projektbe naplózták, hogy a gpt-4o-mini és a Jev ugyanazokat az adatokat értékelje. Mindkét modell 100 százalékos mintavételezéssel, ugyanazzal az eldöntendő kérdéssel dolgozott: „A válasz foglalkozik a feltett kérdéssel?”
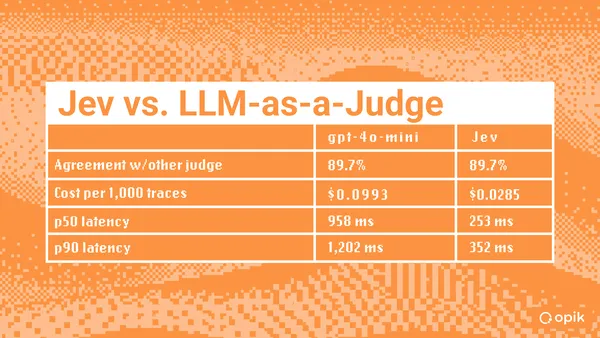
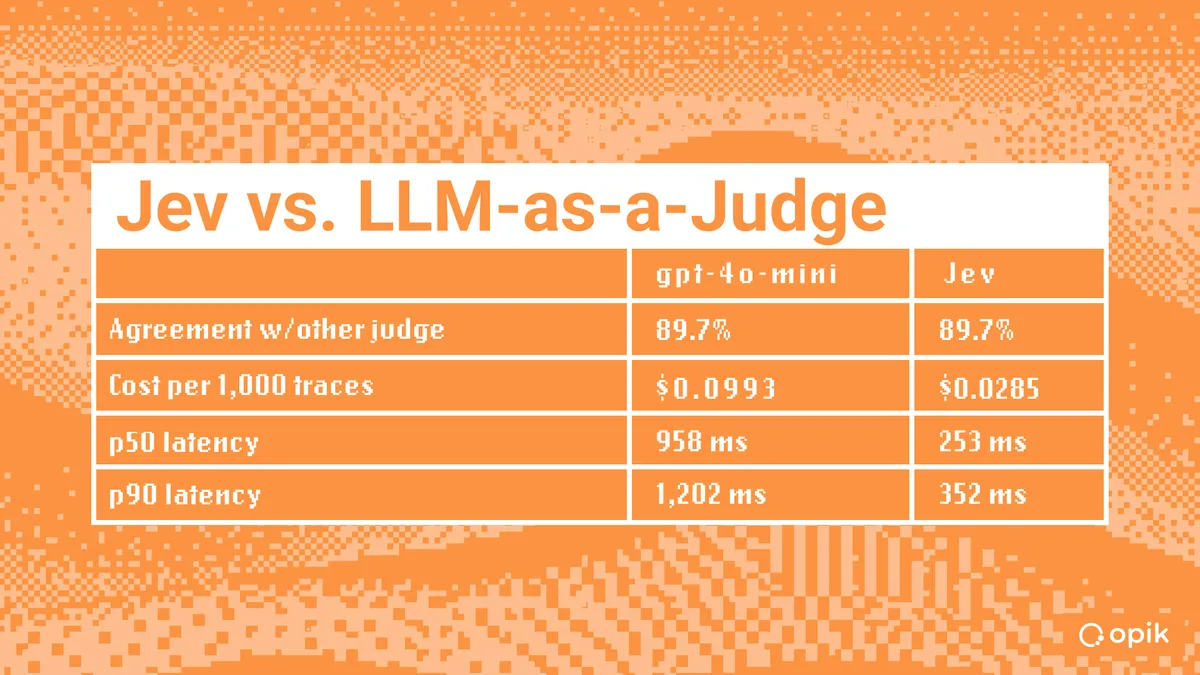
- A két modell 897 esetben értett egyet, az egyezési arány 89,7 százalék volt.
- 1000 nyom költsége a gpt-4o-mini esetén 0,0993 dollár, a Jevnél 0,0285 dollár lett.
- A medián késleltetés a gpt-4o-mini-nál 958 ezredmásodperc, a Jevnél 253 ezredmásodperc volt.
- A 90. percentilisben a késleltetés 1202, illetve 352 ezredmásodpercet ért el.
A Jev 1,5-szer több bemeneti tokent küldött, mégis olcsóbb és gyorsabb maradt a tesztben. A Comet szerint ennek oka, hogy a Decisions API a kérdés szerkezetét a szöveg mellett kódolja.
A bizonytalan esetekből emberi ellenőrzési sor készülhet
A két bíró 103 fordulaton tért el egymástól. Ezek 64,1 százalékában a Jev valószínűsége 0,3 és 0,7 közé esett, miközben az egyező eseteknek csak 16,7 százaléka tartozott ebbe a sávba. A 0,4 és 0,6 közötti tartományban 63,5 százalékos volt az egyezés, míg a 0,2 alatti eredményeknél 118 esetből mind a 118 alkalommal egyetértett a két modell. A 0,8 feletti értékeknél 568 esetből 95,6 százalékban egyeztek.
A Comet szerint a Jev valószínűsége értékesebb lehet, mint önmagában az igen vagy nem válasz. A középső, bizonytalan sávba eső esetek emberhez irányíthatók, így a csapat nem véletlenszerű mintavételezéssel keres hibákat. A teszt ugyanakkor nem bizonyította, hogy a két bíró közül melyik döntött helyesen. Ehhez címkézett adatok és előre rögzített értékelési szabály szükséges.
A forrás alapján a Jev akkor illeszkedik jól egy rendszerbe, ha a döntés eredménye egy műszerfalat, szűrőt vagy útválasztást tápláló szám. Ha a felhasználónak írásos kritika, eszközhasználat vagy összetettebb, szöveges értékelés kell, a generatív bírómodell megtartása lehet indokolt.
Comet: Jev vs. LLM-as-a-Judge for AI Evals