A Jev 3,5-szer olcsóbb és 3,8-szer gyorsabb bírómodellnek bizonyult
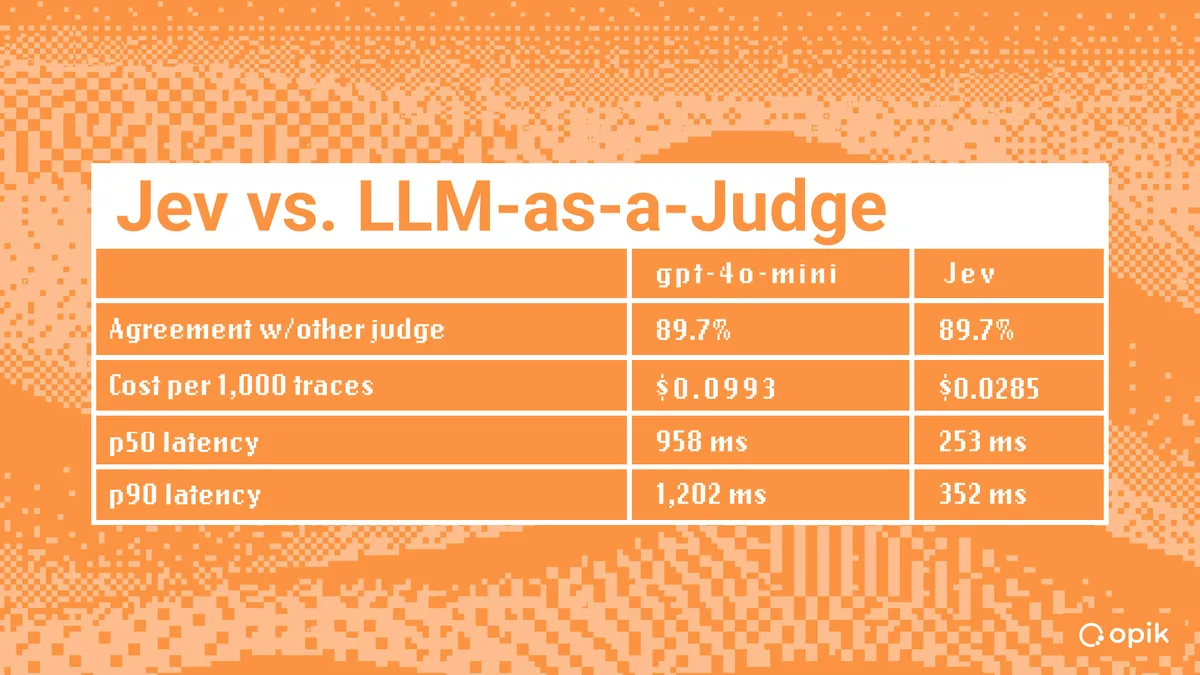
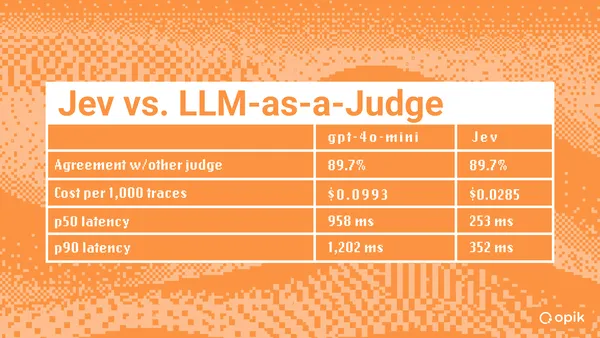
A TypeSafe AI Jev modellje 1000 valódi termelési interakción 3,5-szer olcsóbbnak és mediánban 3,8-szer gyorsabbnak bizonyult, mint a Comet által használt gpt-4o-mini bírómodell. A két rendszer 897 esetben azonos eredményre jutott.
- A Jev 1000 tesztelt esetből 897-ben egyezett a gpt-4o-mini bíróval.
- A Jev költsége 0,0285 dollár volt 1000 nyomra, szemben a gpt-4o-mini 0,0993 dollárjával.
- A medián késleltetés 253 milliszekundum volt a Jevnél és 958 milliszekundum a gpt-4o-mininál.
- A Jev valószínűségi eredményei alapján bizonytalan esetek külön emberi ellenőrzésre küldhetők.
- A Comet nem állapította meg, hogy a két bíró közül melyik adott helyes ítéletet.
A Jev számmal válaszol a szöveges értékelési kérdésekre
Az LLM-as-a-Judge módszerben egy nagy nyelvi modell értékeli egy másik modell vagy alkalmazás válaszait. A Comet szerint ez két problémát vet fel: a nagy modellek költsége miatt a csapatok gyakran csak a forgalom egy részét vizsgálják, miközben éppen a ritka hibák kiszűrése lenne a cél. Emellett az értékelő modell helyességét is ritkán ellenőrzik.
A TypeSafe AI Jev modellje más megközelítést használ. Szöveges értékelés helyett típusos kérdésekre válaszol, például arra, hogy egy válasz megválaszolta-e a felhasználó kérdését. Az eredmény egy valószínűség, nem pedig egy hosszú indoklás. A Comet szerint így nincs szükség a válasz feldolgozására vagy séma betartatására, és a modell csak az általa beolvasott tokenekért számláz. A megadott díj 0,042 dollár egymillió tokenenként.
A Jev az Opik, a Comet nyílt forráskódú megfigyelési és értékelési platformjának közvetlenül támogatott modellje. Az Opik rögzíti az alkalmazások nyomkövetési adatait, tárolja az értékelési adathalmazokat, és ugyanazokon a nyomokon tud több bírót összehasonlítani.
1000 Ollie-interakción mérték össze a modelleket
A Comet csapata az Opikban működő Ollie AI-asszisztens 578 beszélgetési szálából vett 1000 valódi termelési fordulót. Az Ollie nyomokat elemez, problémákat azonosít és javításokat javasol. A tesztben a gpt-4o-mini és a Jev ugyanazt a kérdést kapta: „A válasz foglalkozik a feltett kérdéssel?” Mindkét modellt 100 százalékos mintavételezéssel, egyetlen logikai értékeléssel futtatták.
A gpt-4o-mini 1000 nyomra vetített költsége 0,0993 dollár volt, a Jevé 0,0285 dollár. A medián késleltetés 958, illetve 253 milliszekundumot tett ki. A 90. percentilisnél a két érték 1202 és 352 milliszekundum volt. A Jev 1000 esetből 897-ben értett egyet a másik bíróval, ami 89,7 százalékos egyezést jelent.
A Comet szerint a Jev 1,5-szer több bemeneti tokent küldött, mégis olcsóbb és gyorsabb lett. Ennek okaként azt említik, hogy a Decisions API a kérdés szerkezetét a szöveggel együtt kódolja. A vállalat szerint a tesztben a valószínűség fontosabb információt adott, mint az önmagában álló igen vagy nem válasz.
A bizonytalan válaszokból emberi ellenőrzési sor készíthető
A két bíró 103 eltérő eredményt adott. Ezek 64,1 százalékánál a Jev valószínűsége 0,3 és 0,7 közé esett, míg az egyező eseteknél ez az arány 16,7 százalék volt. A 0,2 alatti tartományban a két modell 118 esetben 100 százalékban egyetértett. A 0,8 feletti tartományban 568 esetből 95,6 százalékos volt az egyezés. A 0,4 és 0,6 közötti sávban, 115 eset alapján, 63,5 százalékra csökkent.
A Comet hangsúlyozza, hogy a teszt nem bizonyította, melyik bíró volt helyes. Ehhez címkézett adatokra van szükség, és előbb azt is meg kell határozni, pontosan milyen szabály szerint értékelik a válaszokat. A cég példaként említi, hogy az Ollie esetében egy udvarias elutasítást is hibának számolt a kérdés, miközben ez a szabály nem feltétlenül írta le megfelelően az alkalmazás hatókörét.
A Jev valószínűségi eredménye ugyanakkor felhasználható a munkafolyamatok irányítására. A bizonytalan tartományba eső válaszokat emberi felülvizsgálatra lehet küldeni, a magabiztosabb eredményeket pedig külön kezelni. A modell akkor illeszkedik leginkább a feladathoz, ha a rendszer egy számot használ irányítópulton, szűrőben vagy útválasztásban. Ha viszont ember olvassa az indoklást, eszközhívásokra vagy összetett értékelésre van szükség, a szöveget generáló bírómodell lehet megfelelőbb.
Comet: Jev vs. LLM-as-a-Judge for AI Evals