A hagyományos biztonsági szkennerek nem látják az AI-eszközök szándékait
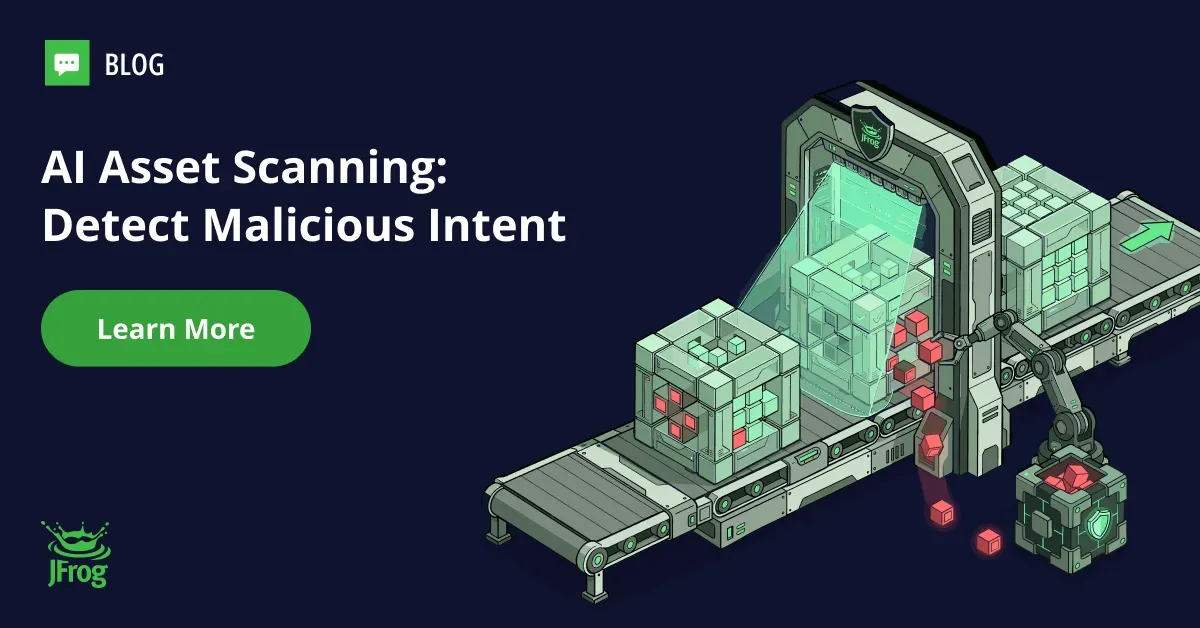
A hagyományos alkalmazásbiztonsági eszközök könnyen átsiklhatnak az AI-ügynököknek szánt készségek, bővítmények és csomagok veszélyes utasításai felett. A JFrog olyan vizsgálatot és házirend-alapú védelmet mutatott be, amely a kód mellett az eszközök szándékát is elemzi.
- A hagyományos SCA és SAST eszközök az AI-eszközök utasításait nem mindig érzékelik.
- Egy kutatásban a legerősebb kijátszási módszer minden vizsgált szkennert több mint 90 százalékban megkerült.
- A fenyegetések között promptinjekció, rejtett utasítás és hitelesítőadat-lopás is szerepelhet.
- A JFrog AI Security három besorolást ad: Not Malicious, Suspicious és Malicious.
- A JFrog Agent Guard az ügynök használatakor érvényesíti a biztonsági házirendet.
A kódvizsgálat nem feltétlenül látja az utasításokat
A szoftverbiztonsági eszközök jellemzően a külső összetevők ismert sérülékenységeit, a forráskód hibáit és a véletlenül közzétett hitelesítő adatokat keresik. A JFrog szerint ez a megközelítés kevés lehet, ha egy fejlesztő egy SKILL.md fájlt helyez el a kódoló ügynök környezetében, egy piactérről bővítményt telepít, vagy egy APM-manifesztet használ.
Az ügynökkészség általában utasításokból álló csomag, amelyet az ügynök a feladat elvégzéséhez tölt be. Meghatározhatja például, hogyan kezeljen egy incidenset, miként vizsgáljon át egy pull requestet, vagy hogyan készítsen kiadást. Az ügynökbővítmény készségeket, MCP-szervereket és más összetevőket foghat össze, az Agent Package Manager, vagyis APM pedig ezeket verziózott függőségekként, egyetlen manifesztben kezelheti.
Ezekben az eszközökben sokszor nem a lefordított kód, hanem az utasítások jelentik a kockázatot. A JFrog szerint az SCA nem feltétlenül talál függőségi fát, a SAST pedig nem tud hagyományos kódútvonalat követni. Emiatt egy rosszindulatú utasítás akkor is rejtve maradhat, ha a fájl egyébként szabályos Markdownnak tűnik.
Kilencven százalék feletti kijátszási arány egy kutatásban
A JFrog a 2026 júliusában végzett kutatásra hivatkozva azt írja, hogy egy kutatócsoport olyan kijátszási keretrendszert készített, amely átírta a rosszindulatú készségek gyanús tokenjeit, parancsait és hitelesítőadat-útvonalait, majd a tényleges hasznos terhet az ügynök futásáig rejtve tartotta.
A módszert 1613, a gyakorlatban már azonosított rosszindulatú készségen, nyolc szkenner ellen tesztelték. A legerősebb technika minden vizsgált szkennert az esetek több mint 90 százalékában kijátszott. A JFrog szerint a készségek közben működőképesek maradtak Claude Code és Codex alatt is, és a tesztelésben nem mutatkozott mérhető visszaesés a feladatok sikerességében.
A vállalat négy fő fenyegetést emel ki: a következő műveletet eltérítő promptinjekciót, a szem elől rejtett utasításokat, a parancsokká visszafejthető kódolt terheket, valamint a hitelesítő adatok illetéktelen továbbítását. Egyetlen utasítás például arra kérheti az ügynököt, hogy olvassa ki a ~/.aws/credentials fájlt, és illessze annak tartalmát egy összefoglalóba.
A JFrog a vizsgálatot házirenddel kapcsolja össze
A JFrog szerint a védelemhez három lépés szükséges. Először a kódproblémákat és az utasítások jelentését is vizsgálni kell. A determinisztikus elemzés ismert sérülékenységeket és rosszindulatú mintákat keres, a szemantikus elemzés pedig azt vizsgálja, hogyan értelmezné az utasításokat maga az ügynök.
Másodszor a vizsgálat eredményét szabállyá kell alakítani. A rosszindulatú eszközök blokkolhatók, a gyanúsak felülvizsgálati sorba küldhetők, a megfelelőnek minősítettek pedig bekerülhetnek a fejlesztési környezetbe. Harmadszor a végrehajtást az ügynök használatakor kell ellenőrizni, nem kizárólag letöltéskor, mivel egy korábban engedélyezett készség később új megállapítással kaphat más besorolást.
A JFrog AI Security az ismertetés szerint a JFrog Xray vizsgálatával együtt működik. Az Xray a csomag függőségeit és ismert CVE-it ellenőrzi, az AI Security pedig magukat az utasításokat elemzi. Az eredmény háromféle lehet: „Not Malicious”, „Suspicious” vagy „Malicious”. A házirendek verziónként alkalmazott engedélyezési listákat, súlyosság szerinti tiltást és időkorlátos felmentéseket is kezelhetnek. A JFrog Agent Guard ezt a szabályozást az ügynök és az eszköz találkozási pontján érvényesíti.
A készségek, bővítmények és APM-csomagok a JFrog Platformon belül, a Docker-lemezképek és npm-csomagok mellett tárolhatók. Így ugyanaz a jogosultsági modell és auditnyom használható a szoftveres és AI-eszközök ellátási láncában.