Kutatás
A kontrollcsoport szerint 28 százalékkal nőtt a Google Shopping bevétele
A Lily AI kontrollált tesztjeiben a terméknyelv átírása 28 százalékkal növelte a Google Shopping bevételét a változatlan kontrollcsoporthoz képest. A Meta Advantage+…
A turbulencia kisebb léptékű folyamatait modelleznék mesterséges intelligenciával
Mesterséges intelligenciával javítaná a turbulens áramlások kisebb léptékű folyamatainak előrejelzését egy amerikai kutatócsoport. A módszer gyorsabb és robusztusabb…
Új mesterszakot indít a Berkeley a mesterséges intelligenciáról
A UC Berkeley 2027 őszén indítja Master of Artificial Intelligence and Machine Learning képzését, amelyet STEM-végzettségű hallgatóknak szán. A két féléves, teljes idejű…
Miért buknak el a frontier AI-ügynökök a valódi mérnöki munkán?
A Terminal-Bench 3.0 legjobb modellje, Claude Opus 5 is csak 43,5 százalékos eredményt ér el az új teszten. A Snorkel AI két feladaton keresztül mutatja be, miért nehéz…
Alkalmazkodó hangokat terveznek beltéri szállítórobotoknak
A NAVER LABS Europe kutatói olyan alkalmazkodó navigációs hangok koncepcióját vizsgálták, amelyek segíthetnek a beltéri szállítórobotok észlelésében. A cél, hogy a…
MIT-algoritmus készít forgatókönyveket ritka szélsőséges eseményekre
Az MIT News 2026. augusztus 24-én számolt be arról, hogy MIT-mérnökök új algoritmust fejlesztettek szélsőséges, korábban nem látott események modellezésére. A módszer…
Gyors AI-átállást várnak a jogi szakemberek a következő két évben
A jogi szakemberek 72,5%-a már használ generatív mesterséges intelligenciát, vagy a következő két évben tervezi bevezetni. A DISCO és a The Cowen Group felmérése szerint…
Apple-kutatás: a CoT-válaszokban a gondolatmenet hatása gyakran ugrásszerű
A chain-of-thought módszer nem egyenletesen viszi közelebb a nagy nyelvi modelleket a jó válaszhoz: az Apple kutatói szerint a gondolatmenetekben kitérők, hirtelen…
Az Apple kutatói adaptív gondolkodási módszert mutattak be LLM-ekhez
Az Apple kutatói olyan módszert ismertettek, amely előre megbecsüli, mennyi köztes gondolkodásra van szüksége egy nagy nyelvi modellnek egy adott kérdésnél. A Sonata…
A Liquid AI Pipette-t adott ki az eszközön futó AI-modellek mérésére
A Liquid AI és az Artificial Analysis nyílt forráskódú benchmarkrendszert indított az eszközökön futó AI-modellek vizsgálatára. A Pipette a sebességet, késleltetést…
Kutatási eredményeket mutat be egy díjazott videó és hálózati mű
Az ARC Centres of Excellence Creative Communication Competition versenyén az Automated Decision-Making and Society központ kutatói első és második helyet szereztek két…
Egérkísérletben bizonyított egy izomkímélő fogyókúrás vegyület
A UC Berkeley kutatói egy olyan molekuláris vegyületet vizsgáltak, amely az étvágy csökkentése helyett a sejtek energiafelhasználását növeli. A TOFA egerekben fogyást…
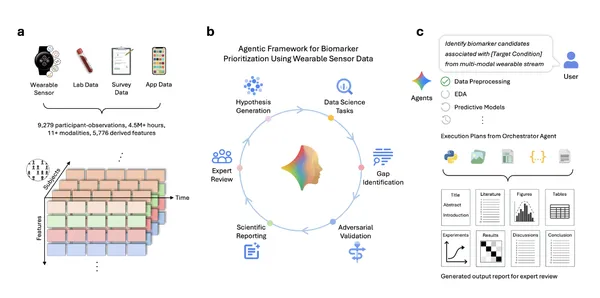
Google Research AI-eszközt mutatott be viselhető szenzoros biomarkerekhez
A Google Research 2026. augusztus 21-én bemutatta a Biomarker Discovery Framework nevű többügynökös AI-rendszert. Az eszköz viselhető szenzorok idősoros adataiból segít…
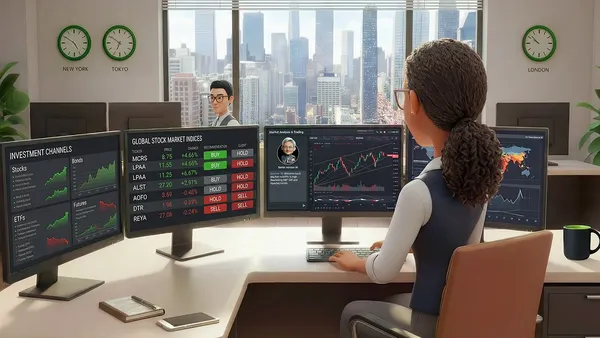
NVIDIA: GPU-kon skálázható a pénzügyi instrumentumok klaszterezése
Az NVIDIA Developer 2026. augusztus 21-én mutatta be az AdaptGrow nevű, GPU-gyorsított SymNMF megoldóra épülő munkafolyamatot. A cél pénzügyi instrumentumok nagy léptékű…
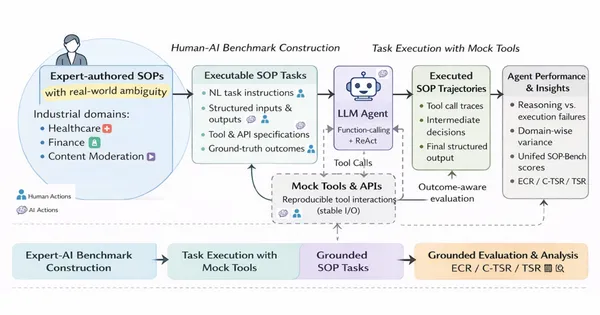
Az Amazon új tesztje valódi üzleti eljárásokon vizsgálja az AI-ügynököket
Az Amazon Science bemutatta az SOP-Bench nevű nyílt benchmarkot, amely AI-ügynököket valódi, szakértők által összeállított üzleti eljárások végrehajtásán keresztül…
Az NVIDIA AVO 100 százalékot ért el az ARC-AGI-3 nyilvános tesztjén
Az NVIDIA Developer 2026. augusztus 21-én közölte, hogy az Agentic Variation Operators, röviden AVO kutatási projekt 100.00 RHAE pontszámot ért el az ARC-AGI-3 nyilvános…
KutatásGoogle DeepMind az EVE Online világában kutatja a játékos AI-ügynököket
A Google DeepMind 2026. augusztus 21-én ismertette, hogyan épít 15 év játékokra támaszkodó AI-kutatására. A vállalat újabb prototípusokon dolgozik játékfejlesztőkkel…
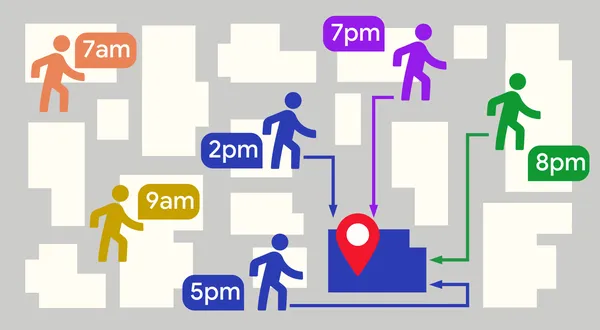
A Google szerint a mobilitási adatok jobb helyismeretet adhatnak az AI-modelleknek
A Google Research 2026. augusztus 21-én mutatta be a Mobility-Embedded POIs, röviden ME-POIs nevű keretrendszert. A megközelítés nyelvi modellek helyreprezentációit…
Új benchmark méri, valóban tanulnak-e az AI-rendszerek a tapasztalatból
A Continual Learning Bench azt méri, hogy az LLM-alapú rendszerek valóban javulnak-e a egymást követő feladatok során szerzett tapasztalatoktól. A Berkeley kutatója…
Nyílt modellel követték vissza, miből tanulhat társas következtetést egy LLM
Az Ai2 2026. augusztus 21-én számolt be arról, hogy a Georgia Tech két kutatója az Olmo 3 nyílt eszköztárával vizsgálta egy nyelvi modell társas következtetésének…
Hugging Face-blogposzt a beszédfelismerési benchmarkok méréséről
A Hugging Face 2026. augusztus 21-én közölt blogposztot „Measuring benchmark optimization in speech recognition” címmel. A bejegyzés az automatikus beszédfelismeréshez…
A GLM-5.3 olcsóbban hoz több megoldást, ha lehet újrapróbálkozni
A GPT-5.6 Sol pontosabb első próbálkozásra a DeepSWE programozási feladatain, a GLM-5.3 viszont olcsóbb, több próbálkozással megelőzi, és a két modell együtt adja a…
KutatásAz Anthropic feltárta, hogyan torzíthatják a nyelvi modellek súlyai az értelmezést
Az Anthropic kutatói egy egyrétegű transzformerben vizsgálták, hogyan különíthetők el a modell ténylegesen hasznos kapcsolatai az értelmezést zavaró, úgynevezett…
Az OpenRouter vizuális tesztekkel hasonlítja össze a képgeneráló modelleket
Az OpenRouter vizuális kép-benchmarkot indított, amellyel a platformon elérhető képgeneráló modellek képességei hasonlíthatók össze. A tesztek 39 modellt vizsgáltak 2026…