Az Amazon új tesztje valódi üzleti eljárásokon vizsgálja az AI-ügynököket
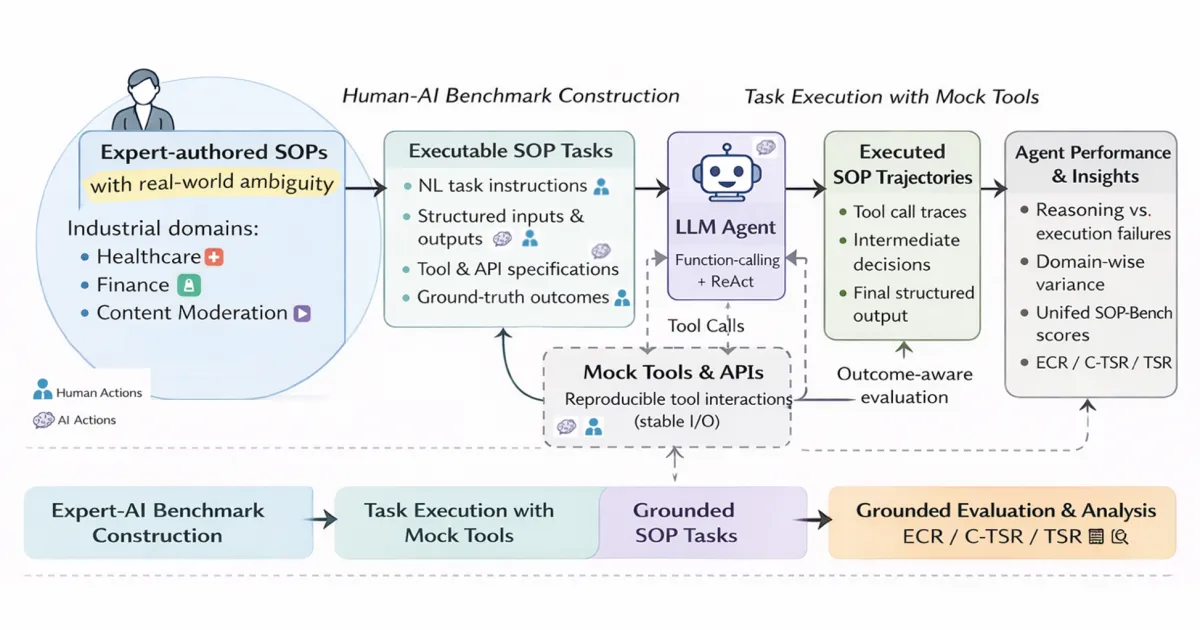
Az Amazon Science bemutatta az SOP-Bench nevű nyílt benchmarkot, amely AI-ügynököket valódi, szakértők által összeállított üzleti eljárások végrehajtásán keresztül értékel. A rendszer több mint 2000 feladatot, működő eszközöket és ellenőrizhető helyes válaszokat kínál.
- Az SOP-Bench 12 üzleti területen több mint 2000 feladatot tartalmaz.
- A benchmark működő eszközökkel és ismert helyes válaszokkal értékeli az ügynököket.
- A feladatokat szakértők által készített valódi működési eljárásokra építették.
- Az Amazon szerint az újabb modellek és a több eszköz nem garantál jobb eredményt.
- A keretrendszer saját ügynökökkel és eljárásokkal is bővíthető.
A valódi munkafolyamatok összetettebbek a tesztkérdéseknél
A standard működési eljárás, vagyis SOP (standard operating procedure), egy szervezet által követett írásos lépéssor egy fontos, rendszeresen végzett feladat elvégzésére. Ilyen eljárásokat használnak többek között a kórházak a betegek regisztrációjához, a logisztikai csapatok a veszélyes szállítmányok besorolásához, a bankok az új üzleti ügyfelek ellenőrzéséhez, valamint a tartalommoderációs csapatok a bejegyzések eltávolításáról szóló döntésekhez.
Az Amazon szerint a meglévő ügynökbenchmarkok gyakran egyetlen képességet mérnek, például a megfelelő API kiválasztását, a szabályok betartását vagy egy feladatsor megtervezését. Ezek a tesztek gépileg jól formázott, egyértelmű utasításokra épülnek, miközben a valódi SOP-k több eszköz összehangolt használatát, a korábbi lépések nyomon követését, a bizonytalan megfogalmazások értelmezését és a hibás helyzetek kezelését is megkövetelhetik.
Az Amazon egy betegfelvételi példán keresztül szemléltette a problémát. Egy eljárás kétszer is előírhatja a biztosítás ellenőrzését, anélkül hogy pontosan megmagyarázná, miért van erre szükség. A területen dolgozó ember tudhatja, hogy az egyik ellenőrzés a biztosítóval, a másik pedig az egészségügyi szolgáltató rendszerében rögzített adatokkal kapcsolatos. Egy AI-ügynöknek ezt a háttértudást és a hasonló nevű eszközök közötti különbséget is kezelnie kell.
Tizenkét üzleti terület és több mint 2000 feladat
Az SOP-Bench tizenkét üzleti területet fed le. Ezek között szerepel a betegfelvétel az egészségügyben, a veszélyes áruk osztályozása, az ügyfélszolgálat, a tartalommoderáció, a pénzügyi megfelelés és a raktári ellenőrzés. A benchmarkban összesen több mint 2000 feladat található.
Minden feladathoz tartozik az eljárás szövege, a használható eszközök és azok specifikációi, valamint a helyes eredményt rögzítő tesztesetek. Az ügynök a feladat végrehajtása közben eszközöket hív meg, a rendszer pedig a munkáját ismert válaszokhoz hasonlítja. Így az értékelés a teljesített eljárás eredményére épül, nem arra, hogy egy automatikus osztályozó elfogadhatónak találja-e az ügynök szöveges válaszát.
A benchmark keretrendszerként működik, ezért a csapatok saját ügynökeiket is beilleszthetik, és saját eljárásokkal is bővíthetik. A rendszer rögzíti az eszközhívásokat és a döntések mögötti gondolatmenetet, az eredményeket pedig reprodukálható módon értékeli. A hibák így visszakövethetők azokhoz a lépésekhez, amelyeknél bekövetkeztek.
Szakértők ellenőrizték az AI által létrehozott tesztkörnyezetet
Az Amazon a procedúrák eredeti változatait iparági szakértőkkel készítette el. Ezután az Anthropic Claude 3.5 Sonnet v2 modellje alakította az eljárásokat futtatható feladatokká, és létrehozta többek között az adatstruktúrákat, a szimulált API-kat, az eszközspecifikációkat, a kódot és az adatállományokat.
Az adatokban hétköznapi esetek mellett szélsőséges helyzetek és hibák is szerepeltek. Minden létrehozott elemet visszaküldtek a szakértőknek, akik ellenőrizték a logikát, javították az eljárásokat, átnézték az adatokat, majd a kód működését is tesztelték. Az Amazon közlése szerint a folyamat során nem használtak védett vagy érzékeny adatokat.
A benchmarkot a 2026-os Conference on Knowledge Discovery and Data Mining rendezvényen mutatták be. A közlemény szerint a keretrendszerhez két alapügynök is tartozik, amelyek kiindulópontként szolgálnak további fejlesztésekhez.
A nagyobb modell és több eszköz sem garantál jobb eredményt
Az Amazon két egyszerű ügynökfelépítést, egy függvényhívó és egy következtetésre építő ügynököt vizsgált tizenegy élvonalbeli modellen. A vállalat hangsúlyozza, hogy ezek alapvonalak, nem pedig a lehető legjobb rendszerek.
A kísérletek egyik megállapítása szerint az újabb modell nem minden esetben teljesített jobban. A közlemény azt is kiemeli, hogy további eszközök bevonása egyes helyzetekben csökkentheti a sikerességet, és egyetlen modell és ügynökkombináció sem bizonyult minden eljáráson kiemelkedőnek.
Az eredmények alapján az Amazon szerint az AI-ügynököket éles bevezetés előtt az adott feladatokra és eljárásokra szabottan kell értékelni. Az SOP-Bench ehhez kínál nyíltan elérhető keretet, amellyel a szervezetek saját folyamataikon is ellenőrizhetik, hogy egy ügynök képes-e megbízhatóan végrehajtani a teljes munkamenetet.
Amazon Science: SOP-Bench: A new benchmark for evaluating AI agents on real business procedures