A Databricks Lakebase másodpercek alatt készít PR-adatbázisokat
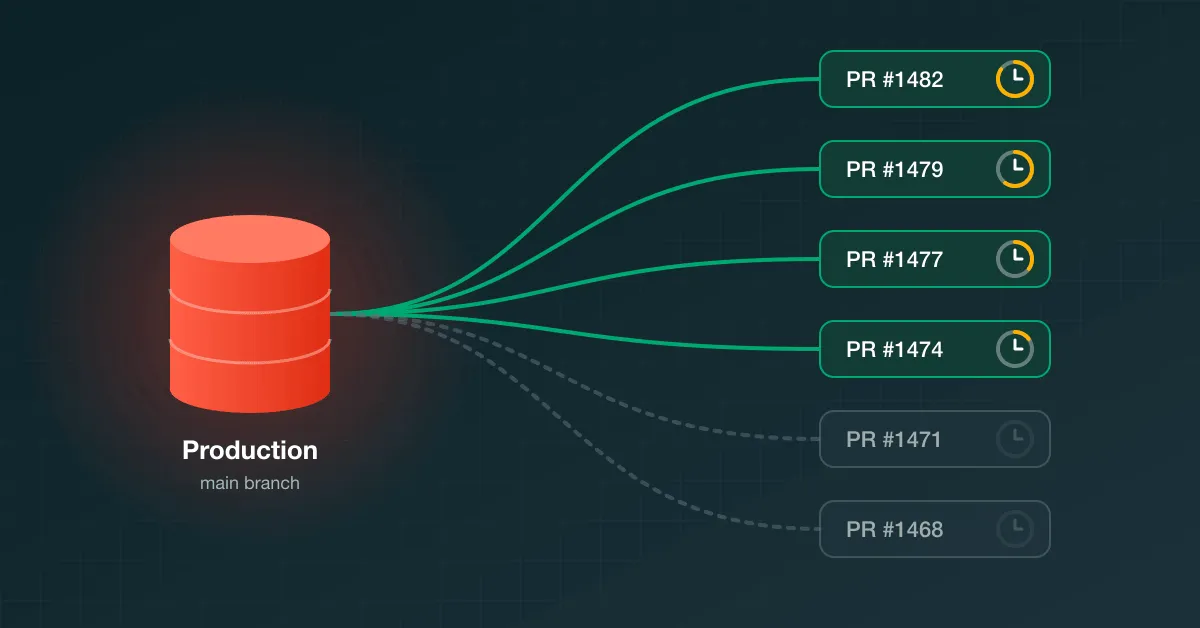
A Snorkel AI minden nyitott pull requesthez saját, írható Lakebase Postgres-ágat hoz létre, amely kevesebb mint egy perc alatt elkészül. A megoldás a több mint 20 perces adatbázis-visszaállítás helyett valódi produkciós adatokon teszi lehetővé a CI/CD-teszteket.
- A Snorkel AI minden nyitott pull requesthez külön Lakebase Postgres-ágat indít.
- Az új ág a forrás szerint p95 értékben 60 másodpercen belül elkészülhet.
- A copy-on-write technológia csak a módosított adatlapokat tárolja külön.
- Akár 100 párhuzamos PR-adatbázis is futhat, az ágak számítási kapacitása tétlenségkor nullára skálázódik.
- A TTL automatikusan törli a lezárt vagy elhagyott környezeteket.
A lassú adatbázis-másolat akadályozta a tesztelést
A Snorkel AI adatfejlesztési eszközöket készít mesterségesintelligencia-csapatoknak. A vállalat Kubernetesre épülő CI-folyamatában minden nyitott pull requesthez és egyedi commithez külön, ideiglenes Kubernetes-névtér tartozik. A fejlesztők ebben telepítik a saját águkat, majd a teljes tesztkészletet lefuttatják az összeolvasztás előtt.
A tesztek akkor a leghasznosabbak, ha valódi adatokkal futnak. A Snorkel AI produkciós adatbázisa Amazon Aurora PostgreSQL, ennek minden pull requesthez szükséges másolatát azonban körülbelül 20 perc volt elkészíteni. Ez túl lassú a naponta megnyitott pull requestekhez és az olyan összeolvasztási sorokhoz, amelyek minden futtatáshoz friss környezetet igényelnek.
A megosztott tesztadatbázisok, a szűkített tesztadatok és a szintetikus adatok közben visszahozhatják azokat a problémákat, amelyeket a produkcióhoz hasonló tesztelésnek kellene kiküszöbölnie. Ilyen az egymásba zavaró tesztelés, az elavult sémák és a valódi adatformák mellett jelentkező hibák.
Másodpercek alatt létrejön az elkülönített adatbázis
A Databricks szerint a Lakebase szerver nélküli Postgres-adatbázis, amely külön kezeli a tárhelyet és a számítási kapacitást. Ágai bármely időpontból létrehozhatók, és a Git-ágakhoz hasonlóan elkülönített, írható környezetet adnak.
A működés alapja a másolás íráskor (copy-on-write). Az új ág létrehozásakor nem másolódik le az adatbázis teljes tartalma. Az ág megosztja a szülő meglévő tárhelylapjait, és csak a módosított lapokból készül új példány. Így a létrehozás ideje nem függ az adatbázis méretétől.
A Databricks beszámolója szerint a Snorkel AI körülbelül 2,5 terabájtos produkciós adatkészlet mellett akár 100 párhuzamos PR-adatbázist is futtathat. Egy ág nagyjából 5 és 10 gigabájt közötti módosítást ír az alap fölé. Az egyes ágak számítási kapacitása automatikusan skálázódik, és tétlenség alatt nullára csökken.
A vállalat sikerfeltételei között szerepelt, hogy az új ág p95 értéke alapján 60 másodpercen belül legyen kész, a környezet standard PostgreSQL-kapcsolaton működjön, és a nagy, 10 és 20 megabájt közötti JSONB-értékeket is kezelje.
Replikáció, TTL és szabályozott hozzáférés
A Snorkel AI Amazon DMS-sel tölti be a produkciós Aurora-adatbázist a Lakebase fő ágába. A kezdeti teljes betöltést folyamatos változásadat-rögzítés követi, így a fő ág a forrás szerint körülbelül két percen belül marad a produkcióhoz képest. Ez a fő ág szolgál alapként az új PR-ágakhoz, a csapatnak pedig nem kellett új replikációs folyamatot kiépítenie.
Pull request nyitásakor a CI-folyamat meghívja a Lakebase API-ját, létrehozza az ágat, beállítja a lejárati időt, majd átadja a kapcsolati adatokat a PR-névtérnek. A tesztek migrációkat futtathatnak, adatokat írhatnak és sémát módosíthatnak anélkül, hogy hatással lennének a produkcióra, a fő ágra vagy más pull requestekre.
A környezet privát hálózati kapcsolaton kommunikál. A fejlesztők Okta SSO-val jelentkeznek be, a CI-folyamatok pedig csapatonként vagy adattáronként korlátozott szolgáltatásfiókokat használnak. Ezek rövid élettartamú Lakebase OAuth-tokeneket kérnek, így nincs szükség tartós adatbázisjelszavakra. A PostgreSQL naplói a szolgáltatásfiók azonosságát is rögzítik.
Automatikus törlés a rövid életű ágakhoz
A pull request lezárásakor vagy sikeres teszt után a folyamat törli az ágat. Ha ez a takarítás elmarad, a beállított TTL, vagyis lejárati idő automatikusan eltávolítja a környezetet.
Erre azért van szükség, mert a fő ág folyamatosan frissül, a hosszabb ideig megmaradó PR-ágak pedig továbbra is őrzik a létrehozásukkor érvényes régebbi adatlapokat. A Databricks szerint a másolás íráskor és a lejárat együtt a produkciós alap méretéhez, valamint az aktív pull requestek módosításaihoz közel tarthatja a tárhelyigényt.
A vállalat ugyanezt a modellt AI-ügynökökre is alkalmazhatónak tartja. Minden feladat saját ágat kaphat, ahol az ügynök valódi adatokon olvashat, írhat és sémát módosíthat. A változtatások átnézhetők, a nem kívánt eredményű ág pedig törölhető, így nincs szükség visszagörgetésre.
Databricks: Lakebase branching for CI/CD: lessons from 100 PR databases