Egyetlen LanceDB-táblára épülhet az LLM-ek teljes előkészítése
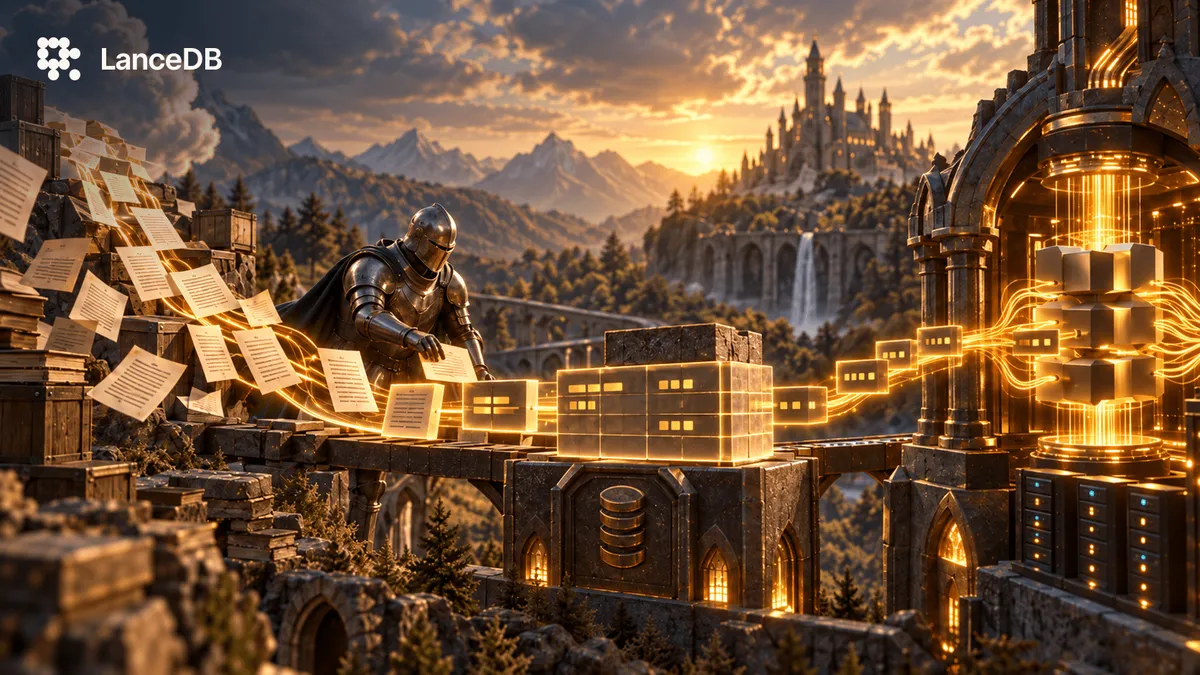
A LanceDB olyan LLM-előkészítési folyamatot mutatott be, amelyben a nyers szöveg, a minősítési eredmények és a tokenek ugyanabban a táblában maradnak. A rendszer a sorok kiolvasásakor végzi el a szekvenciák csomagolását, így a módosított szűrési szabályok vagy blokkméret miatt nem kell új adathalmazt felépíteni.
- A LanceDB a nyers szöveget, a szűrési eredményeket és a tokeneket egy táblában kezeli.
- A szekvenciák csomagolása az adatbetöltés közben történik, külön adathalmaz létrehozása nélkül.
- 2,4 millió dokumentum tokenizálása 4 perc 54 másodpercig tartott.
- A GPT-2 124M modell betanítása 8 H100 GPU-val 14 perc 8 másodperc alatt fejeződött be.
- A bemutatott folyamat 25 perc alatt jutott el a nyers szövegtől a kész modellig.
Nyers adatoktól a betanításig egy táblában
A LanceDB mérnöki blogján bemutatott megközelítés a teljes előfeldolgozási folyamatot egyetlen táblára építi. A kiinduló adatokhoz egymás után új oszlopok kerülnek: a forrásszöveg és annak jellemzői, a duplikátumokat jelző is_dup mező, majd a GPT-2 tokenazonosítói és a tokenek száma.
A módszer lényege, hogy minden lépés egy meglévő oszlopból számít új eredményt, és ezt új oszlopként írja vissza. A LanceDB szerint így nem kell minden változtatás után új fájlkészletet létrehozni. Ha módosul a tokenizáló, a minőségi küszöb, a duplikátumok szűrése vagy a szekvencia hossza, a következő futtatás közvetlenül az aktuális táblából dolgozhat.
Az új oszlopok hozzáadása új táblaverziót hoz létre, miközben a korábbi verzió olvasható marad. A funkciómérnökségként bemutatott folyamat Python-függvényeket futtat a dolgozókon, és ellenőrzési pontokat készít, így megszakítás után folytatható a munka.
A szekvenciák csomagolása csökkenti a pazarlást
A transzformermodellek rögzített méretű tokenblokkokon tanulnak. A bemutatott folyamat 1024 tokenes blokkokat használ. A rövid dokumentumok kitöltése üres helyet hagy a számításban, a hosszú dokumentumok levágása pedig információt dob ki.
A LanceDB StreamingDataset megoldása a dokumentumokat szöveg vége jelzővel fűzi egymás után, majd a folyamatos tokenfolyamot 1024 tokenes blokkokra vágja. A következő dokumentum kitölti az előzőből megmaradt helyet. A forrás példája szerint egy 17,5 millió dokumentumból álló adathalmaznál a kitöltés vagy levágás a tokenek 61,9 százalékát tartaná meg, míg a csomagolás mindet felhasználja.
A csomagolás az adatbetöltőben, a táblasorok kiolvasásakor történik. A betöltő minden korszak előtt megkeveri a dokumentumokat, a beállítások között pedig megadható a blokkméret, az elválasztó token és az egy korszakban feldolgozandó blokkok száma. A szűrő vagy a blokkméret megváltoztatása ezért nem igényli egy külön csomagolt adathalmaz újraépítését.
A bemutatott mérési eredmények
Az első futtatásban 2,4 millió FineWeb-Edu dokumentum betöltése 2 perc 6 másodpercig tartott. A 11,4 milliárd karakterből 4,8 GB-os Lance-tábla készült. A tisztítás és deduplikáció 4 perc 10 másodperc alatt 22 558 duplikátumot jelölt meg, a jelzőoszlop pedig mindössze 306 KB-tal növelte a tárhelyet.
A tokenizálás 4 perc 54 másodperc alatt 2,43 milliárd GPT-2 tokent írt új oszlopba. A LanceDB szerint a tokenazonosítók körülbelül 7 GB-ot foglalnak, vagyis a tokenek méretét adják hozzá, nem a forrásszöveg újabb másolatát.
A csapat egy nanoGPT-stílusú, GPT-2 124M modellt tanított 8 H100 GPU-val. Egy korszak 2,43 milliárd tokent és 4636 optimalizálási lépést tartalmazott. A futtatás 14 perc 8 másodperc alatt fejeződött be, 3,18 millió token másodpercenkénti sebességgel és 34,5 százalékos MFU-val. A validációs veszteség a végén 3,2361 lett.
Mit jelent ez az adatfeldolgozásban?
A LanceDB által bemutatott modell az adat-előkészítés és a betanítás közötti határt tolja közelebb egymáshoz. A curation szabályai szűrőként maradnak meg, így például a score >= 3 feltételre való váltás nem követel új adathalmazt. Ugyanazok a sorok SQL-lekérdezéssel, teljes szöveges kereséssel vagy vektoros kereséssel is vizsgálhatók, az eredmény pedig új oszlopként visszaírható.
A bemutatott első futásban a nyers szövegtől a betanításra kész adatokig 11 perc, a kész modellig 25 perc telt el. A LanceDB szerint a folyamat helyi lemezről és az S3-ból, az Egyesült Államok keleti régiójából egy norvég GPU-fürtbe olvasva is hasonló, körülbelül 3,16 millió tokenes másodpercenkénti sebességet és 34,4 százalékos MFU-t ért el.
LanceDB: A Practical LLM Pretraining Pipeline with LanceDB