A LangChain nyílt forrású eszközzel teszteli az LLM-es kérdésválaszolást
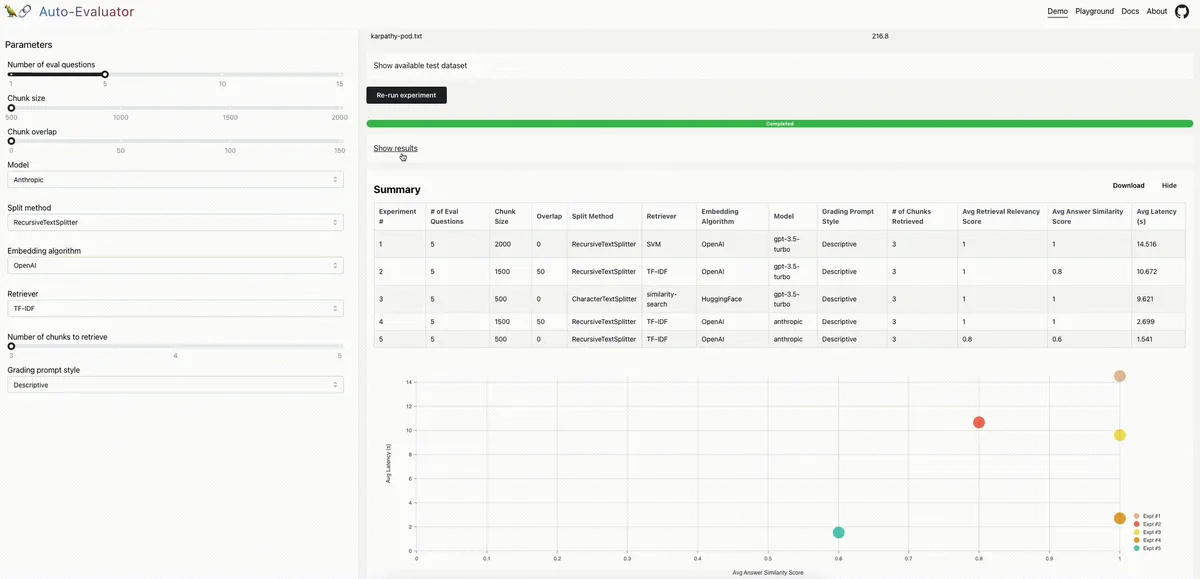
A LangChain nyílt forrású, ingyenesen használható alkalmazást és API-t tett elérhetővé LLM-alapú kérdésválaszoló rendszerek tesztelésére. Az eszköz dokumentumok alapján kérdés-válasz tesztkészletet generál, majd automatikusan értékeli a felhasználó által beállított lánc válaszait.
- A LangChain nyílt forrású, ingyenes auto-evaluator alkalmazást és API-t adott ki.
- Az eszköz dokumentumokból kérdés-válasz tesztkészletet generál.
- A felhasználó több kérdésválaszoló lánc eredményét hasonlíthatja össze.
- A TF-IDF és az SVM egy tesztben a k legközelebbi szomszéd módszerével összemérhető eredményt adott.
- A pontozás eredménye a használt prompttól és modelltől is változhat.
Automatikusan készül a tesztkészlet
A LangChain kérdésválaszolásra alkalmas láncok összeállítását segíti. A folyamatban a bemeneti dokumentumokat kisebb részekre bontják, ezeket egy lekérdező rendszerben tárolják, majd a felhasználó kérdéséhez kapcsolódó részeket egy nyelvi modell kapja meg válaszgenerálásra.
A LangChain szerint az ilyen rendszerek minősége jelentősen változhat. A válaszokat befolyásolhatják például a paraméterbeállítások, és előfordulhat hallucináció vagy gyenge válaszminőség. Gyakran az sem egyértelmű, hogyan kell megmérni a válaszokat, illetve hogyan lehet az eredmények alapján módosítani a lánc beállításait, a felhasznált dokumentumok számát, a darabolás méretét, a modellt vagy a lekérdezőt.
Az auto-evaluator ezeket a lépéseket egy munkafelületen kapcsolja össze. A megadott dokumentumból automatikusan kérdés-válasz párokat állít elő, majd egy modell segítségével pontozza a kérdésválaszoló lánc eredményeit. A megközelítés a LangChain leírása szerint az Anthropic modell által írt értékelési adathalmazokra épülő munkáját és az OpenAI modellalapú értékelését ötvözi.
Demo és saját dokumentumokkal működő játszótér
A szolgáltatás két módon használható. A demóban előre betöltöttek egy Lex Fridman podcastátiratot, amelyben Andrej Karpathy szerepel, valamint öt, a beszélgetéshez kapcsolódó kérdés-válasz párt. A felhasználó különböző kérdésválaszoló láncokat állíthat be, majd összehasonlíthatja a teljesítményüket.
A játszótérben saját dokumentum adható meg több lánc értékeléséhez. A felhasználó opcionálisan előre elkészített kérdés-válasz párokat is hozzáadhat a dokumentumhoz. A LangChain közleménye szerint az alkalmazás és az API nyílt forrású, használatuk ingyenes.
A visszakeresés és az értékelés is fejleszthető
A LangChain több fejlesztési lehetőséget is felsorol. Az egyik a fájlkezelés: két, összesen 39 MB-os fájl feltöltése a produkciós környezetben körülbelül 40 másodpercet vett igénybe, miközben helyi környezetben az átviteli idő nulla másodperc volt. A cég szerint a képek növelik a fájlméretet, ezért azok eltávolítása gyorsíthatná a feltöltést.
A kérdés-válasz párok generálása jelenleg véletlenszerűen kiválasztott részletekből történik, elsősorban a sebesség érdekében. A LangChain szerint ezt javítani lehetne úgy, hogy a kérdések a teljes bemeneti szöveg összefüggéseit is figyelembe vegyék.
A dokumentumok visszakeresésére használt módszerek között a vektortárolók beágyazásain alapuló k legközelebbi szomszéd keresése mellett a cég az SVM-et és a TF-IDF-et is vizsgálta. Egy, 15 tanulmányból álló tesztkészletben a TF-IDF és az SVM legalább olyan jól teljesített, sőt kissé jobban, mint a k legközelebbi szomszéd módszer. A LangChain hangsúlyozza, hogy ez az eredmény az adott esethez kötődik.
A pontozó modell válaszai sem mindig stabilak
Az értékeléshez használt utasítás, vagyis prompt, jelentősen befolyásolta a pontszámokat. A LangChain tesztjében a gyors prompt 5-ből 5, a leíró prompt 4-ből 5, a torzítással kiegészített leíró prompt 5-ből 5 választ értékelt helyesnek. Az OpenAI zárt kérdésválaszolási értékeléshez használt promptja 2-ből 5 eredményt adott.
Az alkalmazás jelenleg GPT-3.5-turbót használ értékelőként, miközben az OpenAI-val folytatott egyeztetés alapján a GPT4 előnyösebb lehet. A LangChain egy olyan példát is bemutatott, amelyben ugyanazt a választ a rendszer egyszer hibásnak, máskor helyesnek minősítette, egy kettős tagadás miatt.
A fejlesztők a fájlkezeléshez, a kérdésgeneráláshoz és pontozáshoz használt promptokhoz, az értékelő modellekhez, valamint a lekérdezőkhöz várnak hozzájárulásokat. A közlemény szerint ezek jelentik a fejlesztés legnagyobb hatású területeit.
LangChain: Auto-Evaluator Opportunities