A LangChain táblázatokkal, szövegekkel és képekkel bővíti a RAG-et
A LangChain három új szakácskönyvet tett közzé, amelyek a többvektoros visszakereső használatát mutatják be szövegeket, táblázatokat és képeket tartalmazó dokumentumoknál. A megközelítés célja, hogy a kereséshez optimalizált összefoglalók mellett az eredeti tartalom is eljusson a nyelvi modellhez.
- A LangChain három új szakácskönyvben mutatja be a többvektoros visszakeresőt.
- A módszer külön kezeli a kereséshez használt összefoglalót és a válaszhoz átadott eredeti dokumentumot.
- A folyamat táblázatok, szövegek és képek együttes kezelését célozza.
- A képekhez multimodális beágyazás vagy képi összefoglaló is használható.
- A privát változat nyílt forráskódú összetevőkkel helyben is futtatható.
A keresés és a válaszgenerálás szétválasztása
A visszakereséssel támogatott generálás, vagyis a RAG, külső adatforrásokból származó releváns kontextust ad a nyelvi modellnek a kérdés megválaszolásához. A LangChain szerint ez különösen hasznos lehet vállalati adatoknál, mivel a modellek következtetési képességét külső források tényszerű tartalmával kapcsolja össze.
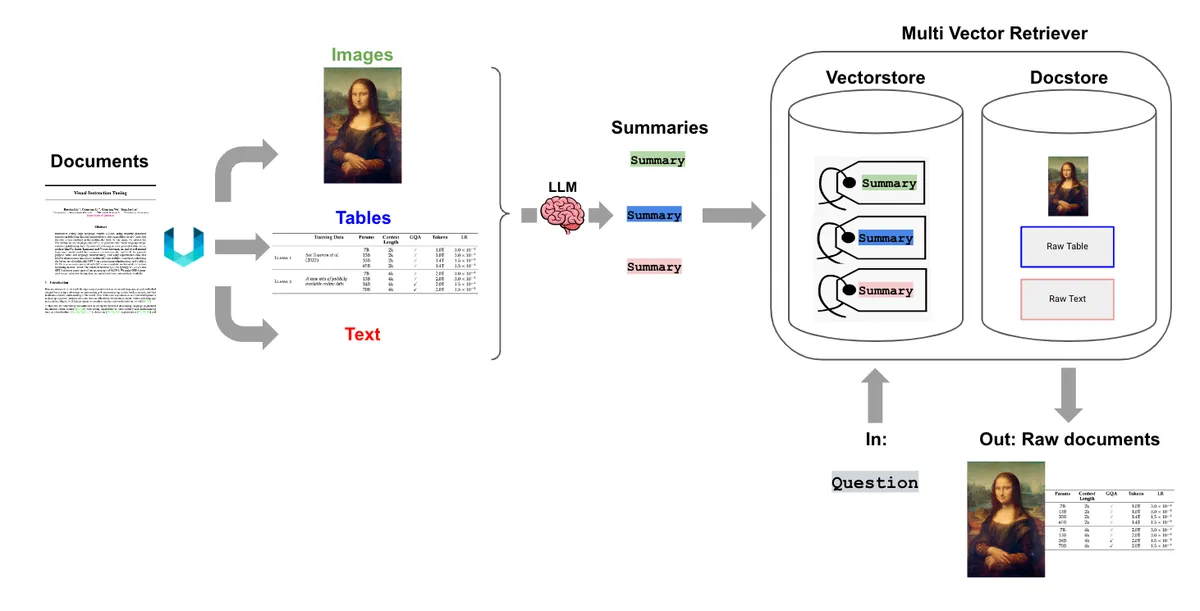
A többvektoros visszakereső alapötlete, hogy különválasztja a válasz összeállításához használt dokumentumot és a kereséshez használt hivatkozást. Egy hosszú dokumentumról például rövid, vektoralapú hasonlósági keresésre alkalmas összefoglaló készülhet, miközben a nyelvi modell a teljes dokumentumot kapja meg. Így a visszakeresés egyszerűbbé válhat, a válaszadáskor pedig több eredeti kontextus maradhat elérhető.
Táblázatok kezelése természetes nyelvű összefoglalókkal
A LangChain szerint a félig strukturált dokumentumok, például a strukturált táblázatokat és strukturálatlan szöveget vegyesen tartalmazó fájlok, problémát jelenthetnek az egyszerű darabolási módszereknek. Egy naiv feldolgozás akár szét is tördelheti a táblázatokat.
A bemutatott folyamatban a dokumentum elemeit először különválasztják. Az Unstructured eszköz különféle fájltípusokból képes táblázatokat, képeket és szövegeket kinyerni. PDF-eknél eltávolítja a beágyazott képeket, majd a YOLOX elrendezésmodell segítségével táblázatokhoz és címekhez tartozó határolókereteket azonosít. A szöveget a címekhez rendeli, ezután a felhasználó által megadott beállítások alapján további szövegrészekre bontja.
A táblázatokhoz természetes nyelvű összefoglalók készülnek. Ha egy ilyen összefoglaló illeszkedik a felhasználó kérdéséhez, a rendszer az eredeti táblázatot adja át a nyelvi modellnek a válasz elkészítéséhez.
Három út a képeket is kezelő RAG-hez
A LangChain három lehetséges megközelítést vázol fel a multimodális RAG-hez. Az első multimodális beágyazásokat, például a CLIP-et használja, így a képek és a szövegek együtt kereshetők. A találatokhoz tartozó eredeti képeket ezután egy multimodális nyelvi modell kapja meg a szövegrészekkel együtt.
A második módszerben egy multimodális modell, például GPT4-V, LLaVA vagy FUYU-8b, szöveges összefoglalót készít a képről. Ezt szöveges beágyazási modell indexeli, a válaszhoz pedig szövegrészletek vagy táblázatok kerülnek elő. A harmadik változat szintén képi összefoglalókat használ, de a visszakeresett összefoglaló az eredeti képre hivatkozik, amelyet a multimodális modell kap meg.
A LangChain a második lehetőséget a 7 milliárd paraméteres LLaVA-modellel próbálta ki. A bejegyzés szerint a modell a llama.cpp segítségével fogyasztói laptopokon is futtatható, és ésszerű képi összefoglalókat készít.
Helyben is futtatható összeállítás
A LangChain három szakácskönyvet tett közzé: egyet félig strukturált, táblázatokat és szöveget kezelő RAG-hez, egyet szöveget, táblázatokat és képeket kombináló multimodális RAG-hez, egyet pedig ugyanezen folyamat privát, helyben futtatható változatához.
Adatvédelmi szempontok esetén a bemutatott folyamat nyílt forráskódú összetevőkkel, fogyasztói laptopon is futtatható. A példában a LLaVA 7b készít képi összefoglalókat, a Chroma végzi a vektortárolást, a beágyazásokhoz a Nomic GPT4All szerepel, a válaszgeneráláshoz pedig a LLaMA2-13b-chat fut az Ollama.ai segítségével. A bejegyzés ezzel a többféle adattípus egységes RAG-kezelésének gyakorlati mintáit adja a fejlesztők kezébe.
LangChain: Multi-Vector Retriever for RAG on tables, text, and images