A LangSmith emberi visszajelzésekkel javítja az LLM-bírálókat
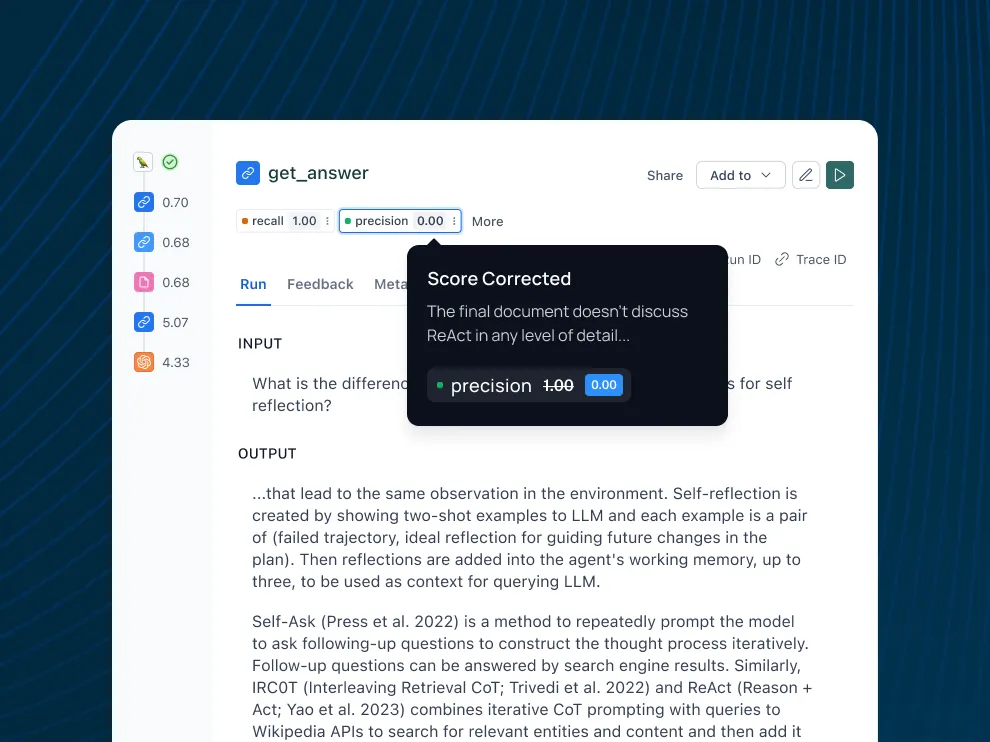
A LangSmith új, önfejlesztő értékelési rendszere az emberi javításokat későbbi példaként építi be az LLM-as-a-Judge bírálók működésébe. A LangChain szerint így kevesebb kézi utasításírásra van szükség az értékelések emberi preferenciákhoz igazításához.
- A LangSmith önfejlesztő LLM-bírálókat vezetett be.
- A felhasználói javításokat a rendszer néhány példás tanulási mintaként tárolja.
- A minták a későbbi értékelések utasításaiba kerülnek be.
- A megoldás online és offline értékeléshez is használható.
- A cél az értékelések emberi preferenciákhoz igazítása kevesebb kézi promptolással.
Miért használnak külön nyelvi modellt az értékeléshez?
A nyelvi modellekre épülő alkalmazások teljesítményét gyakran nehéz hagyományos programozott szabályokkal mérni. A tömörség vagy a referencia-válaszhoz viszonyított helyesség például nehezen írható le tipikus egységtesztekkel. A generatív feladatokhoz kevés általánosan használható mérőszám áll rendelkezésre, ezért a fejlesztőknek más módszerekre van szükségük.
Az LLM-as-a-Judge, vagyis LLM-bíráló olyan értékelő, amely egy külön nyelvi modell segítségével pontozza az alkalmazás által előállított választ. A bíráló megkaphatja a generált kimenetet és további információkat, majd ezek alapján értékelheti például a helyességet, a relevanciát vagy azt, hogy a válasz mérgező, illetve nem megfelelő tartalmú-e.
A LangChain szerint ez különösen hasznos lehet a RAG-rendszerek hallucinációinak online felismerésére, a RAG-válaszok helyességének offline ellenőrzésére, valamint a káros vagy nem megfelelő válaszok kiszűrésére.
Az emberi javításokból tanul a bíráló
Az LLM-as-a-Judge használata ugyanakkor új feladatot jelent: a fejlesztőknek külön utasításokat kell kialakítaniuk az értékelő modell számára. A LangChain közleménye szerint ez időigényes lehet, és hátráltathatja egy megfelelő értékelési rendszer felállítását.
A LangSmith erre önfejlesztő értékelőkkel válaszol. A felhasználó először online vagy offline értékeléshez beállít egy LLM-bírálót, amelynek megadhatja azt is, hogyan jelenjenek meg a néhány példás tanulási minták az utasításban.
Ezután a bíráló visszajelzést ad a generált kimenetekről. A felhasználók a LangSmith felületén közvetlenül módosíthatják vagy kijavíthatják ezt a visszajelzést. A rendszer ezeket a javításokat automatikusan néhány példás mintaként tárolja. A felhasználó a korrekcióhoz magyarázatot is fűzhet.
A következő értékelési futtatások során a LangSmith ezeket a példákat, illetve igény szerint a hozzájuk tartozó magyarázatokat beilleszti az LLM-bíráló utasításába. Így az értékelő fokozatosan igazodhat az adott csapat vagy alkalmazás elvárásaihoz.
Kutatási háttér és gyakorlati jelentőség
A megoldás két gondolatra épül. Az első a nyelvi modellek néhány példás tanulási képessége: ha a modell helyes példákat kap, képes azokhoz igazítani a viselkedését. A LangChain szerint ez különösen olyan esetekben hasznos, amikor nehéz részletes utasításokkal leírni az elvárt működést, vagy amikor meghatározott formátumú kimenetre van szükség.
A másik ösztönző forrás Shreya Shankar, a Berkeley kutatójának Who Validates the Validators? Aligning LLM-Assisted Evaluation of LLM Outputs with Human Preferences című tanulmánya volt. A LangChain közlése szerint a kutatás ugyan eltérő megoldást javasol, de hozzájárult ahhoz, hogy a vállalat a visszajelzések gyűjtését használja az LLM-értékelések emberi preferenciákhoz igazítására.
Az új folyamatban a csapatoknak a LangChain leírása alapján nem kell minden javítás után kézzel módosítaniuk az értékelő utasításait. A fejlesztők a téves vagy pontatlan értékeléseket javíthatják, ezek a korrekciók pedig később közvetlenül befolyásolják a bíráló működését.
Mit jelent ez a LangSmith felhasználóinak?
A LangSmith olyan fejlesztőknek készült, akik nyelvi modellre épülő alkalmazásokat építenek, és folyamatosan szeretnék mérni azok teljesítményét. Az önfejlesztő értékelőkkel a felhasználói visszajelzés az értékelési folyamat részévé válik, miközben az online és offline ellenőrzések is beállíthatók.
A rendszer célja, hogy a bírálók idővel pontosabban tükrözzék az adott csapat szempontjait. A LangChain szerint ez hatékonyabbá teheti az alkalmazások ellenőrzését és finomítását, mivel a fejlesztőknek az utasítások folyamatos kézi átírása helyett a visszajelzések áttekintésére és javítására kell koncentrálniuk.
LangChain: Aligning LLM-as-a-Judge with Human Preferences