Második lett az NVIDIA csapata a KDD Cup adatügynök-versenyén
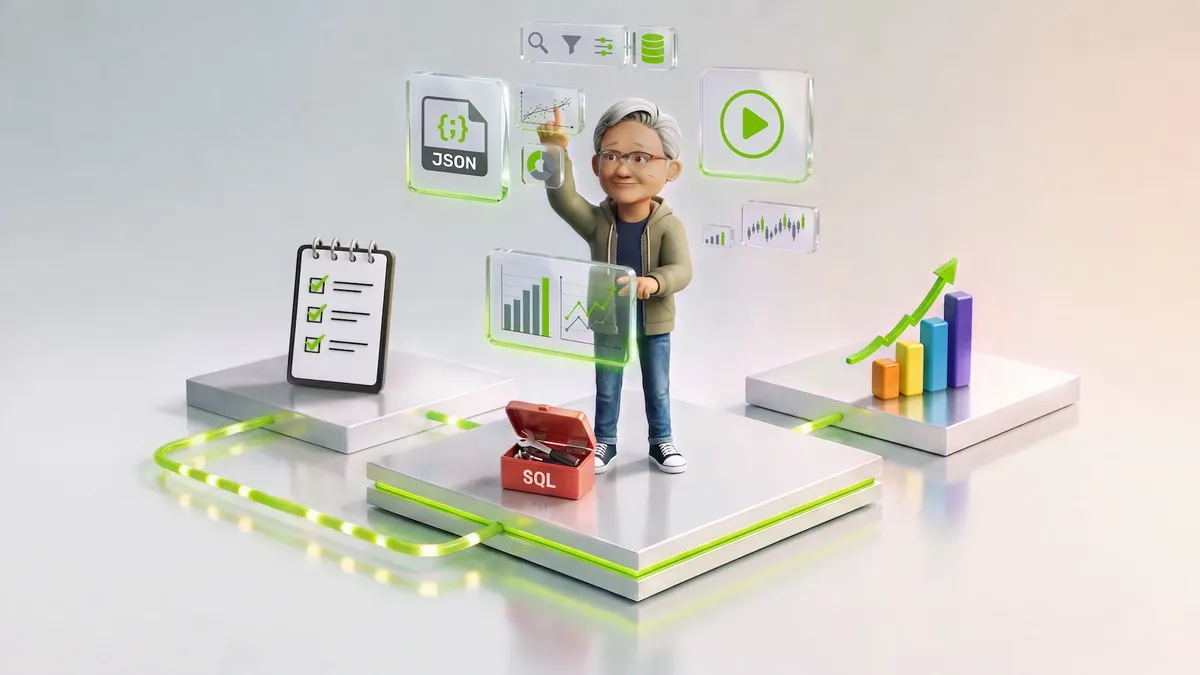
Második helyezést ért el az NVIDIA KGMON csapata a KDD Cup 2026 Data Agents versenyén. A rendszer egy kis, rögzített nyelvi modell köré épített szűk eszköztárral, egységes adatfelülettel és részletes futásnaplózással dolgozott.
- Az NVIDIA KGMON csapata második lett a KDD Cup 2026 Data Agents versenyén.
- A rendszer CSV- és JSON-adatokat egy SQLite-adatbázisba egyesített.
- Az ügynök szűk eszköztárat kapott, köztük a schema(), sql(), write_answer() és prose_helper() funkciókat.
- A dokumentumokat célzott kereséssel és külön modellhívással dolgozták fel.
- A futási naplók alapján külön ellenőrző ügynök vizsgálta a hibákat.
A kisebb modell köré építették a rendszert
A KDD Cup versenyfeladataiban az ügynököknek természetes nyelvű kérdésekre kellett válaszolniuk különböző adatforrások alapján. Ezek között adatbázisok, CSV- és JSON-fájlok, szöveges dokumentumok, PDF-ek és tájékoztató videók is szerepeltek. A feladatokhoz nem volt elég egyszerűen megtalálni az információt: az ügynöknek meg kellett vizsgálnia az adatokat, ki kellett választania a megfelelő eszközöket, több forrásból kellett következtetnie, majd a választ megfelelő fájlformátumban kellett előállítania.
A versenyen kis, rögzített nyelvi modellt kellett használni, ezért az NVIDIA csapata szerint a rendszer környezete, vagyis a modell köré épített harness vált a legfontosabb fejlesztési területté. A megközelítés alapja az volt, hogy az ügynök feladatait minél szűkebben, átláthatóbban és ellenőrizhetőbben határozzák meg.
Egyetlen SQL-felületre hozták a strukturált adatokat
A KGMON a CSV- és JSON-fájlokat az adott SQLite-adatbázis tábláivá alakította. Így az ügynök minden strukturált adatforrást ugyanazon az SQL-felületen keresztül érhetett el. A környezet két alapvető funkciót biztosított: a schema() a táblák és oszlopok megtekintésére szolgált, az sql(query) pedig a lekérdezések futtatására.
A csapat minden feladat elején egy előzetes sémavizsgálatot is lefuttatott. Ez összegyűjtötte a táblákat, az oszlopokat, a lehetséges kapcsolókulcsokat, a hasonló nevű mezőket, a mértékegységeket, az üres értékek mintázatait és az egyes sorok jelentésével kapcsolatos problémákat. Az így létrehozott séma-kontekstust az ügynök már a fő gondolkodási ciklus megkezdésekor megkapta.
Az NVIDIA szerint ez csökkentette a hibás oszlopválasztásból, az eltévesztett összekapcsolásokból és az adatsorok jelentésének félreértéséből eredő problémákat. Az egységes felület egyúttal kevesebb útválasztási hibát és fölösleges lépést eredményezett.
Szűk eszköztár, külön kezelt dokumentumok és naplózott futások
A rendszer az adatbázisok vizsgálata és lekérdezése mellett az eredmény mentésére, dokumentumok keresésére és szöveges információk kinyerésére biztosított segédeszközöket. A fő funkciók a schema(), az sql(query), a write_answer(df) és a prose_helper() voltak. Köztes állapotot megőrző Python-környezet tette lehetővé, hogy az ügynök újra felhasználja a korábbi lépések eredményeit, a köztes réteg pedig kijavítsa a hibásan formázott eszközhívásokat.
A hosszú dokumentumokat nem engedték közvetlenül teljes terjedelmükben a fő ügynök kontextusába tölteni. Ehelyett korlátozott előnézeteket és reguláris kifejezéses kereséseket használtak. A megtalált szövegrészleteket a prose_helper() egy külön, nulla hőmérsékleten futó nyelvi modellhívásnak adta át. Ez rövid válaszokat vagy táblázatokat nyert ki, miközben a nyers dokumentumszöveg a fő kontextuson kívül maradt.
A csapat minden futásról naplót vezetett, amelyben a felszólítások, az eszközhívások és a köztes eredmények is szerepeltek. Egy külön ellenőrző ügynök ezek alapján kategorizálta a hibákat. Az NVIDIA szerint ez segített felismerni, hogy egy próbálkozás hibás eszközhívás, rossz összekapcsolás, figyelmen kívül hagyott dokumentumszabály vagy hibás kimeneti formátum miatt siklott félre.
A KGMON eredménye az NVIDIA bemutatása szerint azt mutatja, hogy kisebb nyelvi modellek mellett is javítható a megbízhatóság előfeldolgozással, korlátozott eszközökkel, megőrzött állapottal és ellenőrzéssel. A cég ugyanakkor hangsúlyozza, hogy ez nem minden adatügynök számára készült általános recept, a dokumentumokból történő táblázatkinyerés például főként a verseny feladataihoz illett.
NVIDIA Developer: Building Reliable Data Analytics Agents: Lessons from the KDD Cup