Megosztott az AI-biztonsági közösség az egzisztenciális kockázatokról
A FAR.AI 17 AI-biztonsági szakértővel készített interjú alapján vizsgálta, hogyan alakulhat az emberi szintű mesterséges intelligencia és milyen módokon okozhat katasztrófát. A beszélgetések szerint az AI-biztonsági terület jóval megosztottabb, mint azt kívülről gyakran feltételezik.
- A FAR.AI 17 AI-biztonsági szakértővel készített interjút.
- Sokan a jelenlegi nagy nyelvi modellek továbbfejlesztését várják az első emberi szintű AI alapjaként.
- Az össze nem hangolt AI hatalomátvétele volt a leggyakrabban említett katasztrófaforgatókönyv.
- A szakértők a mechanisztikus interpretálhatóságot, a feketedobozos értékeléseket és az irányítási kutatást tartották fontosnak.
- A kutatás mintája nem reprezentálja szükségszerűen az egész AI-biztonsági mozgalmat.
Tizenhét szakértő stratégiai nézőpontja
A FAR.AI kutatója, Euan McLean 17 félig strukturált interjút készített AI-biztonsági szakértőkkel. A beszélgetések 2023 márciusa és 2024 februárja között zajlottak, a résztvevők pedig az akkori álláspontjukat ismertették. A blogbejegyzés dátuma 2026. augusztus 19., a szövegben ugyanakkor 2024. május 22. is szerepel.
A kutatás nem konkrét technikai vagy filozófiai érveket vizsgált részletesen. A cél az volt, hogy feltérképezze, miként illeszkednek ezek a kérdések az AI-biztonság tágabb stratégiai képébe. McLean olyan témákról kérdezte az interjúalanyokat, mint az emberi szintű AI várható megjelenése, az egzisztenciális katasztrófa lehetséges forgatókönyvei, a kockázatok csökkentésének módjai és a közösség korábbi hibái.
A legtöbben a jelenlegi modellek továbbfejlesztését várják
A válaszadók jelentős része úgy gondolta, hogy az első emberi szintű AI, vagyis az a rendszer, amely nagyjából az összes gazdaságilag értékes kognitív feladatot olcsóbban képes elvégezni az embernél, a jelenlegi nagy nyelvi modellekhez hasonló paradigmára épülhet. Szerintük ez valószínűleg a modellek felskálázását, néhány új módszert vagy technikai megoldást, valamint olyan kiegészítő rétegeket jelenthet, mint az AutoGPT, amelyek ügynökszerű működést tesznek lehetővé.
Egy kisebb csoport szerint ehhez ennél jelentősebb áttörésekre lenne szükség. A katasztrófa leggyakrabban említett forgatókönyve az össze nem hangolt AI hatalomátvétele volt, de több szakértő vitatta az ehhez kapcsolódó alapfeltevéseket. Mások inkább strukturális kockázatokat hangsúlyoztak, például az instabilitást, a szélsőséges egyenlőtlenséget, az emberek fokozatos háttérbe szorulását és az intézmények összeomlását.
Technikai kutatás, szabályozás és a korábbi hibák
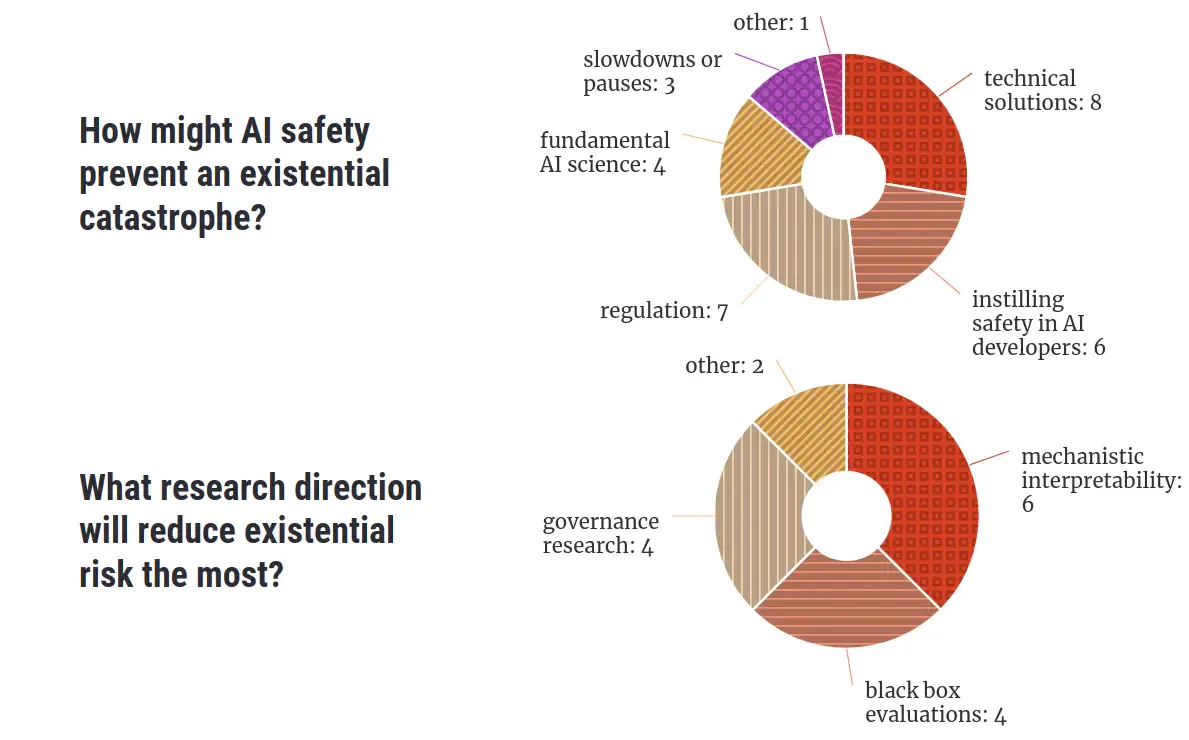
A válaszadók szerint az AI-biztonság több irányból járulhat hozzá a katasztrófák megelőzéséhez. Ide sorolták a technikai megoldások kidolgozását, a biztonsági szemlélet elterjesztését az AI-kutatásban, az ésszerű szabályozás támogatását, valamint az AI alapvető tudományának fejlesztését.
A legígéretesebb kutatási területek között a mechanisztikus interpretálhatóságot, a feketedobozos értékeléseket és az irányítási kutatást említették. A közösség korábbi hibáiról nem alakult ki konszenzus. Gyakran felmerült azonban a túlzottan elméleti érvelés, a zártság, a szokatlan vagy szélsőséges nézetek hangsúlyozása, a vezető AGI-cégek támogatása és az ebből fakadó versenyhelyzet, az önálló gondolkodás hiánya, az AI-fejlesztés leállításának nem megfelelő szorgalmazása, valamint a szakpolitika korábbi elhanyagolása.
McLean hangsúlyozza, hogy az eredmények nem feltétlenül reprezentálják az egész AI-biztonsági mozgalmat. A mintát többek között a vélemények és a hátterek sokszínűsége alapján választották ki, de minden résztvevő legalább bizonyos mértékben elfogadta, hogy az AI egzisztenciális kockázatot jelenthet. A szerző azt is jelzi, hogy a MIRI munkatársai nem vettek részt az interjúkban, noha a szervezetet több válaszadó bírálta.
A felhasználók számára a vita sokfélesége a legfontosabb jelzés
A FAR.AI anyaga alapján az AI-biztonsági szakértők több alapvető kérdésben sem ugyanazt a jövőképet osztják. Van, aki az össze nem hangolt rendszerek közvetlen veszélyét tartja elsődlegesnek, mások az egyenlőtlenség, az intézményi instabilitás vagy az emberi befolyás fokozatos elvesztése felől közelítenek.
Ez a felhasználók számára azt jelenti, hogy az AI-biztonságról szóló szakmai állításokat nem egyetlen egységes álláspontként érdemes értelmezni. A kutatás szerint a technikai fejlesztés, a szabályozás és az AI-rendszerek működésének jobb megértése egyszerre jelenik meg a lehetséges válaszok között, miközben a közösség a saját módszereit és korábbi döntéseit is vitatja.
FAR.AI: Big Picture AI Safety | FAR.AI