A Meta egymillió GPU-s szuperszámítógépet épít Ohióban
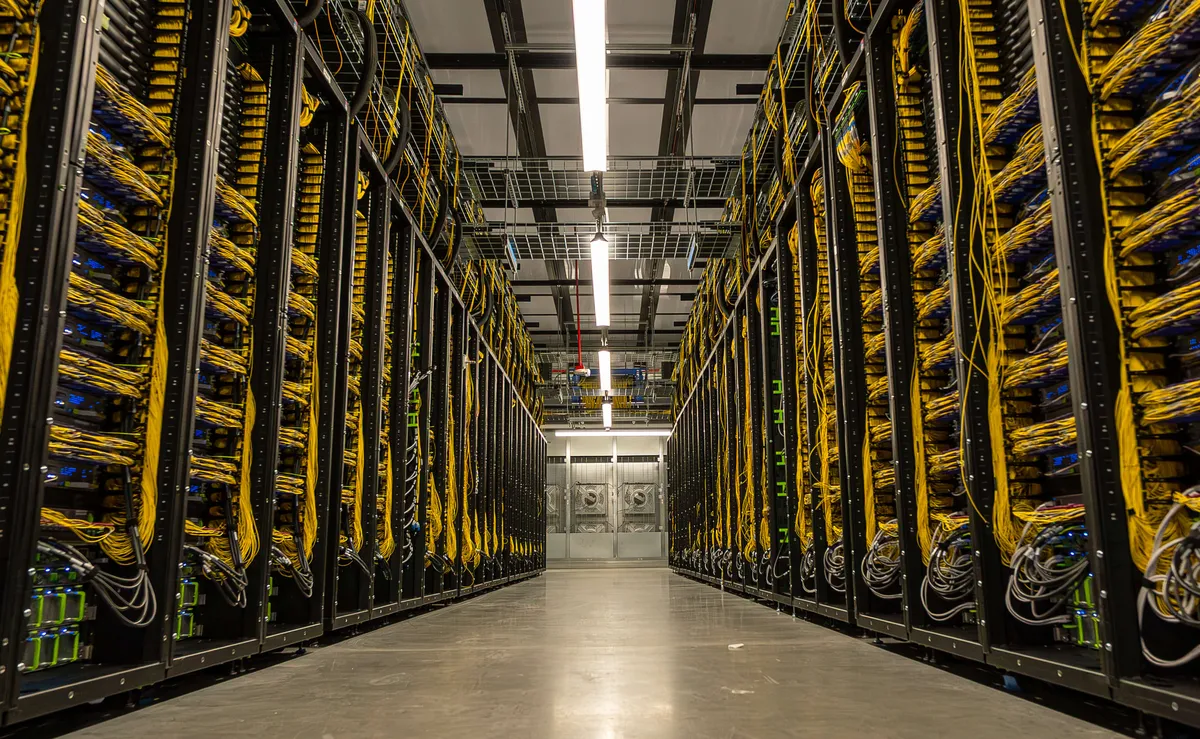
A Meta befejezte a Prometheus nevű, gigawattos kapacitású szuperszámítógép első építési szakaszát. A New Albanyben működő rendszer jelenleg több százezer GPU-t kapcsol össze, végső mérete pedig nagyjából egymillió GPU lehet.
- A Prometheus első szakasza elkészült a Meta ohiói adatközpontjában.
- A klaszter jelenleg több százezer GPU-t kapcsol össze, teljes mérete nagyjából egymillió GPU lehet.
- Az első szakaszon a Muse és Muse Wonder modelleket képezték.
- A rendszer Catalina GB200 és Clemente GB300 NVL72 platformokat használ.
- A Meta külön, GPU-k közötti kommunikációra optimalizált háttérhálózatot épített ki.
Az első szakasz már a Muse modelleket szolgálta
A Meta az ohiói New Albany adatközpontjában építi a Prometheust, amely a vállalat szerint a következő generációs alapmodellek képzésére szolgál. A helyszín két éve még hagyományos adatközpontként működött, webes forgalmat kezelt, azóta azonban a hardver, a hálózat és az épület kialakításának fejlesztéseivel AI-modellek tréningezésére alakították át.
A Prometheus első szakasza már elkészült, és ezt használták a Muse alapmodellek, köztük a Muse Wonder modellek képzésére. A Meta állítása szerint ezek a modellek személyes és professzionális ügynöki feladatokban nyújtanak csúcsteljesítményt.
A vállalat a nagy képzési feladatok stabilitását a goodput, vagyis a ténylegesen hasznos munkával töltött idő arányával is méri. A Muse Wonder előképzési futásainál 85 százalék feletti, megerősítéses tanulási futásainál pedig 90 százalék feletti goodputot értek el. A futások során az üzemzavarok közötti átlagos idő nagyjából 47 ezer GPU-óra volt, a későbbi firmware-javítások után pedig több mint 54 ezer GPU-órára nőtt.
Több épületből egyetlen gépet építenek
A Prometheus több, egymással összekötött épületben működő GPU-rendszerből áll. A klaszterben hagyományos és AI-ra optimalizált adatközponti épületek, valamint gyors telepítésre alkalmas szerkezetek is vannak, amelyeket több kilométernyi optikai szál kapcsol össze. A Meta ezeket egyetlen gépként kezeli.
A vállalat szerint a jelenlegi kapacitás nagyobb modellek és hosszabb kontextusablakok képzését teszi lehetővé, mint ami korábban praktikus volt. Teljes kiépítéskor a rendszer nagyjából egymillió, összehangoltan működő GPU-ból állhat.
A Prometheus zárt hurkú folyadékhűtést is alkalmaz az energiahatékony működés támogatására. A klaszter bővítése a Meta Superintelligence Labs következő frontier modelljeit is szem előtt tartja.
Két NVIDIA-platform, egy harmadik úton
A Prometheus jelenleg két NVIDIA GPU-platformot használ, és a Meta egy harmadik, NVIDIA Vera Rubin NVL72 alapú platform érkezését is jelzi. A rendszerek közös eleme az NVL72 rackarchitektúra, amelyben 72 GPU ugyanazon hálózati szöveten belül egyetlen gyorsítóként működik.
Az első platform a Catalina, amely az NVIDIA GB200 NVL72-re épül. Az Ariel változat két rackben helyezi el a 72 GPU-t, rackenként 36-ot, és NVIDIA Blackwell GPU-kat, NVIDIA Grace CPU-kat, valamint két-két NVIDIA ConnectX-7 400G hálózati kártyát használ GPU-nként. A rendszer összesen 13,4 terabájt HBM3e memóriát, 720 csúcs-PFLOPS FP8-as számítási teljesítményt és körülbelül 120 kilowatt teljes rendszerfogyasztást kínál.
A második platform, a Clemente, az NVIDIA GB300 NVL72-re épül. GPU-nként 288 gigabájt HBM3e memóriát biztosít, ami 50 százalékkal több a GB200 192 gigabájtjánál, csúcsértéken pedig több mint 1 exaFLOPS FP4-es teljesítményt kínál. A 72 GPU egyetlen rackben helyezhető el, a rack fogyasztása körülbelül 135 kilowatt. A Meta szerint a Clemente 5 és 10 százalék közötti teljesítményjavulást nyújt a GB200 NVL72-höz képest.
A hálózat a számítási teljesítmény része lett
A nagy AI-modellek képzése során a GPU-k közötti kommunikáció legalább olyan fontos, mint maguk a számítási egységek. A Meta ezért a hagyományos adatközponti hálózat mellett külön Ethernet-alapú háttérhálózatot, úgynevezett Back-End hálózatot használ. Ez közvetlen GPU-GPU kommunikációt tesz lehetővé az épületeken belül és azok között.
Épületszinten egy-egy Ethernet-alapú hálózati szövet akár 20 736 GPU-t is összekapcsolhat. A Meta korábbi, ütemezett hálózati kialakítását újabb, nem ütemezett szövetre fejlesztette, amely sekély pufferekkel rendelkező, 51,2 terabites Ethernet-kapcsolókat és dinamikus terheléselosztást használ. Mindkét megoldás a Meta FBOSS hálózati szoftveres rendszerére épül.
A fejlesztések célja, hogy a GPU-k minél kevesebb időt töltsenek hálózati kommunikációra várva. A Prometheus így a Meta szerint nagyobb, összetettebb és hosszabb ideig futó modellképzési feladatokat kezelhet, miközben a vállalat tovább bővíti a rendszert.
Engineering at Meta: Inside Prometheus: Meta’s Journey to a Gigawatt-Scale Supercluster