A Microsoft szerint több kell a dokumentumok megbízható feldolgozásához, mint egy séma
Az Azure Content Understanding előre elkészített elemzői strukturált adatokat nyernek ki számlákból, adóűrlapokból és személyazonosító dokumentumokból. A Microsoft szerint az eszközök a sémán túl a dokumentumtípusok sajátosságait, a bizonytalanságokat és a forrásadatokat is kezelik.
- Az Azure Content Understanding előre elkészített elemzői többek között számlákhoz és adóűrlapokhoz használhatók.
- A kimenet strukturált értéket, bizonyossági pontszámot és forrásigazolást is tartalmazhat.
- Az összetett elemzők osztályozzák és a megfelelő feldolgozóhoz irányítják a különböző dokumentumokat.
- A Microsoft 19 amerikai adóűrlap-kategórián 99,32 százalékos átlagos F1-értéket közölt a 2.0 Preview esetében.
- A 2.0 Preview modellezett költsége ezer oldalanként 8 dollár volt a bemutatott benchmarkban.
A séma önmagában nem garantál megbízható eredményt
A Microsoft Foundry október 13-án közzétett ismertetője szerint az intelligens dokumentumfeldolgozásban a szöveg kinyerése csak a kiindulópont. Az alkalmazásoknak a dokumentum szerkezetét és a benne rejlő üzleti jelentést is értelmezhető formában kell átadniuk az ügynököknek és a további rendszereknek.
A séma meghatározza a kimenet szerződését, például a mezők nevét és típusát, a kötelező tulajdonságokat, a beágyazott objektumokat és az engedélyezett értékeket. A Microsoft példája szerint azonban egy séma attól még nem tudja megállapítani, hogy egy mínuszjel kimaradt-e, egy dátumot rossz területi beállítással értelmeztek-e, vagy egy értéket rossz számlatételhez rendeltek-e.
Az Azure Content Understanding egyedi elemzőivel a fejlesztők természetes nyelven írhatják le, milyen mezőket kell kinyerni vagy létrehozni. A speciális munkafolyamatok minőségét reprezentatív dokumentumok tesztelésével, címkézett példákkal, pontosabb mezőleírásokkal és követelmények szerinti kiértékeléssel lehet tovább javítani.
Dokumentumtípushoz kötött tudás és ellenőrizhető eredmények
Az előre elkészített, területspecifikus elemzők egy karbantartott sémát kapcsolnak össze a dokumentumcsaládra vonatkozó tanult ismeretekkel. Ez magában foglalja azt is, hogyan jelennek meg a mezők, hol szoktak elhelyezkedni, mely értékek kapcsolódnak egymáshoz, mely formátumok tekinthetők egyenértékűnek, és milyen félreértések okoznak gyakran hibát.
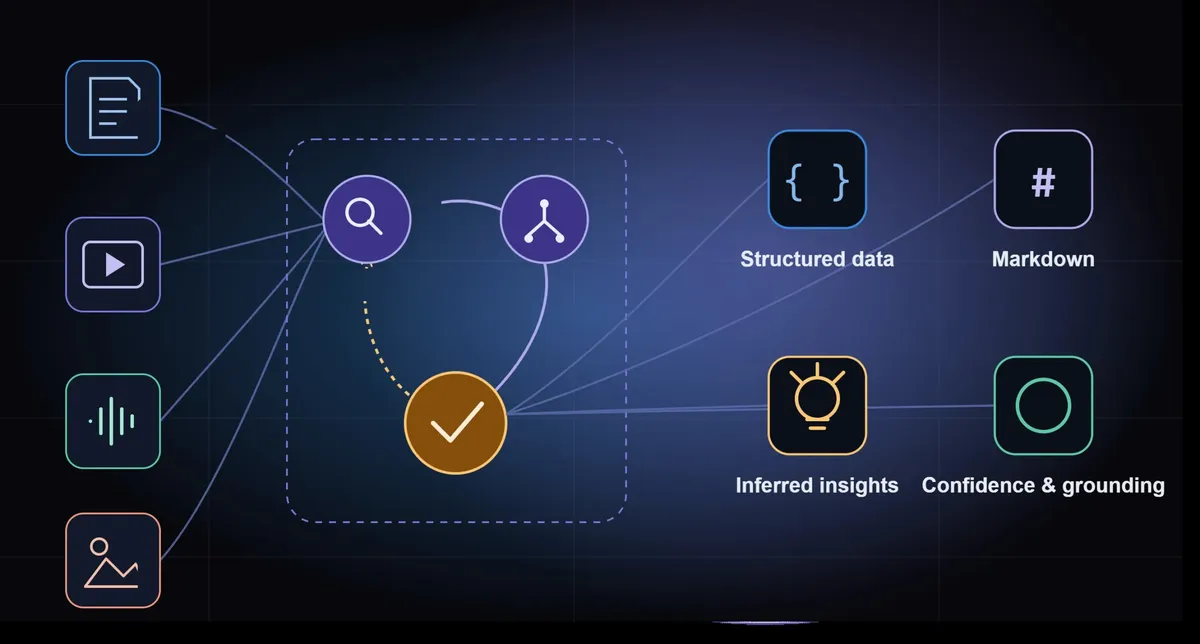
A támogatott mezőknél az elemző három fontos jelzést adhat vissza: a típusos, strukturált értéket, a bizonyosságot becslő pontszámot, valamint a dokumentumbeli bizonyítékhoz kapcsolódó forrásszakaszt, oldalt és koordinátákat. A dátumokat és számokat a rendszer kanonikus formára normalizálhatja.
Ez egy számlafeldolgozó folyamatban lehetővé teszi a rendelési számok és tételes összegek kinyerését, az eredmények üzleti szabályok szerinti ellenőrzését, a vitatott érték forrásának kiemelését, illetve a bizonytalan esetek emberi felülvizsgálatra küldését. A Microsoft szerint a dokumentumtípus ismerete olyan hibák korrigálásában is segíthet, mint amikor az OCR egy ezreselválasztó vessző helyett pontot olvas, így az 1,000 értékből 1.000 válhat.
Összetett megoldások és a taxonómiai benchmark eredményei
Az Azure Content Understanding katalógusában olyan összetett megoldások is szerepelnek, amelyek több dokumentumtípust kezelnek. A beszerzési, amerikai adózási és amerikai jelzáloghitel-felvételi megoldások osztályozást és útválasztást kapcsolnak össze a speciális kinyeréssel. A rendszer az egyes dokumentumszegmenseket felismeri, majd a megfelelő elemzőhöz és sémához irányítja.
A Microsoft 19 amerikai adóűrlap-kategórián hasonlította össze az Azure Document Intelligence-t, az Azure Content Understanding 1.0 GA-t és az Advanced Contextualization funkcióval működő Azure Content Understanding 2.0 Preview-t. Az egyenlő súlyozású átlagos F1-érték rendre 96,71 százalék, 97,41 százalék és 99,32 százalék lett. Az ezer oldalra modellezett költség 10, 16,23, illetve 8 dollár, a késleltetési index pedig 4,4, 10 és 4,9 volt, ahol az Azure Content Understanding 1.0 GA értéke 10.
A Microsoft számítása szerint a 2.0 Preview az 1.0 GA-hoz képest 1,91 százalékponttal javította az átlagos F1-értéket, 51 százalékkal csökkentette a modellezett költséget és 51 százalékkal mérsékelte az átlagos késleltetést. A kategóriaszintű eredményekben 17 esetben ért el magasabb F1-et, 18 kategóriában gyorsabb volt, a modellezett költsége pedig mind a 19 kategóriában alacsonyabb lett. A közölt költségek benchmarkbecslések, a tényleges összeg a használati mérőktől, a Foundry modellhasználatától és az aktuális díjaktól függ.
Microsoft Foundry: Azure Content Understanding Prebuilt Analyzers: packaging domain knowledge for document AI