192 GB memóriával érkezik a MINISFORUM helyi AI-munkaállomása
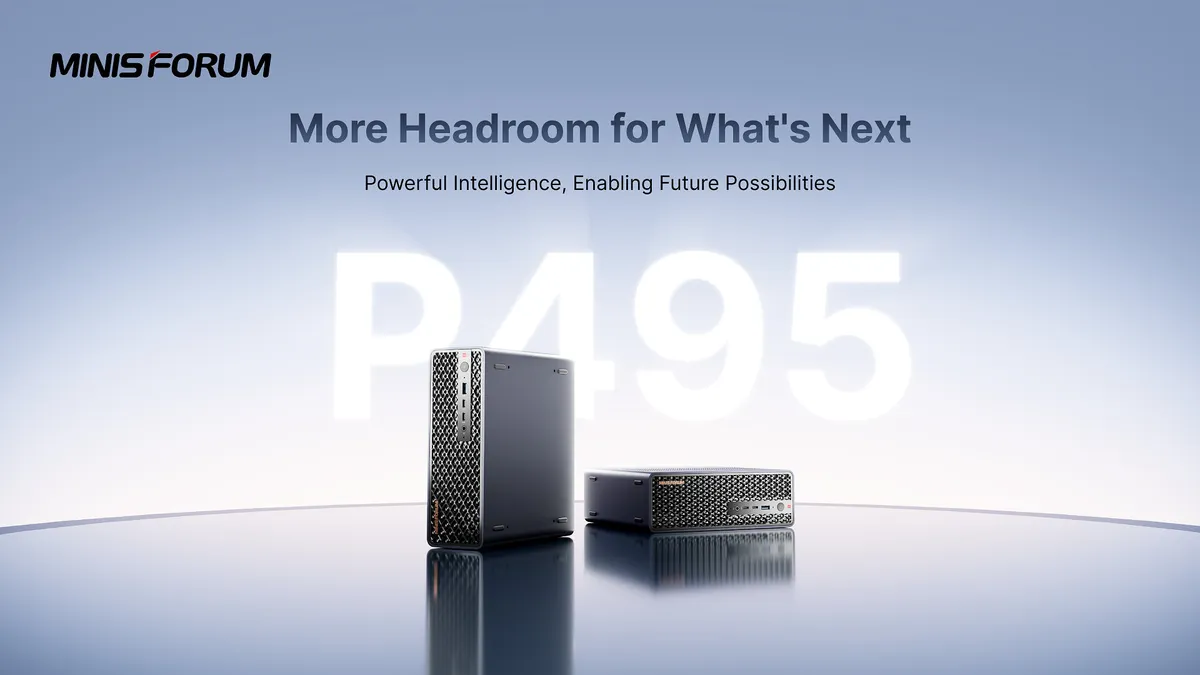
A MINISFORUM bemutatta az MS-S1 MAX-P495 helyi mesterségesintelligencia-munkaállomást, amely legfeljebb 192 GB egyesített memóriát és 160 GB kiosztható videómemóriát kínál. A vállalat szerint a rendszer egyetlen gépen 300 milliárd paraméteres nyelvi modellek futtatására is alkalmas.
- Az MS-S1 MAX-P495 legfeljebb 192 GB egyesített memóriát kínál.
- A kiosztható VRAM maximális kapacitása 160 GB.
- A rendszer a MINISFORUM szerint 300 milliárd paraméteres modelleket is futtat helyben.
- Két gép Qwen3.5-397B, négy rendszer pedig DeepSeek-R1 671B Q4 futtatására is használható a tesztek szerint.
- Az előrendelési ár kedvezménnyel 7399 dollár, a szállítás október közepén várható.
Erősebb processzor és nagyobb memóriakapacitás
Az MS-S1 MAX-P495 az AMD Ryzen™ AI Max+ PRO 495 processzorra épül. A Zen 5 architektúrájú chip 16 magot és 32 szálat tartalmaz, órajele legfeljebb 5,2 GHz lehet, a grafikus feladatokat pedig integrált Radeon™ 8065S Graphics egység kezeli.
A processzor NPU-ja legfeljebb 55 TOPS teljesítményt nyújt, a teljes AI-számítási teljesítmény pedig elérheti a 131 TOPS értéket. A MINISFORUM az eszközt AI-rajongóknak, fejlesztőknek, technológiai érdeklődőknek és professzionális alkotóknak szánja, akiknek nagyobb helyi számítási kapacitásra van szükségük.
A korábbi, AMD Ryzen™ AI Max+ 395 processzorral szerelt MS-S1 MAX modellhez képest a legfontosabb fejlesztés a memória és a videómemória kapacitása. Az egyesített memória felső határa 128 GB-ról 192 GB-ra, a kiosztható VRAM maximális mennyisége pedig 96 GB-ról 160 GB-ra nőtt.
Nagy nyelvi modellek egyetlen rendszeren
Az egyesített CPU-GPU memóriatér nagyobb mozgásteret ad a helyi AI-feladatokhoz. A vállalat közlése szerint az MS-S1 MAX-P495 helyben képes 300 milliárd paraméteres osztályba tartozó nagy nyelvi modellek futtatására.
A MINISFORUM tesztjeiben a DeepSeek V4 Flash 284B Q4 egyetlen rendszeren hozzávetőleg 12 token/másodperc sebességgel futott. A gyártó szerint a konfiguráció helyi következtetésre, AI-alkalmazások fejlesztésére és multimodális tartalomgenerálásra használható, valamint olyan professzionális munkafolyamatokra is, mint az AI-támogatott alkotás és a 3D-renderelés.
A bejelentés szerint a termék jelentősége a kompakt munkaállomáson kezelhető helyi AI-terhelések méretének növekedésében is rejlik. A MINISFORUM ezt a helyi AI-stratégiájának következő lépéseként mutatja be, amely a nagy teljesítményű önálló rendszerektől a bővíthető helyi számítási platformok felé halad.
Kétgépes klasztertől a rackes telepítésig
Az MS-S1 MAX-P495 teljesítménye több rendszer összekapcsolásával tovább bővíthető. Két, egyenként 192 GB memóriával rendelkező gép kétgépes klasztert alkothat, amely a vállalat tesztje szerint a Qwen3.5-397B modellt helyben, hozzávetőleg 16 token/másodperc sebességgel futtatta.
A rendszer 2U-s rackbe történő telepítést is támogat, így több egység elosztott klaszterbe kapcsolható. A MINISFORUM tesztjében egy négy rendszerből álló konfiguráció sikeresen futtatta a DeepSeek-R1 671B Q4 modellt, amelynek mérete 380 GB volt Q4_0 kvantálással.
A vállalat szerint ezzel az eszköz az egyetlen asztali rendszertől a kétgépes és több csomópontos telepítésekig terjeszti ki a helyi AI-számítást. Az MS-S1 MAX-P495 192 GB RAM-mal és 2 TB-os SSD-vel előrendelhető. A normál ár 9249 dollár, a 20 százalékos kedvezménnyel érvényes ár 7399 dollár. A szállítás várhatóan október közepén kezdődik.
PR Newswire: MINISFORUM Launches MS-S1 MAX-P495 with 192GB Unified Memory, Expanding Its Local AI Computing Strategy