MIT: a nagy képgeneráló modelleknél eltűnhet a kapcsolat a tanítóadatokkal
Az MIT Computer Science and Artificial Intelligence Laboratory kutatói 2026. augusztus 18-án ismertették új eredményüket a Nature Communicationsben megjelent nyílt hozzáférésű tanulmány alapján. A kutatás szerint nagy adathalmazokon tanított diffúziós képgenerátoroknál gyakran nem mutatható ki, hogy egy adott kép, alkotó vagy személy tanítóadata érdemben befolyásolta volna a kimenetet.
- Az MIT CSAIL kutatói az attribution decay jelenségét írták le diffúziós képgenerátoroknál.
- Nagy adathalmazoknál egy kép, egy művész képei vagy egy személy fotói eltávolítása gyakran nem változtatja meg érdemben a kimenetet.
- A kutatók diffusion ensemble architektúrával tényleges eltávolítást teszteltek újratanítás és közelítés nélkül.
- A vizsgálat 24 ensemble modellen, 256 képtől több mint 160 000 képig terjedő adathalmazokon futott.
- A szerzők szerint az eredmény fontos lehet a szerzői jogi és felelősségi kérdések megítélésében.
Mit találtak az MIT kutatói?
Az MIT CSAIL kutatói azt a jelenséget vizsgálták, hogy egy generatív modell kimenete mennyiben vezethető vissza a tanítóadatok konkrét elemeire. A tanulmányban ezt attribution decay néven írják le: minél több adattal tanítanak egy generatív modellt, annál kevésbé számít egy-egy konkrét tanító példa egy adott kimenetnél.
A kutatók szerint elég nagy skálán gyakran eltávolítható egyetlen kép a tanítóadatok közül, sőt akár egy adott művész összes képe vagy egy adott személy összes fotója is, miközben a generált minta nem változik érdemben. Az MIT közleménye ezt úgy fogalmazza meg, hogy ha az eltávolítás nem változtatja meg a kimenetet, akkor az adott adat nem tekinthető felelősnek azért a kimenetért.
Zheng Dai, a munka vezető szerzője, az MIT CSAIL korábbi kutatója a közleményben így fogalmazott: „Ha elveszünk egy adatdarabot, és a modell kimenete nem változik, akkor az az adatdarab nem befolyásolta a kimenetet.” Hozzátette, hogy ilyen esetben nincs sok értelme a kimenetet ahhoz az adathoz kötni, és ha ugyanez minden más adattal külön-külön is megtörténik, akkor egyetlen elemhez sem indokolt hozzárendelni a kimenetet.
Új módszer a tanítóadatok tényleges eltávolítására
A kérdés közvetlen tesztelése alapvetően nehéz: azt kellene megvizsgálni, mit generált volna a modell, ha egy adott képet soha nem lát. Ennek tiszta módja az lenne, hogy a modellt újratanítják az adott kép nélkül, majd ugyanezt megismétlik a következő képpel is. Több millió tanító példa esetén ez a megközelítés gyorsan kezelhetetlenné válik.
Az MIT kutatói ezért saját architektúrát építettek, amelyet diffusion ensemble néven írnak le. Egyetlen nagy modell helyett sok kisebb komponensből áll, és ezek különböző adatszeleteken tanulnak. Ha azt akarják megnézni, mi történt volna egy adott kép nélkül, egyszerűen kikapcsolják azokat a részeket, amelyek látták az adott képet. A közlemény szerint így nem becslést kapnak, hanem valódi ellenpéldás, vagyis kontrafaktuális modellt.
David Gifford, az MIT professzora és az MIT CSAIL vezető kutatója szerint a korábbi módszerek közelítések voltak. A közleményben azt mondta: „Ez a tanulmány vezeti be az első abszolút módszert. Valóban törlik a bemeneteket és a bemenetek minden hatását.”
A csapat azt is ellenőrizte, hogy az ensemble architektúra önmagában használható-e képgenerátorként. A rendszereket 24 hagyományos diffúziós modellel vetették össze, ugyanazokon az adatokon tanítva őket. A közlemény szerint a képek a szokásos mérőszámok alapján nagyjából hasonló minőségűek voltak. Dai szerint kevés adatnál a megoldás gyengén teljesít, több adattal viszont jobban skálázódik a hagyományos diffúziós modellhez képest.
Ellenpéldás univerzum 24 ensemble modellel
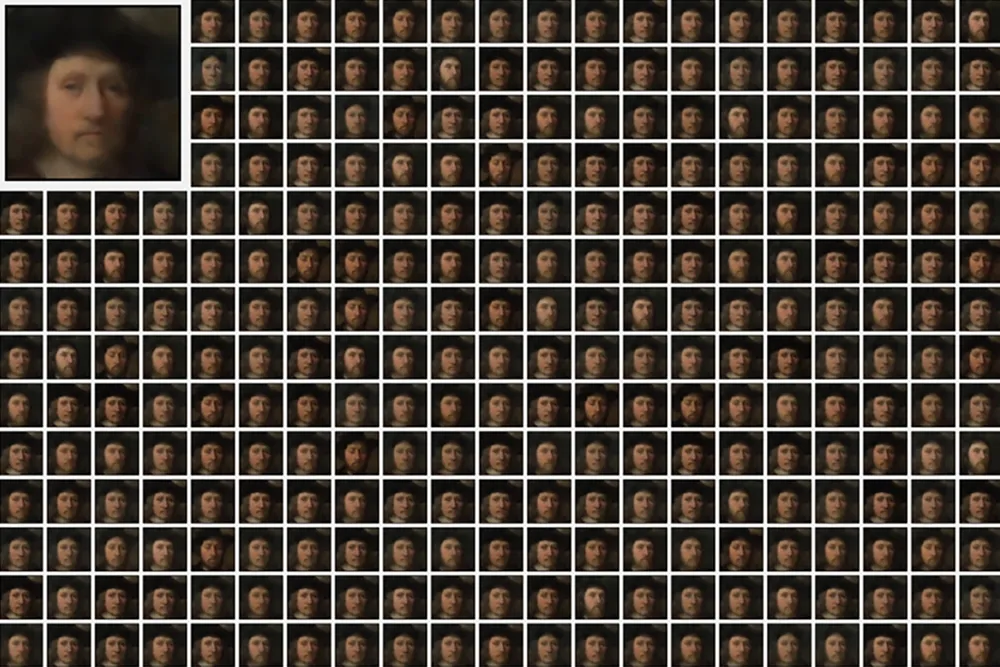
A kutatók a módszerrel minden generált képhez elképzelték annak alternatív változatait, amelyek úgy jöttek volna létre, hogy a tanítóadatokból más és más elemet távolítanak el. Ezt nevezték a kép counterfactual universe, vagyis ellenpéldás univerzumának. Az eredeti kép és a tőle leginkább eltérő alternatíva közötti távolságot counterfactual radius néven használták annak mérésére, hogy legfeljebb mennyit számíthatott egyetlen tanítóadat.
A kutatók 24 ensemble modellt tanítottak 256 képtől több mint 160 000 képig terjedő adathalmazokon. Az adatok hét nyilvános gyűjteményből származtak, köztük a CIFAR-10, a CelebA, a MetFaces és az ArtBench gyűjteményből.
Az eredmény a közlemény szerint következetes volt: minél nagyobb volt a tanítóhalmaz, annál kisebb lett a sugár, mégpedig inverz hatványtörvény szerint. A minta akkor is megmaradt, amikor a különbségeket képpontonként, illetve szemantikai jelentés alapján mérték, és mindkét esetben statisztikailag szignifikáns volt.
A csapat több ellenőrzést is végzett. Kis skálán nyers erővel is megismételték a vizsgálatot, 1 282 külön modellt tanítva, és a jelenség így is megjelent. Kipróbálták rögzített eltávolított aránnyal, rögzített epochokkal, szöveges prompttal irányított modellekkel, osztályfeltételes modellekkel és négy hasonlósági mérőszámmal is. A közlemény szerint az eredmény ezekben a próbákban is fennmaradt.
Szerzői jogi és iparági következmények
A kutatás közvetlenül kapcsolódik ahhoz a vitához, hogy a generatív modellek kimenetei tekinthetők-e származékos műveknek. Gifford szerint az eredmények felvetik, hogy ezek a modellek nem egyszerűen lemásolják, amit kaptak, hanem új kimeneteket hoznak létre. A közleményben úgy fogalmazott: „Ha ezeknek a kimeneteknek nincs közük egyetlen konkrét tanítóadat-darabhoz sem, az kérdéseket vet fel a fair use-ról, arról, hogy a kimenetek önmagukban szerzői jogi védelem alá eshetnek-e mint új művek, és arról, hogyan kapnak kompenzációt a szerzők, amikor ami kijön a modellből, nem rendelhető hozzá semmihez az interneten.”
Gifford azt is mondta, hogy a munka megmutatja, miként lehet olyan kimeneteket előállítani, amelyekről garantálható, hogy nem köthetők vissza egyedi adatokhoz. Ezt a kutató nem kiskapunak, hanem iparági kötelezettségnek tekinti. Szerinte ha a cégek azt akarják állítani, hogy kimeneteik nem jogsértő módon származékai az internetnek, akkor modelljeiket úgy kell módosítaniuk, hogy kihasználják a kutatás eredményeit.
A tanulmány diffúziós modelleket vizsgált. Az MIT közleménye szerint ezek ma meghatározók az audiovizuális médiagenerálásban, és tudományos alkalmazásokban is jelen vannak, például fehérjeszerkezet-modellezésben és terápiás felfedezésben. Az viszont nyitott kérdés marad, hogy ugyanez a leépülő hozzárendelhetőség érvényes-e a nagy nyelvi modellekre, amelyek több kiemelt szerzői jogi per középpontjában állnak.
James Grimmelmann, a Cornell Law School és a Cornell Tech jogászprofesszora szerint, ha a hozzárendelés működne, megbízhatóan megmutatná, hogy egy modell kimenete és egy szerzői joggal védett mű közötti hasonlóság másolásból vagy véletlen egybeesésből ered. A közleményben úgy értékelte, hogy a tanulmány okot ad azt gondolni: érdekes modelleknél a hozzárendelés kudarcot vallhat, ezért a technológusoknak és a bíróságoknak más módszerekhez kell nyúlniuk a másolás megítélésére.