Az MLPerf új benchmarkkal méri a nagy nyelvi modellek utótréningjét
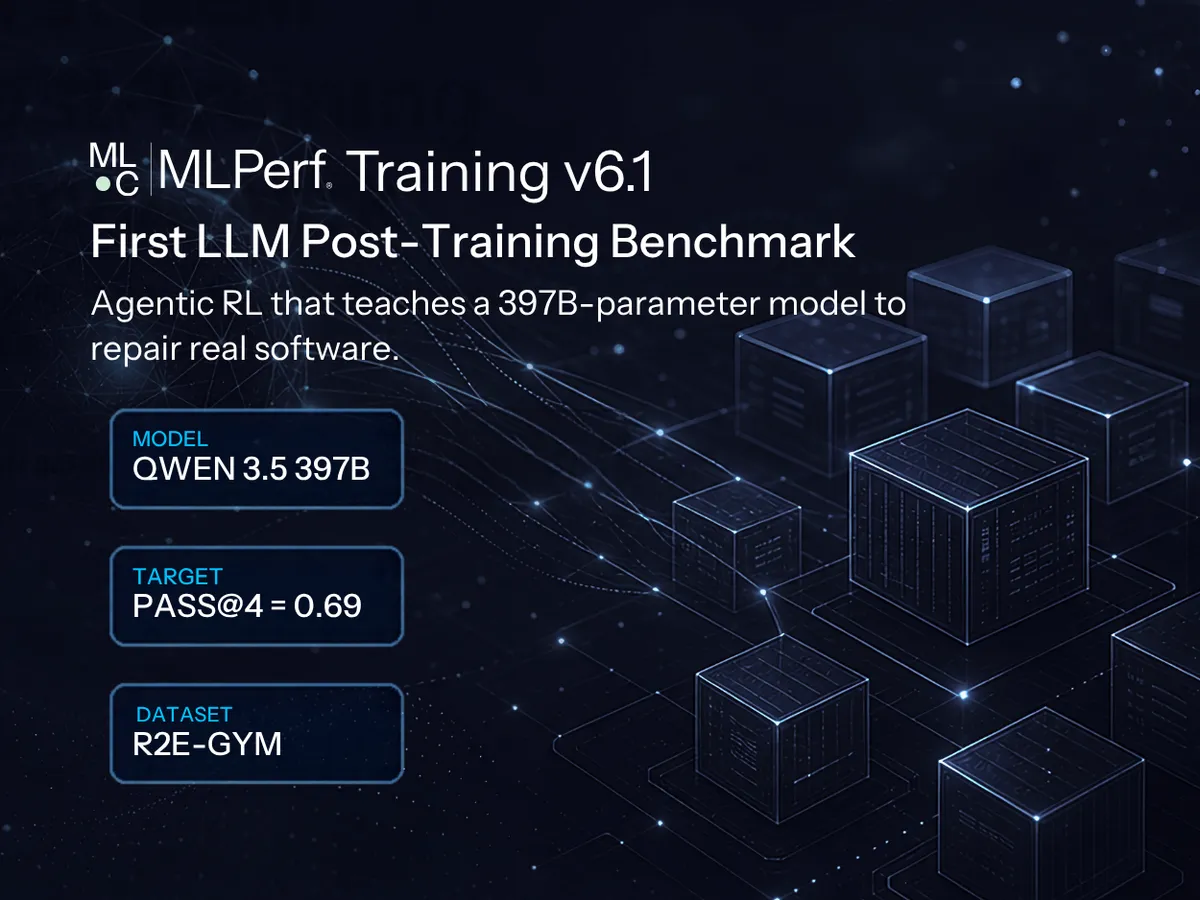
Az MLPerf Training első alkalommal külön benchmarkkal méri a nagy nyelvi modellek utótréningjét. A teszt a Qwen 3.5 397B modellt szoftverfejlesztési feladatokon, megerősítéses tanulással javítja, és a teljesítményt az elért pontosság figyelembevételével értékeli.
- Az MLPerf Training v6.1 fordulójában, 2026 októberében jelenik meg az első LLM-utótréning benchmark.
- A teszt a Qwen 3.5 397B modellt szoftverfejlesztési feladatokon tanítja tovább.
- Az adathalmaz 700 tanítási és 251 validációs problémát tartalmaz.
- A mérés a tanítási időt az elért pontossággal együtt értékeli.
Októberben indul az új mérési forduló
Az MLCommons közlése szerint az új LLM Post-Training benchmark az MLPerf Training v6.1-es beadási fordulójával, 2026 októberében jelenik meg. A mérés a meglévő, előtanításra épülő benchmarkokat egészíti ki.
Az előtanítás nagy mennyiségű adat feldolgozásával alakítja ki egy modell alapvető képességeit. Az utótréning ezt az alapot finomítja, hogy a rendszer meghatározott feladatokban jobban teljesítsen. Az MLCommons szerint 2025 második fele óta az LLM-ek fejlesztésében jelentős előrelépést hozott az utótréning skálázása. Példaként a kisebb modellek javuló teljesítményét, illetve az azonos alapmodellből kiinduló generációs fejlesztéseket említi.
A benchmark valós körülmények között végzett utótréninget modellez, amelynek egy futása 1024 GB300 óránál kevesebb idő alatt teljesíthető. A munkafolyamatban tanítási, következtetési és ügynöki környezeteket kell egyszerre működtetni. Több száz párhuzamos próbálkozás osztozik a processzoridőn, a GPU-kapacitáson, a memórián és a tárhelyen.
Szoftveres feladatokon tesztelik az utótréninget
Az MLPerf Reasoning Task Force a Reinforcement Learning with Verifiable Rewards, vagyis ellenőrizhető jutalmakkal végzett megerősítéses tanulást választotta. A módszer jól illeszkedik a szoftveres feladatokhoz. Egy nyelvi modell által vezérelt kódolási ügynök homokozott környezetben próbál megoldani szoftverfejlesztési problémákat. Egy próbálkozást rolloutnak neveznek, az eredmény pedig teljesítette vagy nem teljesítette értékelést kap.
A rendszer egy problémához több rolloutot készít, majd a kapott nyomokat a Group Relative Policy Optimization, röviden GRPO eljárás használja fel. Ez az egy csoporton belüli jutalmakat hasonlítja össze, és úgy frissíti a modellt, hogy a magasabb jutalmat elérő megoldások valószínűbbé váljanak. A frissített modell súlyai kerülnek a következő rolloutkörbe.
A tesztben a Qwen 3.5 397B szerepel, amely a Qwen 3.5 család 2026 februárjában kiadott legnagyobb modellje. A modell nyílt súlyokkal, Apache 2.0 licenc alatt érhető el. Összesen 397 milliárd paramétert tartalmaz, tokenenként pedig 17 milliárd aktív paraméterrel dolgozik. A Qwen 3.5 kevert szakértői modell, amely Gated DeltaNet rétegeket és ritka MoE rétegeket kombinál.
700 tanítási és 251 ellenőrzési feladat
A benchmark az Apache 2.0 licencű R2E-Gym adathalmazt használja. Ez futtatható környezetekben megoldható szoftveres problémákat tartalmaz, amelyeket több Python-projekt GitHub-commitjaiból hoztak létre, köztük az Aiohttp, a Datalad, a NumPy, a Pandas, a Pyramid, a Pillow, a Sympy és a Tornado projektből.
Az ügynök Linux-konténert kap egy Git-tárolóval, előre telepített függőségekkel és a problémát leíró utasítással. A feladata egy olyan javítás elkészítése, amely megoldja a hibát. A kiválasztott részhalmaz 700 tanítási problémából és egy egymást nem átfedő, 251 feladatból álló validációs készletből áll.
A mérés legfeljebb 65 536 tokenes kontextust, legfeljebb 30 ügynöki fordulót és promptonként 16 generációt engedélyez. Az értékeléshez az ügynök által nem látható és nem módosítható tesztfájlokat használnak, hogy megakadályozzák a jutalom kijátszását. Az OpenHands harness szolgál a tanítási és validációs feladatokhoz.
A pontosság és a sebesség együtt számít
Az MLPerf Training pontszáma nem egyszerű áteresztőképességi adat. A benchmark azt méri, mennyi idő alatt jut el a modell egy előre meghatározott pontossági szintre. Az MLCommons szerint ez azért fontos, mert a nagyobb sebesség önmagában olyan optimalizációkat is ösztönözhet, amelyek rontják a végső modellminőséget.
Az új benchmark így a hardverek és a szoftveres rendszerek teljesítményét az utótréning valós feladatán keresztül vizsgálja. A résztvevőknek egyszerre kell kezelniük a rolloutok, a tanítás és az ügynöki homokozók erőforrásigényét, miközben a modell általánosítható teljesítményét is meg kell őrizniük.
MLCommons: MLPerf Training Introduces Its First LLM Post-Training Benchmark