Nyílt forráskódú eszközzel keresné meg az AI-feladatok valódi hibáit az NVIDIA
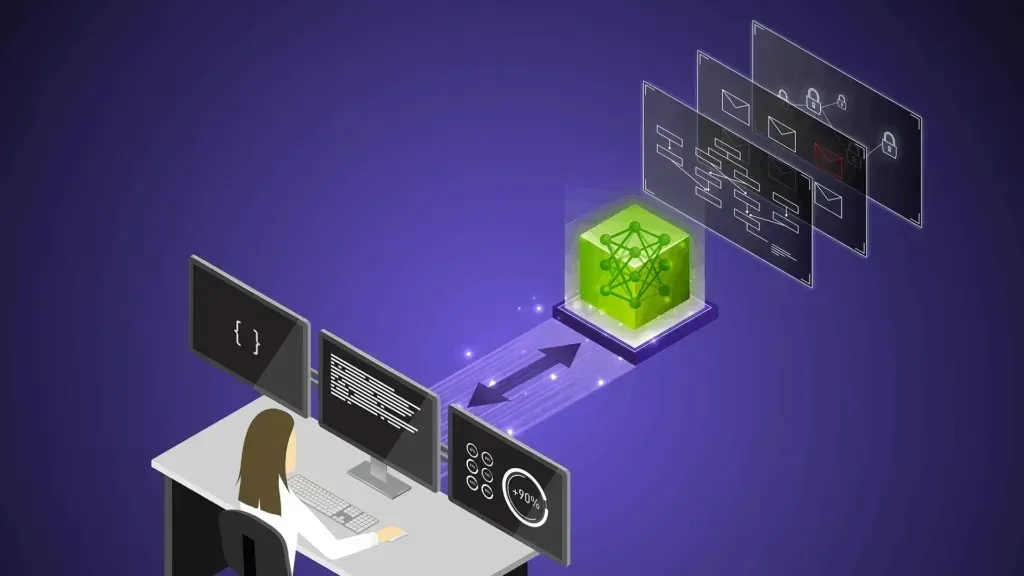
Az NVIDIA nyílt forráskódú Attribution rendszere az elosztott AI-feladatokhoz kapcsolódó naplókat, metrikákat, telemetriai adatokat és ütemezői állapotokat kapcsolja össze. A cél, hogy a rendszer megkülönböztesse a hiba valódi okát a később megjelenő tünetektől.
- Az NVIDIA Attribution naplókat, metrikákat, telemetriát és ütemezői állapotot kapcsol össze.
- A rendszer strukturált diagnózist ad a gyökérok, a tünetek és az érintett csomópontok megjelölésével.
- Az Attribution Service REST API-t biztosít, a Blueprint pedig a fürtspecifikus integrációt kezeli.
- A bemutatott példában egy node-02-n jelentkező NVLink-jelintegritási hiba okozza a későbbi NCCL-tüneteket.
- Az eszköz nyílt forráskódú, és Slurm-, Kueue-, Loki- és PromQL-csatlakozókat is tartalmaz.
A jelentett hiba nem feltétlenül a kiváltó ok
Az elosztott AI-munkaterhelésekben egyetlen hiba számos további tünetet indíthat el. Egy GPU- vagy hálózati esemény például más rangokon NCCL-hibákként, az ütemező állapotának változásaként és több ezer naplóüzenetként jelenhet meg. A munkaterhelés által jelentett kivétel ezért azt mutatja meg, hol állt le a folyamat, de nem feltétlenül azt, hol kezdődött a meghibásodás.
Az NVIDIA Attribution munkaterhelés-központú megközelítést használ. A rendszer egy adott munkaterhelés kontextusában elemzi az eseményeket, majd strukturált eredményt ad: tartalmazza a kimenetet, a gyökérokot, az érintett csomópontokat, a támogató tüneteket és a bizonyítékok nyomvonalát. A vállalat szerint a determinisztikus szabályok reprodukálhatóvá és testre szabhatóvá teszik az eredményeket.
Két komponens gyűjti és elemzi a bizonyítékokat
A rendszer két telepíthető részből áll. Az NVIDIA Attribution Service REST API-n keresztül teszi elérhetővé a központi attribúciós motort, az NVIDIA Attribution Blueprint pedig összeköti azt a fürt ütemezőivel és telemetriai forrásaival, majd elmenti az eredményt.
A Blueprint végrehajtási környezethez Slurm-, Kueue- és statikus bemeneti csatlakozókat tartalmaz. A napló- és metrikaforrások között szerepel a Loki, a helyi fájlok, a Kubernetes podnaplói és a PromQL-metrikák. A folyamat először azonosítja a munkaterhelés egy próbálkozását az ütemező azonosítói, vagy egy megadott időablak és csomópontkiosztás alapján. Ezután a csatlakozók munkaterheléshez kötött megfigyeléseket készítenek az alkalmazásnaplókból, a rendszernaplókból, a GPU-illesztőprogram és a Fabric Manager üzeneteiből, az ütemezési előzményekből, valamint a csomópont- és hálózati metrikákból.
A szolgáltatás strukturált eseményekké alakítja és összekapcsolja az adatokat. A szabályok többek között GPU XID-eseményeket, NCCL-hibákat, ütemezői átmeneteket és metrikafeltételeket vizsgálnak, majd elválasztják a későbbi tüneteket a meghibásodást kiváltó eseménytől.
Egy NVLink-hiba elválasztása a későbbi NCCL-hibáktól
Az NVIDIA bemutatott példájában egy több rangon futó tanítási munkaterhelés egyik GPU-ja súlyos hibát jelez, az XID 149-et. Ezt követően több rangon NCCL-hibák jelennek meg. A szintetikus munkaterhelésben a rendszer naplója a node-02 csomóponton olyan XID 149-es eseményt tartalmaz, amelynek hibaszavai NVLink-jelintegritási problémát jeleznek.
Az attribúciós folyamat korai szűrési szakasza dekódolja ezt a bizonyítékot, és a node-02 csomópontot a jelminőségi hibához kapcsolja. A három NCCL-esemény közben változatlanul megmarad. A későbbi finomítás a jelminőségi problémát gyökérok-jelöltként tartja meg, a többi csomóponton jelentkező tüneteket pedig leminősíti, miközben azok forrása továbbra is vizsgálható marad.
A példa eredménye hardverhibát állapít meg, a munkaterhelés hibáját nem egymástól független kommunikációs problémák soraként kezeli. Ha több ok is illeszkedik a bizonyítékokra, az eredmény kétértelműként jelöli az érintett aldomaint. Az NVIDIA szerint a diagnózis minősége az alapul szolgáló telemetria teljességétől és minőségétől függ.
Fürtökön futó rendszerekhez készült
Az NVIDIA közlése szerint az Attributiont évek óta használják a vállalat AI-infrastruktúrájában. A rendszer hetente több millió munkaterhelést elemez több százezer GPU-n. Egy nagy, RDMA-alapú fürtben portokra, kapcsolat-visszaállításokra és ütemezői eseményekre vonatkozó adatokat kapcsolt össze, és meghatározott gazdagép- és kapcsolóportok körül azonosított hibamintákat. Ez a vállalat szerint segített a hálózati javítások és a torlódáskezelés célzásában.
A forráskód és a mintamunkaterhelések az NVIDIA Attribution tárházában érhetők el. A gyorsútmutatóval a minta munkafolyamata helyi irányítópulton futtatható, a konfigurációs referencia pedig saját ütemezők és telemetriai háttérrendszerek csatlakoztatását mutatja be. Az NVIDIA Attribution a vállalat szerint kiegészíti a készenléti ellenőrzéseket, a folyamatos állapotfigyelést, valamint az infrastruktúrát javító és a munkaterheléseket újraindító rendszereket.
NVIDIA Developer: Diagnose Distributed AI Workload Failures with NVIDIA Attribution