Az NVIDIA FLARE egy rendszerben kezeli a Dockert, a Kubernetes-t és a Slurmet
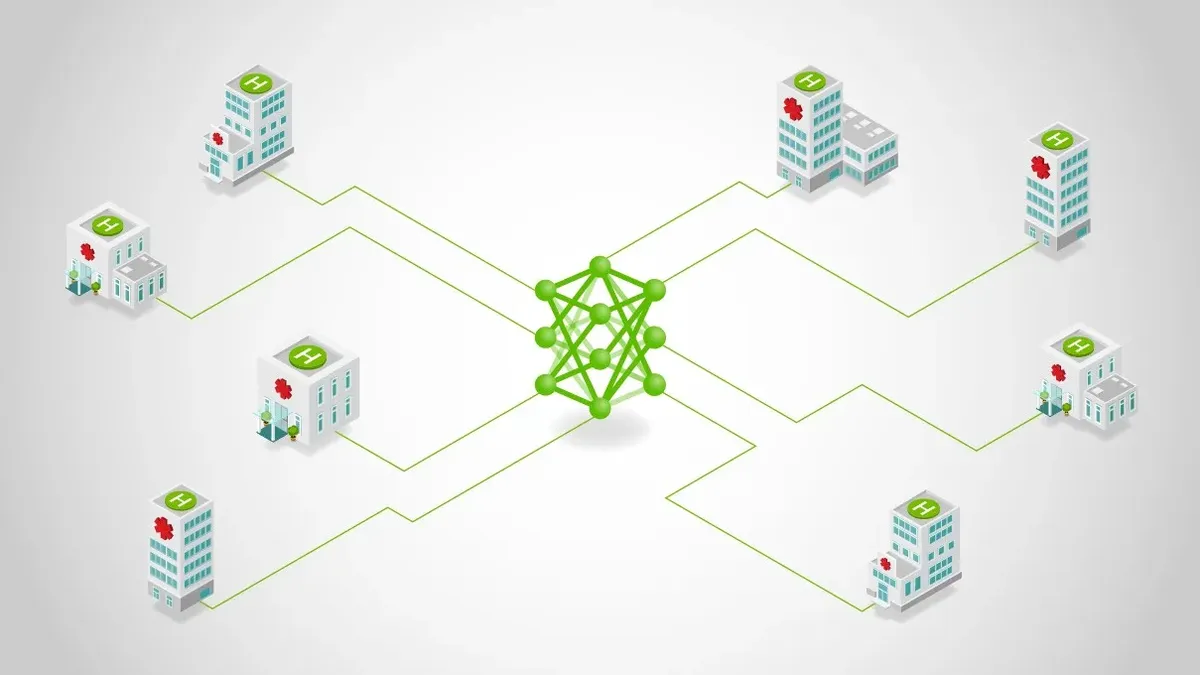
Az NVIDIA FLARE új architektúrája lehetővé teszi, hogy egy federált tanulási rendszer résztvevői eltérő infrastruktúrákon futtassák a feladatokat. Az egyik helyszín Dockert, a másik Kubernetes-t, egy kutatóközpont pedig Slurmet használhat, miközben a federáció koordinációja folyamatosan működik.
- Az NVIDIA FLARE különválasztja a tartós federációs szolgáltatásokat és a feladatmunkásokat.
- A FLARE 2.8 Docker- és Kubernetes-, a 2.9-es verzió Slurm-támogatást kínál.
- A munkások igény szerint kaphatnak GPU-t, CPU-egységeket és gazdagépmemóriát.
- A tanulmányok logikai határt adnak a felhasználók, feladatok és helyi adatok elkülönítéséhez.
- A helyi üzemeltetők megtartják az erőforrások, képek, titkok és ütemezési szabályok feletti kontrollt.
Különválik a koordináció és a számítás
Az NVIDIA Developer szeptember 15-én bemutatott leírása szerint az NVIDIA FLARE két működési rétegre bontja a federált tanulási környezetet. A hosszú ideig futó szerver- és kliensszülőfolyamatok tartják fenn a federációt, hitelesítik a kapcsolatokat és koordinálják a munkát. A tényleges feladatokat külön szerver- és kliensmunkások végzik.
Amikor egy adattudós feladatot küld be, a szülőfolyamat a helyben beállított végrehajtási platformon indít munkást. A munkás megkapja a feladatot, felhasználja a kért erőforrásokat, visszaadja az eredményt, majd a munka befejezése után leáll. Így a szülőfolyamatok elérhetők maradhatnak anélkül, hogy közben a tanításhoz szükséges GPU-kat foglalnák.
A feladat külön adja meg az erőforrásigényt és a platform részleteit. GPU-kat, ütemezhető CPU-egységeket és a gazdagép memóriáját kérheti. A helyi indító ezeket a követelményeket a tanulmány helyi beállításaival együtt Docker-konténerre, Kubernetes-podra vagy Slurm-allokációra fordítja le.
A Docker, a Kubernetes és a Slurm eltérő szerepet kap
Az NVIDIA FLARE 2.8-as verziója Docker- és Kubernetes-telepítési támogatást hozott, a 2.9-es kiadás pedig Slurm-támogatással bővült. Docker esetén a tartós FLARE-szerver vagy -kliens egy szülőkonténerben fut, a beküldött feladatokhoz pedig külön munkáskonténerek indulnak. A szülő- és munkásképek szétválasztása lehetővé teszi, hogy az infrastruktúra gazdája stabilan tartsa a környezetét, miközben a kutatók saját tanítási környezetet használhatnak, a helyi kép- és kódjóváhagyási szabályok mellett.
Kubernetesben egy Helm-diagram telepíti a tartós szerver- vagy kliensszülőt podként. Minden feladathoz külön szerver- vagy klienspod jön létre, amelyet a Kubernetes ütemezője a CPU-, memória-, GPU-, tárhely- és elhelyezési követelmények alapján helyez el. A rendszer használhat névtereket, szolgáltatásfiókokat, titkos kulcsokat, tartós köteteket, csomópontválasztókat és szerepköralapú hozzáférés-szabályozást.
Slurm esetén minden munkás kötegelt feladatként kerül beküldésre. A fürtütemező választja ki a csomópontokat, és érvényesíti a GPU-, CPU-, memória-, partíció-, fiók-, szolgáltatásminőségi és időkorlátokat. A FLARE egy- vagy többcsomópontos allokációkat is beküldhet, figyeli azok állapotát, valamint szükség esetén leállítja őket. A támogatott futtatási módok között a közvetlen végrehajtás, a Pyxis/Enroot és az Apptainer konténerei szerepelnek.
A tanulmányok logikai határt képeznek a közös rendszeren belül
A közös infrastruktúrán több kutatócsoport is futtathat federált tanulási feladatokat. Az NVIDIA FLARE tanulmányai logikai több-bérlős határt biztosítanak egyetlen telepítésen belül. Minden tanulmány meghatározza a részt vevő klienshelyszíneket és azokat az adminisztrátorokat, akik munkamenetet nyithatnak hozzá.
A tanulmányhoz kötött műveletek korlátozzák a feladatok láthatóságát, a kliensek állapotának megtekintését, a beküldési célokat és a telepítési térképeket. A részt vevő helyszíneken egy helyben kezelt local/study_runtime.yaml fájl kapcsolja össze a tanulmányt az elérhető erőforrásokkal. Ebben többek között adatkészlet-csatolások, környezeti változók, titkos kulcsokra hivatkozó beállítások, jóváhagyott alapértelmezett képek és a futtatási platform szabályai szerepelhetnek.
Az adattudós tanulmányhoz kötött munkamenetből küldi be a feladatot, amely örökli a tanulmány környezetét. A feladat nem választhat tetszőleges helyi adatelérési utat, és nem adhat meg titkos értékeket. A FLARE-szerver ellenőrzi a tanulmányi tagságot, a helyi üzemeltető pedig továbbra is maga szabályozza, hogy a tanulmány mely adatokhoz, képekhez, titkokhoz és számítási erőforrásokhoz férhet hozzá.
A helyi üzemeltetők megtartják az erőforrások feletti kontrollt
Az architektúra lényege, hogy az együttműködő szervezeteknek nem kell ugyanazt a végrehajtási környezetet használniuk. A Docker egy munkaállomáson vagy egyetlen gazdagépen működő helyszínhez illeszkedhet, a Kubernetes felhős vagy helyben üzemeltetett fürtökhöz, a Slurm pedig nagy teljesítményű vagy megosztott GPU-fürtökhöz.
Az NVIDIA szerint a FLARE biztosítja a résztvevők hitelesítését, a biztonságos kommunikációt és a jogosultságkezelést, miközben a helyi végrehajtási platform érvényesíti a saját erőforrás- és munkaterhelési szabályait. A gazdák állítják be a jóváhagyott képeket, titkokat és hozzáféréseket, továbbá nekik kell ellenőrizniük a munkaterhelések elkülönítését a választott futtatási környezetben.
NVIDIA Developer: Scaling Federated Learning Across Docker, Kubernetes, and Slurm with NVIDIA FLARE