Az NVIDIA FLARE a többhelyszínes multimodális AI-tanítást célozza
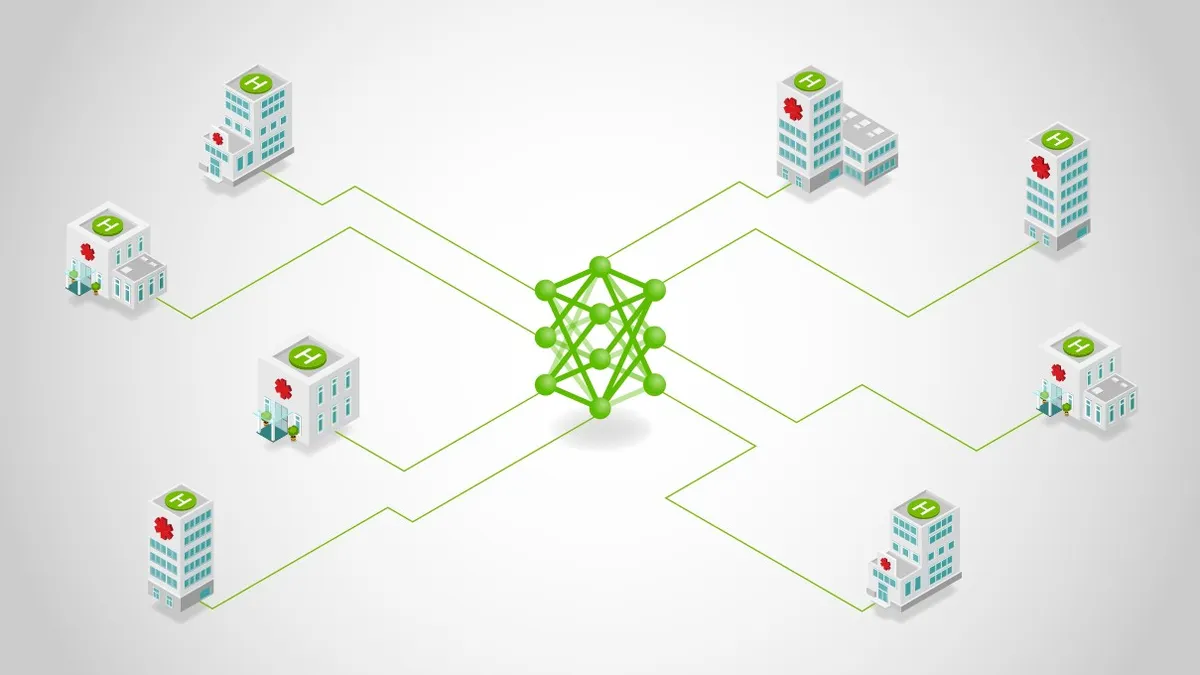
Az NVIDIA Developer 2026. augusztus 19-én ismertette, hogyan használható az NVIDIA FLARE federált multimodális AI-munkafolyamatokhoz. A cikk fő témája, hogy a különböző helyszíneken lévő adatok mellett miként lehet hatékonyan továbbítani és összesíteni a modellfrissítéseket.
- Az NVIDIA FLARE federált multimodális AI-munkafolyamatok koordinálására használható.
- A keretrendszer külső objektumkezelést, tensor streaminget és lemezalapú összesítést kínál nagy frissítésekhez.
- A FedUMM fagyasztott BLIP3o gerinc fölött LoRA adaptereket federál.
- Nyolc kliensnél a kommunikáció 28.6 GB-ról 0.094 GB-ra csökkent kliensenként és körönként.
- A kísérletek szimulált helyszíneken, szintetikus partíciókkal és nyilvános benchmarkokon futottak.
A multimodális modellek federált tanítása külön mérnöki feladat
A modern vision-language modellek, vagyis képi és nyelvi modellek olyan feladatokat támogathatnak, mint a vizuális kérdésmegválaszolás, a képaláírás-készítés és a kép-szöveg alapú következtetés. Az NVIDIA Developer bejegyzése szerint a gyakorlatban az ilyen modellek finomhangolásához szükséges adatok gyakran több intézménynél vagy szervezetnél vannak, amelyek nem tudják központosítani a nyers adataikat.
Erre kínál megoldási irányt a federált tanulás, amelyben a tanítás összehangolása több adatot helyben tartó résztvevő között történik. A forrás szerint a vision-language modelleknél a kihívás nem csak a vezérlés: a helyszínek eltérő feladatokat vagy modalitásokat adhatnak hozzá, a modellfrissítések pedig olyan nagyok lehetnek, hogy terhelik a hálózati sávszélességet és a szervermemóriát.
Az NVIDIA két tervezési kérdésre helyezi a hangsúlyt. Az egyik, hogy milyen modellállapot hagyhatja el az adott helyszínt, a másik, hogy ezt miként lehet hatékonyan továbbítani és összesíteni. A bejegyzés szerint az NVIDIA FLARE a helyszínek közötti federált tanítást koordinálja, és nagy frissítéseknél külső objektumkezelést, tensor streaminget és lemezalapú összesítést használhat.
Mit végez a FLARE a klienseken és a szerveren?
Az NVIDIA FLARE nyílt forrású, bővíthető Python SDK és keretrendszer federált tanuláshoz és kollaboratív számításhoz. A bejegyzés szerint minden FLARE-feladat szétválasztja a globális koordinációt és a helyi végrehajtást: a szerver ütemezi a köröket és összesíti a frissítéseket, miközben az egyes kliensek a saját helyi adataikon tanítanak vagy értékelnek.
A helyspecifikus előfeldolgozás, a promptok összeállítása és a batchek kezelése a kliensen belül marad. A forrás a NVIDIA FLARE Recipe API-t nevezi meg kiindulópontként, amelyben a FedAvg recept egy modellt párosít egy kliensoldali tanítószkripttel. Ugyanez a recept szimulációban és valódi, előkészített többhelyszínes telepítésben is futtatható.
Az NVIDIA szerint a megvalósítás előtt meg kell határozni az úgynevezett kliensfrissítési szerződést: mi marad helyben, mi hagyhatja el a helyszínt, mely modellkomponenseket frissítheti az adott kliens, és milyen metrikák térnek vissza a szerverhez. Ha a kliensek különböző modellkomponenseket frissítenek, annak módját is rögzíteni kell, hogy ezek a komponensszintű frissítések hogyan kombinálhatók.
Három eszköz a nagy modellfrissítések kezelésére
A forrás szerint a federált vision-language tanítás egyik gyakori alapmódszere a teljes modellparaméterek finomhangolása és összesítése. Ez nagy modellfrissítéseket eredményez, sok kliens esetén pedig kétféle memóriaterhelést okoz: egy frissítés szerializálását és átvitelét, valamint több kliensfrissítés egyidejű tárolását az összesítés alatt.
Az NVIDIA FLARE több funkcióval kezeli ezt a problémát. A nagy objektumok külső kezelése során a rendszer a nagy objektumokat könnyű hivatkozásokkal helyettesítheti az üzenetben, az adatokat pedig külön továbbíthatja. Ez kisméretű vezérlőüzenetet eredményez, és a forrás szerint olyan terheléseket is támogat, amelyek meghaladják a szokásos szerializált üzenetkorlátot.
PyTorch-munkafolyamatoknál a FLARE Tensor Downloader a tensort darabonként, pull-alapú protokollal streameli. Egyszerre csak a kért darab szerializálódik, ami csökkenti a csúcsmemória-igényt a modell terjesztésekor. A darabméret hangolható a kérések többletterhelése és az egy darabra jutó memóriaigény között. A TensorFlow-munkafolyamatok a hagyományos szerializációs útvonalat használják.
Az NVIDIA FLARE 2.8.0-ban a tensor disk offload az érkező PyTorch FedAvg-frissítéseket ideiglenes safetensors fájlokba írja, és szükség szerint tölti be. A bejegyzés szerint ezzel elkerülhető, hogy a szerver CPU-memóriaigénye lineárisan nőjön a kliensek számával.
FedUMM: kisebb frissítések fagyasztott BLIP3o gerinccel
A FedUMM a William & Mary és az NVIDIA együttműködésében készült példa arra, hogyan lehet kevesebb adatot mozgatni a hálózaton. A projektet a NVIDIA Academic Grant Program támogatta, és Outstanding Student Paper Award díjat kapott a FL@FM workshopon a TheWebConf 2026 konferencián.
A FedUMM-ben minden szimulált kliens fagyasztott BLIP-gerincet tart helyben, és LoRA adaptereket tanít lokálisan. Az NVIDIA FLARE koordinálja a köröket, és csak az adapterfrissítéseket összesíti. A forrás szerint a FedUMM általános felépítésre készült, modalitásspecifikus kódolókkal látáshoz, hanghoz és szöveghez, de a jelenlegi kísérletek a vision-language feladatokra koncentrálnak.
A közölt kísérletek a VQA v2 és a GenEval benchmarkokat értékelték, Dirichlet-vezérelt heterogenitással, legfeljebb 16 klienssel. Egy nyolcklienses összehasonlításban az adapter-only federáció kliensenként és körönként 28.6 GB-ról 0.094 GB-ra csökkentette a kommunikációt, miközben a teljes modelles FedAvg-hoz képest 0.7 ponttal javította a VQA v2 eredményt. Nyolc kliensnél a teljesítmény mindkét benchmarkon a központosított referencia körülbelül 97 százalékán maradt.
Az NVIDIA külön jelzi, hogy az értékelés szimulált helyszíneket, szintetikus partíciókat és nyilvános, általános célú benchmarkokat használ. A bejegyzés szerint ez nem igazol klinikai teljesítményt vagy formális adatvédelmi garanciákat, azt mutatja, hogy a nyers tanítóadat a szimulált federált munkafolyamatban helyben marad.
Mit jelent ez a fejlesztőknek és a piacnak?
A bejegyzés alapján a federált multimodális AI-munkafolyamatok tervezésénél a fejlesztőknek egyszerre kell dönteniük a frissítések tartalmáról és azok kezeléséről. Az NVIDIA ellenőrzőlistája a frissítési szerződés meghatározását, a könnyű adapterekkel csökkentett hasznos terhet, a megfelelő továbbítási mechanizmus kiválasztását, valamint a kommunikáció, futásidő és memóriahasználat végponttól végpontig tartó mérését emeli ki.
A FedUMM azt mutatja be, hogy bizonyos munkafolyamatokban az adapterek cseréje jelentősen csökkentheti a kommunikációs terhet. Más esetekben, amikor nagyobb frissítéseket kell küldeni, a tensor streaming és a lemezalapú összesítés adhat eszközt a memóriaterhelés mérséklésére. Az NVIDIA a következő lépések között a FLARE Recipe API kipróbálását, a FedUMM FLARE repositoryban lévő implementációjának áttekintését és az NVIDIA Flare Day 2026 regisztrációját ajánlja.
NVIDIA Developer: Building Federated Multimodal AI Workflows with NVIDIA FLARE

