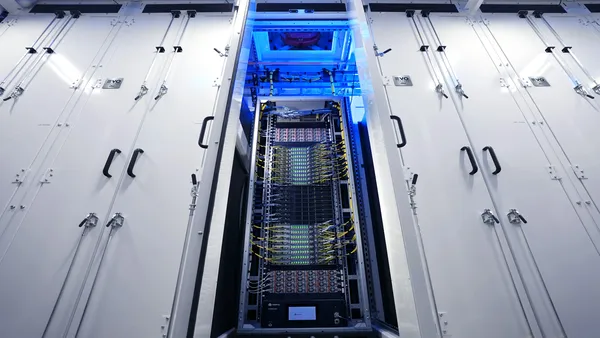
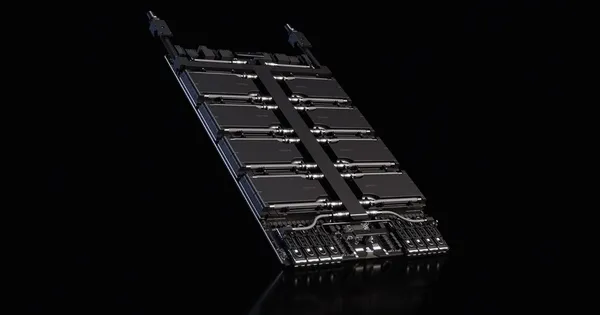
Elérhetővé vált a CoreWeave felhőjében az NVIDIA HGX B300
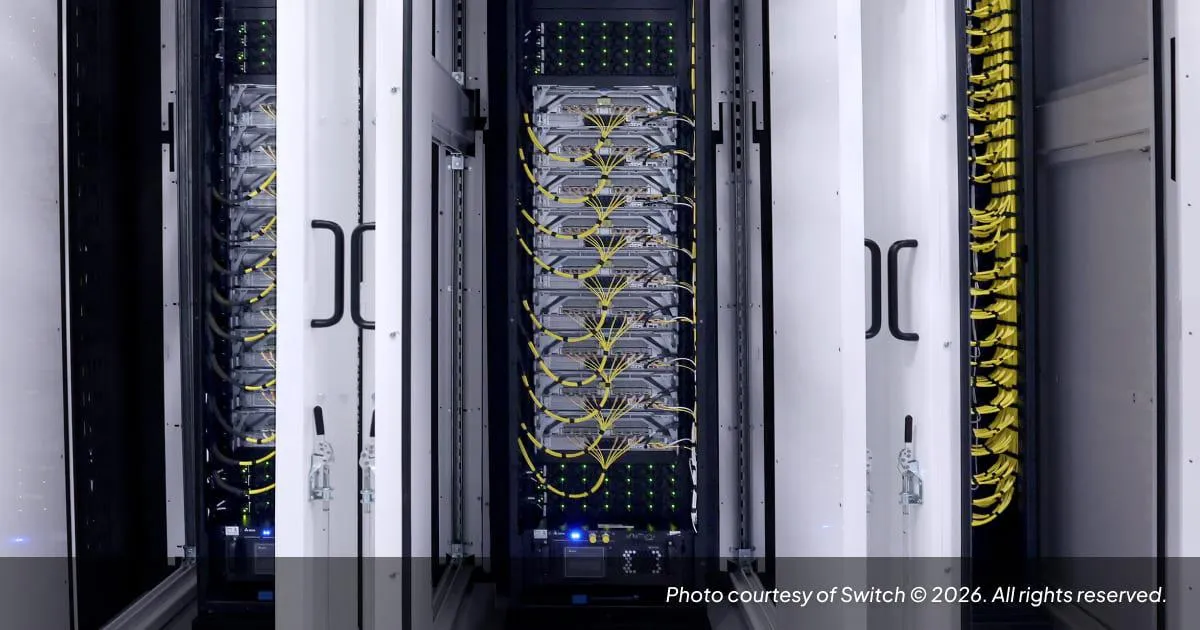
A CoreWeave általánosan elérhetővé tette felhőjében az NVIDIA HGX B300 gyorsítórendszert. A vállalat szerint a platformot már olyan AI-fejlesztők is használják, mint a Cursor, és a rendszer az agentikus AI nagy memória- és hálózati igényeire készült.
- Általánosan elérhetővé vált az NVIDIA HGX B300 a CoreWeave Cloudban.
- A rendszer 270 GB GPU-memóriát és 14 PFLOPS NVFP4-teljesítményt kínál.
- A CoreWeave szerint a Kimi K2.5 token-előállítása 3,42-szer gyorsabb a HGX H200-hoz képest.
- A DeepSeek-R1 teljes kéréskésleltetése a vállalat mérése szerint 4,93-szor gyorsabb.
- A Cursor és a Decart AI a HGX B300 használata felé tart.
Az agentikus AI új infrastruktúrát igényel
A CoreWeave 2026. október 22-i bejelentése szerint az NVIDIA HGX B300 mostantól általánosan elérhető a CoreWeave Cloud szolgáltatásában. A vállalat az agentikus AI terjedésével indokolja a fejlesztést. A hosszú kontextusablakok több memóriát, a többlépcsős következtetés tartós GPU-kihasználtságot, az ügynökök összehangolása pedig alacsony késleltetésű, nagy sávszélességű kapcsolatokat kíván a nagy klaszterek között.
A CoreWeave közlése szerint az NVIDIA HGX B300 az NVIDIA Quantum-X800 InfiniBand hálózatot, az NVIDIA BlueField-3 adatfeldolgozó egységeit és a 800 Gbps sebességű NVIDIA ConnectX-8 SuperNIC adaptereket használja. A rendszer GPU-memóriakapacitása 50 százalékkal nagyobb az NVIDIA HGX B200 modellénél.
Nagyobb memória és gyorsabb következtetés
Az NVIDIA HGX B300 GPU-nként 270 GB memóriát kínál, szemben a HGX B200 180 GB értékével. Ez a CoreWeave szerint lehetővé teszi nagyobb modellek és hosszabb kontextusablakok közvetlen futtatását nagy sávszélességű memóriában, így csökkenhet a külső memóriarétegektől való függés és a memóriaigényes feladatok késleltetése.
A vállalat adatai alapján az NVFP4 teljesítménye 9 PFLOPS-ról 14 PFLOPS-ra nőtt. A rendszer FP32, FP16, BF16 és FP8 formátumoknál megőrzi a HGX B200 teljesítményprofilját. Mindkét platform 1,8 TB/s GPU-nkénti összekapcsolási sávszélességet, 14,4 TB/s összesített NVSwitch-sávszélességet és 7,7 TB/s memória-sávszélességet biztosít.
A CoreWeave saját mérései szerint a HGX B300 a Kimi K2.5 modellen 3,42-szer gyorsabb token-előállítást, a DeepSeek-R1 esetében pedig 4,93-szor gyorsabb teljes kéréskésleltetést ért el az NVIDIA HGX H200 rendszerhez képest.
Eszközök a fejlesztéstől az éles üzemig
A CoreWeave a HGX B300-at saját, AI-ra kialakított felhőszoftvereivel együtt kínálja. A Mission Control valós idejű betekintést ad többek között az NVIDIA NVLink teljesítményébe és a GPU-k kihasználtságába, miközben a klaszterek üzemeltetését és életciklus-kezelését a szolgáltatóra bízza.
A CoreWeave Kubernetes Service, vagyis a CKS, nagy léptékű, elosztott AI-rendszerek telepítését, skálázását és kezelését támogatja. A Slurm on Kubernetes, röviden SUNK, több kísérlet párhuzamos futtatását és a GPU-k hatékonyabb kihasználását szolgálja. Az értékeléshez és hibakereséshez a W&B Weave biztosít eszközöket, köztük az ügynökfuttatások végpontok közötti követését.
A CoreWeave AI Object Storage adat-hozzáférési sebessége a közlés szerint GPU-nként akár 7 GB/s lehet. A vállalat 96 százalékos goodputot is megad, vagyis állítása szerint a kért számítási kapacitás közel egésze hasznos munkára fordítható.
A Cursor és a Decart már a gyártási használat felé tart
A CoreWeave szerint a Cursor már gyártási munkaterheléseket futtat a platformon, és korábban NVIDIA HGX B200 rendszert használt. Aman Sanger, a Cursor társalapítója úgy fogalmazott, hogy a kiszámítható teljesítmény, az üzemeltetési megbízhatóság és a változó követelményekhez igazodó támogatás fontos volt a vállalat számára.
A Decart szintén NVIDIA HGX B200 rendszert futtatott gyártási léptékben. Orian Leitersdorf, a cég vezető kutatója szerint az együttműködésük a képzési és következtetési feladatokat, valamint az interaktív videóélmények biztosítását támogatja. A CoreWeave a HGX B300 mellett a közelgő NVIDIA Vera Rubin platformot is a nagy léptékű, valós idejű generatív és agentikus AI egyik alapjaként említi.
A bejelentés a CoreWeave szerint azt mutatja, hogy az agentikus AI fejlesztésénél a gyorsító mellett a hálózati kapcsolat, a tárhely, a megfigyelhetőség és a klaszterek üzemeltetése is meghatározza, milyen gyorsan juthat el egy rendszer a kísérletezéstől a gyártási használatig.
CoreWeave: From NVIDIA GTC 2026 to Production: What CoreWeave Showed and Why It Matters
CoreWeave: Engineered for Agentic AI: NVIDIA HGX B300 on CoreWeave Cloud