NVIDIA: 2,8 billió tokenes Indic előtanító adat és nyitott adatgeneráló pipeline
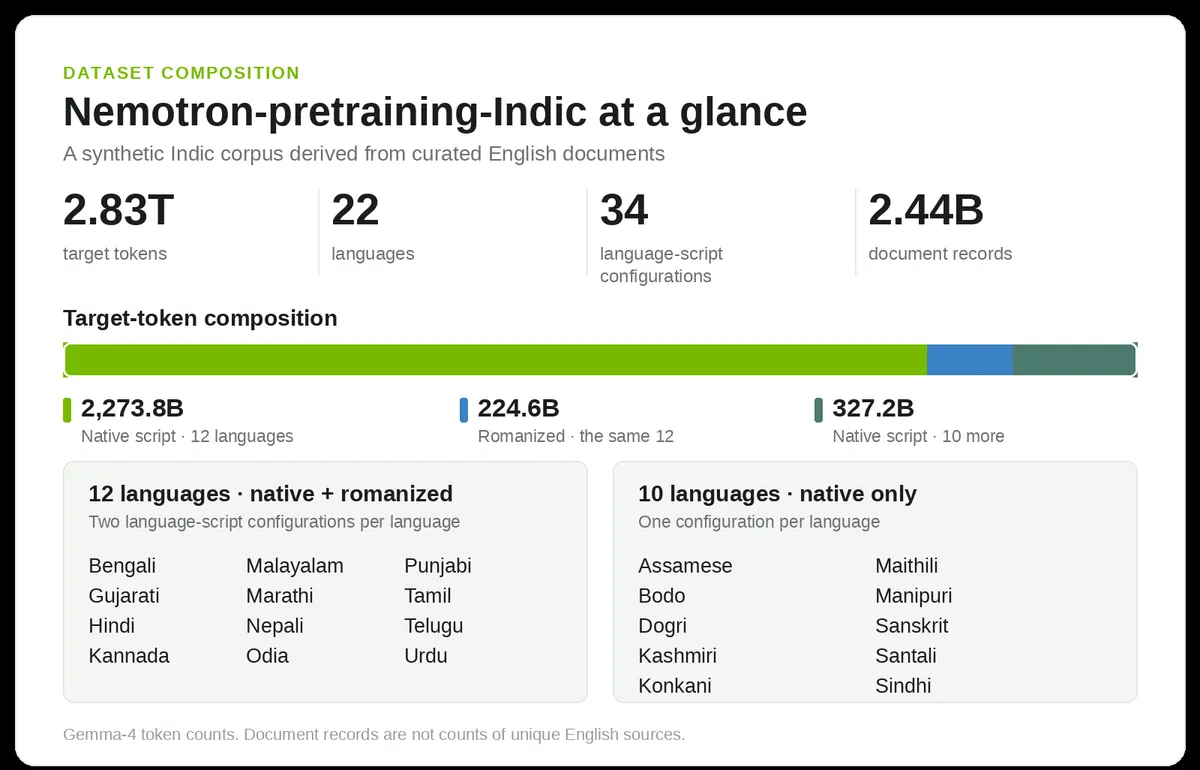
Az NVIDIA a Hugging Face blogján "Scaling Indic Pretraining" címmel közölt bejegyzést, amely 2,8 billió tokenről és egy nyitott adatgeneráló folyamatról (pipeline) szól. A rendelkezésre álló forrásszövegből azonban csak a cím és a kapcsolódó oldalelemek olvashatók ki.
- Az NVIDIA a Hugging Face blogján közölt bejegyzést Scaling Indic Pretraining címmel.
- A cím szerint 2,8 billió tokenről és nyitott adatgeneráló folyamatról van szó.
- A cikk négy modellt, négy adatkészletet és két gyűjteményt említ.
- Az egyik gyűjtemény a Nemotron modellcsalád nagyméretű előtanító adatkészleteit tartalmazza 16 elemmel.
- A módszer és az eredmények részletei a rendelkezésre álló forrásból nem ismertek.
Mit árul el a bejegyzés címe
A bejegyzés címe: Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline. Ebből két dolog derül ki. Az egyik a 2,8 billió (angolul 2.8 trillion) token mennyisége, amely a címben az Indic nyelvekhez kapcsolódó előtanításhoz (pretraining) tartozik. A másik, hogy a szerzők nyitott adatgeneráló folyamatot említenek.
A bejegyzés az NVIDIA szerzői oldalán jelent meg a Hugging Face blogján. Maga a szövegtörzs a rendelkezésünkre álló forrásban nem szerepel, így a módszerről, a nyelvekről, az adatok eredetéről és a felhasznált modellekről a forrás alapján nem tudunk állítani semmit.
Kapcsolódó modellek, adatkészletek és gyűjtemények
Az oldal metaadatai szerint a cikk négy modellt, négy adatkészletet és két gyűjteményt említ. A modellek között szerepel egy 8B méretű fordítási (Translation), egy 31B és egy 66B méretű kép-szöveg (Image-Text-to-Text) modell, valamint egy 124B méretű szöveggeneráló (Text Generation) modell. Az oldal kivonatából a modellek nevei nem derülnek ki, ezért azt sem tudjuk megmondani, melyik szerepel pontosan milyen feladatban a folyamatban.
A két gyűjtemény közül az egyik a Nemotron modellcsalád által használt nagyméretű előtanító adatkészleteket tömöríti 16 elemmel. A másik 19 elemet tartalmaz, és segítőkész, egy- és többfordulós, utasításkövető beszélgetési modellek építésére szolgáló adatkészleteket gyűjt össze.
Mit jelent ez a felhasználóknak és a piacnak
A forrásból annyi vezethető le, hogy az NVIDIA nyilvánosan, a Hugging Face platformján teszi közzé az Indic előtanításhoz kapcsolódó munkáját, és a cím szerint az adatgeneráló folyamat is nyitott. Ez a Nemotron családhoz tartozó nyitott adatkészletek sorába illeszkedik, amelyeket a gyűjtemények is mutatnak.
Hogy a közzétett adatok és eszközök pontosan milyen licenc alatt érhetők el, milyen nyelveket fednek le, és milyen minőségi eredményeket hoztak, azt a bejegyzés teljes szövege dönti el. Ezeket a részleteket a rendelkezésre álló forrás nem tartalmazza.
Hugging Face: Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline