Az NVIDIA NVLink 6 többrétegű hibakezelést ígér az AI-gyáraknak
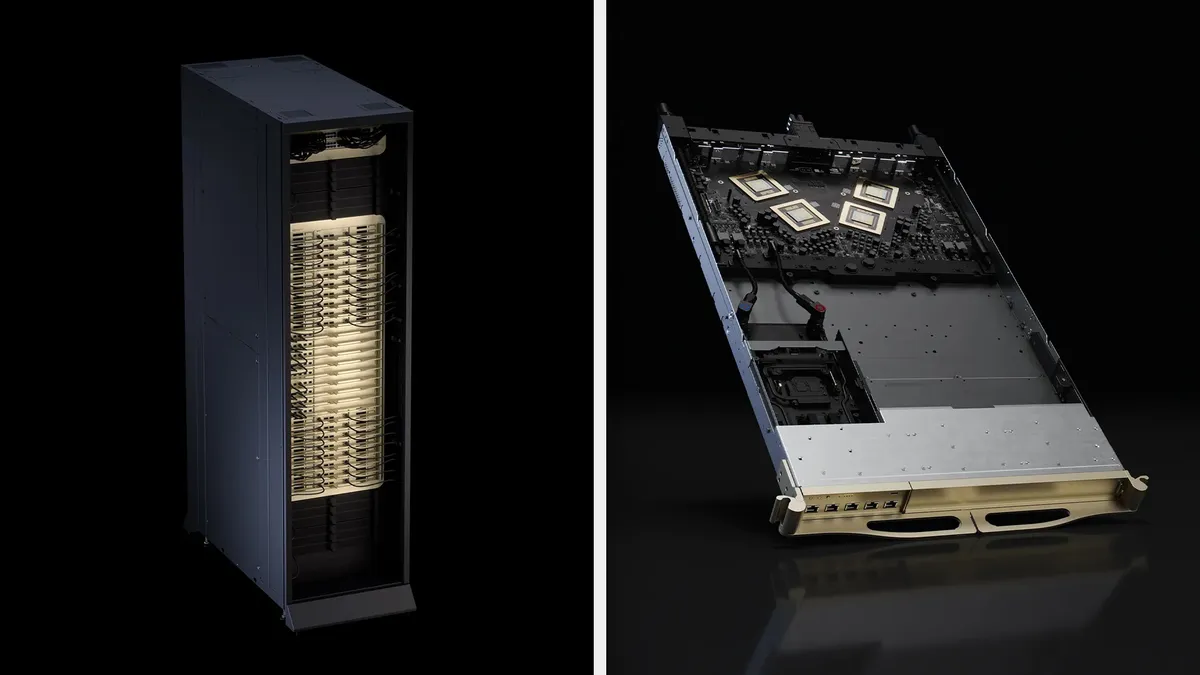
Az NVIDIA szerint az NVLink 6 olyan többrétegű hibakezelési architektúrát kínál az AI-gyárak számára, amely a jelfeldolgozási hibákat, a hálózati torlódást és egyes szoftveres kieséseket is kezeli. A cél a csomagvesztés elkerülése és a nagy léptékű tanítási, illetve következtetési feladatok folyamatos futtatása.
- Az NVLink 6 fizikai és linkrétegbeli hibajavítást kombinál.
- A kreditalapú folyamszabályozás tervezetten akadályozza meg a csomagvesztést.
- Az NMX Controller és a redundáns komponensek helyben tartják a hibákat.
- A Dynamo Shadow Engine Recovery B200 GPU-kon 7,3 másodperces helyreállítást mutatott.
- Az NVLink Fusion egyedi XPU-khoz is elérhetővé teszi az NVLink skálázható fabricét.
A veszteségmentes hálózat alapjai
Az NVIDIA Developer szeptember 15-én közzétett ismertetője szerint a nagy AI-telepítésekben a ritka hibák is komoly teljesítményromlást okozhatnak. A tanítás során a klaszter GPU-inak másodpercenként több ezer kollektív műveletben kell szinkronizálniuk a gradienseket, a következtetésnél pedig minden kiesés csökkenti a kiszolgált kérések mennyiségét.
Az NVLink 6 a vállalat szerint natívan veszteségmentes hálózati szövetet biztosít. A fizikai rétegben könnyű előre irányuló hibajavítást, fizikai rétegbeli újraküldést, valamint UPHY-helyreállítást használ. A hibajavító kódokkal a fogadó oldal közvetlenül rekonstruálhatja a sérült biteket, az NVIDIA állítása szerint közel nulla késleltetési többlettel.
Ha egy hibasorozat meghaladja a hibajavítás képességeit, a Physical Layer Retry újraküldi az érintett adatokat. Fizikai kapcsolatkimaradás esetén az UPHY újrakalibrálja a kapcsolat paramétereit, miközben a csomagokat hardveres visszajátszási puffer tartja meg.
A forgalom szabályozása és a hibák elszigetelése
Az NVLink 6 linkrétege kreditalapú folyamszabályozást használ. A küldő csak akkor helyezhet csomagot a hálózatba, ha a következő hálózati csomópont elegendő pufferkapacitást jelző kredittel rendelkezik. Az NVIDIA szerint ez tervezetten kiküszöböli a csomagvesztést, és kiszámítható, alacsony késleltetésű működést tesz lehetővé.
A rendszer a fizikai kapcsolatok romlásakor automatikusan újraegyensúlyozza a hozzáférési és törzslinkeket. A vállalat szerint ezzel a hibák helyben tarthatók, így nem indulnak el a magasabb szintű újraküldések, időtúllépések és kollektív műveleti leállások.
Az architektúra redundáns kapcsolópolcokat, elosztott NMX Controller vezérlőket és két, sávon kívüli felügyeleti útvonalat is tartalmaz. Ezek célja, hogy egyes komponensek kiesése mellett is működőképes maradjon a tartomány.
Védelem a teljes AI-platform szintjén
Az NVIDIA a hibakezelést nem egyetlen technikára építi. A közlemény szerint a fizikai és linkrétegbeli védelem mellett a rendszer- és alkalmazásszintű helyreállítás is része az NVLink 6 megközelítésének.
A Vera Rubin NVL72 platform 72 Rubin GPU-t kapcsol össze egyetlen skálázható számítási tartományban, az NVLink 6 fabric használatával. Az NVIDIA ezt a Vera Rubin teljes veremű AI-gyárplatformjának központi, rackméretű számítási egységeként írja le.
A szoftveres oldalon a Dynamo Shadow Engine Recovery előmelegített másolatfolyamatot használ. Az ismertető szerint B200 GPU-kon ez 7,3 másodperc alatt állította helyre a következtetési kapacitást, szemben a hideg újraindítás 283 másodpercével. Az NCCL prototípusos támogatást kapott a cuda-checkpoint funkcióhoz is, amely több csomóponton készít ellenőrzési pontokat, és az NVIDIA szerint az általános elérhetőség az év végére várható. Az NVLink Fusion ugyanezt a többrétegű hibakezelési megközelítést egyedi XPU-kra is kiterjeszti.
NVIDIA Developer: How NVIDIA NVLink 6 Delivers Multi-Layer Resiliency for AI Factories