Az NVIDIA NVLink Fusionnel gyorsítaná az egyedi XPUs AI-gyárak építését
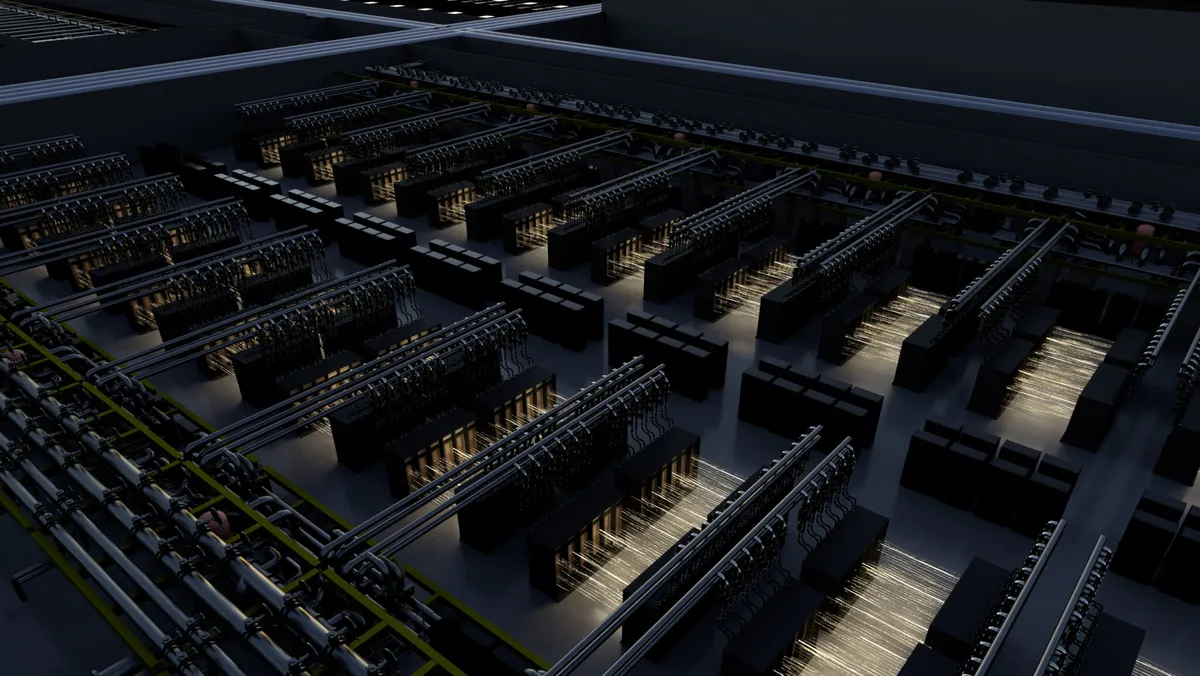
Az NVIDIA 2026. augusztus 24-én ismertette, hogyan illesztené az egyedi XPU-kat az AI-gyárak infrastruktúrájába az NVLink Fusion segítségével. A cég szerint a megoldás a hiperskálázók és AI-natív vállalatok számára csökkentheti a komplexitást, amikor fél-egyedi AI-gyárakat építenek.
- Az NVIDIA 2026. augusztus 24-én mutatta be az NVLink Fusion szerepét az XPU-alapú AI-gyárakban.
- A hatodik generációs NVLink 72 XPU-s tartományt támogat az NVIDIA leírása szerint.
- Az NVIDIA szerint az XPU-k közötti késleltetés 3x alacsonyabb, a csomagráta 10x magasabb lehet az off-the-shelf Ethernetre épülő alternatívákhoz képest.
- Az NVLink-C2C akár 6x energiahatékonyságot kínálhat a PCIe interfészhez képest az NVIDIA állítása szerint.
- Az NVLink Fusion az MGX, DSX és NVIDIA szoftveres komponensek révén a rackszintű tervezést és üzemeltetést is célozza.
Az AI-gyárat teljes rendszerként kell megtervezni
Az NVIDIA blogbejegyzése szerint a nagy léptékű mesterségesintelligencia-infrastruktúrák gazdaságosságát a ténylegesen leadott teljesítmény határozza meg: a másodpercenkénti tokenek száma, a wattonkénti tokenek száma, az egy tokenre jutó költség, a kihasználtság és az üzemidő. A cég ezt azzal indokolja, hogy az AI-gyárak folyamatosan működnek, ezért nem elegendő önálló gyorsítók gyűjteményeként kezelni őket.
Az NVIDIA szerint azoknak a hiperskálázóknak és AI-natív cégeknek, amelyek saját XPU-kat építenek, nem csak a lapka tervezésével kell foglalkozniuk. A teljes AI-platformot is meg kell tervezniük, beleértve a skálázási hálózatokat, a rackszintű architektúrát, az üzemi szoftvereket és a beszállítói ökoszisztémát. A vállalat állítása szerint ez AI-gyár méretben összetett és költséges folyamat, amely akadályozhatja az XPU-k gyors piacra vitelét.
Az NVLink Fusion erre kínál megoldást az NVIDIA leírása alapján: az egyedi XPU-kat a vállalat meglévő AI-infrastruktúrájához kapcsolja, hogy növelje a teljesítményt, gyorsítsa a piacra lépést és mérsékelje a kockázatot a fél-egyedi AI-gyáraknál.
72 XPU-s tartomány, alacsonyabb késleltetés és magasabb csomagráta
Az NVIDIA szerint a modern terhelések, például a billió paraméteres modellek, a mixture-of-experts architektúrák és az ügynöki AI esetében a skálázási hálózat szűk keresztmetszetté válhat. Ha a scale-up fabric nem tart lépést, csökkenhet a kihasználtság és nőhet az egy tokenre jutó költség.
A cég három fő szempontot emel ki egy ilyen hálózatnál: a tényleges végponttól végpontig mért teljesítményt, a gyári szintű ellenállóképességet folyamatos állapotfigyeléssel és telemetriával, valamint a platformérettséget, amely csökkentheti az üzemeltetési kockázatot.
Az NVLink Fusion az XPU-kat az NVIDIA NVLink scale-up tartományába vonja be. A hatodik generációs NVLink az NVIDIA szerint nagy sávszélességű, alacsony késleltetésű hálózatot biztosít egy 72 XPU-s tartományban. A vállalat azt állítja, hogy az XPU-k közötti végponttól végpontig tartó adatátvitel késleltetése 3x alacsonyabb, mint a kereskedelmi Ethernetre épülő alternatív megoldásoknál, a csomagráta pedig 10x magasabb.
A bejegyzés szerint az NVIDIA GB300 NVL72 rendszerek magasabb áteresztőképességet és jobb interaktivitást segítenek elérni azokhoz a konfigurációkhoz képest, amelyek nem használnak NVL72-t. Az NVIDIA jövőbeli NVLink ütemterve legfeljebb 1,152 gyorsítót tartalmazó tartományokat és co-packaged optics megoldásokat is említ. A vállalat azt is írja, hogy a 72 GPU-s NVLink scale-up tartomány a GB300 NVL72 számára magasabb GPU-nkénti áteresztőképességet és interaktivitást tesz lehetővé az NVIDIA B300-hoz képest, az NVIDIA AI Inference Performance Benchmarks oldalának eredményei alapján.
Az NVLink Fusion része az NVIDIA NVLink-C2C is, amely XPU-kat kapcsolhat NVIDIA Vera CPU-khoz vagy más ökoszisztéma-CPU-khoz. Az NVIDIA állítása szerint ez akár 6x energiahatékonyságot kínálhat a PCIe interfészhez képest.
Nyitottabb választás a CPU-k és beszállítók között
Az NVIDIA szerint az egyedi XPU-kon dolgozó csapatok gyakran alábecsülik, mennyi munkát igényel egy adatközponti bevezetés. A felsorolt feladatok közé tartozik a nagy sebességű CPU- és scale-up interfészek integrációja, a scale-up hálózat beszerzése és validálása, a számítási és kapcsolótálcák tervezése, a rackarchitektúra hűtéssel és energiaellátással együtt, a biztonság és tárolás integrációja, valamint az összetett beszállítói kör kezelése.
Az NVLink Fusiont az NVIDIA olyan ökoszisztémával írja le, amely ASIC-tervezési, CPU-, IP- és optikai összeköttetési partnereket fog át. Tim Wilson, az Intel adatközponti szilíciumtervezésért felelős alelnöke és vezérigazgatója az NVIDIA közlése szerint így fogalmazott: „Az NVLink Fusion lehetőséget ad az ügyfeleknek arra, hogy kiválasszák azt a CPU-architektúrát, teljesítményszintet és szoftveres képességeket, amelyek a számukra fontos munkaterhelésekhez a legjobban illenek.”
Az NVLink Fusion használói az NVIDIA MGX rackszintű architektúráját és ugyanazt az ellátási láncot is igénybe vehetik, amelyet az MGX-alapú rendszerek, például az NVIDIA Vera Rubin NVL72 használnak. Az NVIDIA szerint a gyártópartnerek a tervezést és integrációt kezelik, míg az MGX beszállítók a rackhez, hűtéshez, energiaellátáshoz és a megjelenő 800 VDC kialakításokhoz adnak építőelemeket.
Jack Luoh, a QCT és Quanta Computer termék- és megoldásvezetője az NVIDIA blogja szerint azt mondta: „A Vera Rubin [NVL72] esetében a gyártósoron a rendszerépítések majdnem 100%-os automatizálását vizsgáljuk.” Hozzátette: „Ezeknek a beruházásoknak a többsége hasznosítható, ha az XPU az NVLink Fusiont használja.”
Standardizált rackekkel csökkentenék a tervezési kockázatot
Az NVIDIA szerint az AI-gyárak tervezése jóval azelőtt elindul, hogy véglegessé válna a gyorsítók összetétele. Az energia beszerzése, a létesítmény megtervezése, a hűtés, a rackelrendezés és a hálózati architektúra korai döntéseket igényel. A bejegyzés azt állítja, hogy egyetlen chiphez kötött adatközpont ütemezési kockázatot jelenthet, miközben különböző munkaterhelések eltérő gyorsítókat részesíthetnek előnyben, köztük XPU-kat, GPU-kat, CPU-kat és LPU-kat.
Vince Hu, a MediaTek adatközponti és számítástechnikai üzletágának vállalati szenior alelnöke és vezérigazgatója az NVIDIA közlése szerint így írta le a program értékét: „Az NVLink Fusion program értéke az, hogy … [az ügyfelek] bevezethetik a rackszintű megoldásukat az NVIDIA GPU-val, majd leválaszthatják az XPU fejlesztését, és más ütemben haladhatnak vele.”
Az NVLink Fusion egységes architektúrát kínál az NVIDIA szerint. Az XPU- és GPU-alapú rendszerek, például a Vera Rubin NVL72, megoszthatják a racklábnyomot, a hálózatot, a hűtést, az energiaellátást és a menedzsmentrendszereket. A vállalat szerint ez lehetővé teheti, hogy az üzemeltetők előrehaladjanak az építéssel, miközben a pontos szilíciumösszetételt később véglegesítik.
A cég a validálást is hangsúlyozza. Az NVLink Fusion az NVIDIA DSX referenciaarchitektúrához igazodik, amely az épületet, az energiát, a hűtést, a számítást és a hálózatot együtt kezeli. Az NVIDIA Omniverse DSX AI Factory Blueprint digitális ikert és nyílt referenciatervet ad gigawatt léptékű AI-gyárakhoz, hogy a partnerek még a bevezetés előtt modellezhessék a létesítményt és a technológiát.
Mit jelenthet ez az AI-infrastruktúra építőinek
A felhasználói oldalon a bejelentés fő üzenete az, hogy az egyedi XPU-k nem elszigetelt gyorsítóként, hanem egy előre validált, rackszintű AI-platform részeként jelenhetnek meg. Az NVIDIA szerint ez különösen azoknak lehet fontos, akik fél-egyedi AI-gyárakat akarnak építeni, de közben meglévő hálózati, hűtési, energiaellátási és menedzsmentmegoldásokra támaszkodnának.
A bejegyzés alapján a szolgáltatók rugalmasabban kezelhetik a kapacitástervezést is. Az NVIDIA azt állítja, hogy az üzemeltetők az építést a végleges gyorsítókeverék rögzítése előtt is folytathatják, majd a kapacitást a munkaterhelési igények, a szilíciumellátás és az üzleti prioritások változásai szerint újraoszthatják.
A működtetéshez az NVIDIA NCCL-t említi az elosztott terhelésekhez, az NVIDIA Dynamo és NIXL megoldásokat a szétválasztott architektúrákhoz, valamint az NVIDIA Mission Controlt a klasztermenedzsmenthez, telemetriához és hibakereséshez. Az NVIDIA szerint ezek segíthetnek abban, hogy a vegyes AI-infrastruktúra összehangolt rendszerként működjön.
NVIDIA: How XPUs Meet a World-Class AI Factory