Az NVIDIA NVHBM-mel bővíti az NVLink Fusion AI-infrastruktúrát
Az NVIDIA 2026. augusztus 26-án ismertette, hogyan kapcsolódik az NVHBM memóriatechnológia az NVLink Fusion platformhoz. A vállalat szerint a megoldás a testreszabott XPUs és CPUs bevezetését segíti a következő generációs AI-infrastruktúrákban.
- Az NVIDIA 2026. augusztus 26-án mutatta be az NVHBM szerepét az NVLink Fusion mellett.
- Az NVHBM az NVIDIA szerint akár 30 százalékkal nagyobb memória-sávszélességet adhat stackenként a standard HBM4e-hez képest.
- A technológia akár 67 százalékkal csökkentheti a PHY és támogató területek méretét a JEDEC HBM4e szabványhoz viszonyítva.
- Az NVIDIA szerint az NVHBM akár 15 százalékkal alacsonyabb HBM-fogyasztást tehet lehetővé.
- Az NVLink Fusion és az NVHBM együtt a vállalat állítása szerint XPU-nként 30 százalékos végponttól végpontig mért teljesítménynövekedést hozhat.
Testreszabott gyorsítókhoz igazított AI-infrastruktúra
Az NVIDIA Developer blogon megjelent bejegyzés szerint az AI-gyáraknak egyre nagyobb modelleket és összetettebb következtetési feladatokat kell kiszolgálniuk. Erre válaszul a hyperscalerek és az AI-natív vállalatok saját AI-gyorsítókat, az NVIDIA szóhasználatával XPUs eszközöket fejlesztenek.
Az NVIDIA NVLink Fusion a vállalat leírása szerint olyan kapcsolati technológia és IP, amely lehetővé teszi, hogy ezek a cégek egyedi XPUs és CPUs megoldásokat illesszenek be az NVIDIA AI-infrastruktúra-platformjába. A bejegyzés szerint a résztvevők az NVIDIA scale-up és scale-out technológiai stackjét, ökoszisztémáját, valamint az MGX rack-szintű architektúrát használhatják, hogy csökkentsék a fejlesztési és telepítési összetettséget, javítsák a teljesítményt, és gyorsítsák a piacra jutást a félig testreszabott AI-gyáraknál.
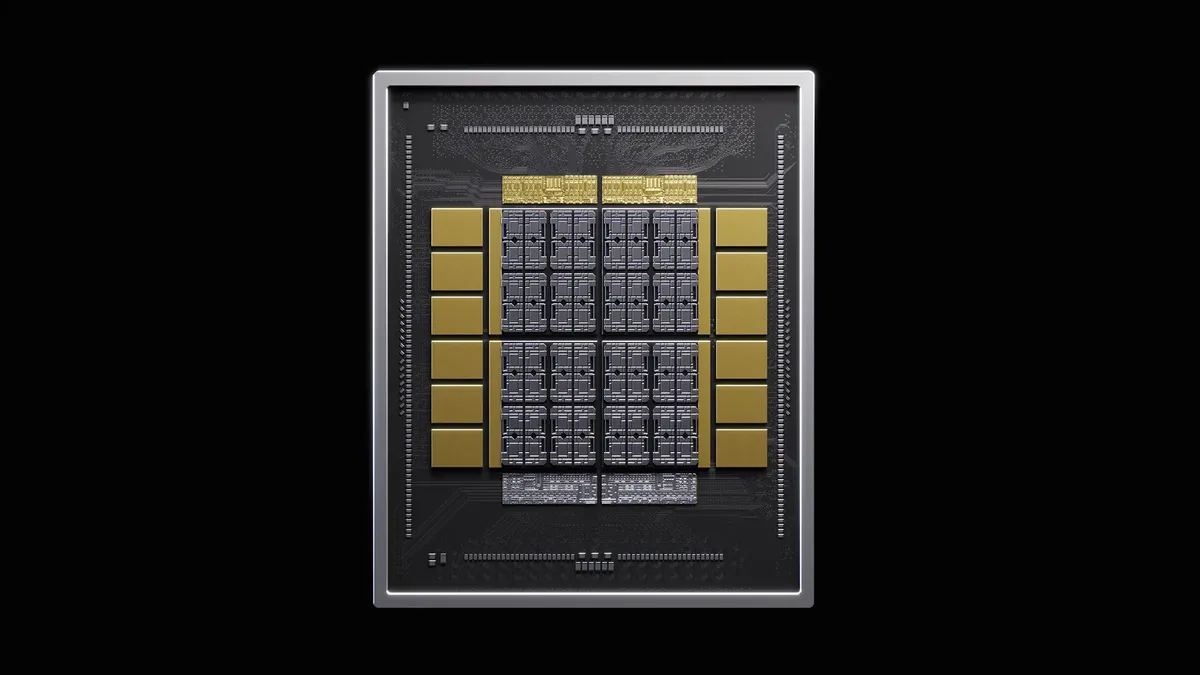
Ehhez kapcsolódik csomagszinten az NVHBM. Az NVIDIA meghatározása szerint ez egy egyedi HBM base-die technológia, amelyet vezető memóriagyártókkal terveztek és validáltak. A cél a nagyobb memória-sávszélesség, a jobb területkihasználás és az alacsonyabb energiafogyasztás. A vállalat szerint ezek az előnyök segíthetik a nagyobb modellek támogatását, a KV-cache adatok gyorsabb olvasását, valamint a tréning és a nagy léptékű inferencia javítását.
Nagyobb sávszélesség, kisebb helyigény
Az NVIDIA szerint a tréning, az inferencia és az agentic AI terhelések mindinkább nagy áteresztőképességű hozzáférést igényelnek a modellsúlyokhoz, a KV-cache-hez és az aktivációs adatokhoz. A HBM a nagy memória-sávszélességet közel viszi a gyorsítóhoz, de a vezető memóriatechnológiák minősítése, a csomagintegráció és a validálás szűk keresztmetszet lehet az egyedi gyorsítóprogramoknál.
A vállalat szerint az NVLink Fusion ügyfelei hozzáférhetnek olyan NVHBM base die megoldásokhoz, amelyeket vezető memóriagyártókkal validáltak. Az NVIDIA három fő platformszintű előnyt emel ki: az NVHBM akár 30 százalékkal nagyobb memória-sávszélességet kínálhat stackenként a standard HBM4e-hez képest, az interfészkapcsolatok hatékonyabbá tételével akár 25 százalékkal több compute die területet adhat további XPU-képességekhez, és akár 15 százalékkal alacsonyabb HBM-fogyasztást érhet el a standard HBM4e-hez viszonyítva.
A sávszélesség szerepét az NVIDIA azzal indokolja, hogy az AI-gyorsítók teljesítménye nagyban függ attól, mennyire folyamatosan kapnak adatot a számítási egységek. Memória-korlátos vagy részben memória-korlátos AI-terheléseknél a magasabb HBM-sávszélesség jobb gyorsítókihasználtságot és nagyobb áteresztőképességet eredményezhet. A bejegyzés szerint ez nagy modellű inferencia esetén növelheti a felhasználónkénti tokenátvitelt, mert gyorsabban mozognak az adatok a HBM és a számítási magok között.
Az NVIDIA a rack-szintű működést is kiemeli. Az NVHBM az egyes gyorsítókon belül növeli a memória-sávszélességet, míg az NVLink Fusion nagyobb tartományokban köti össze a gyorsítókat, hogy a feladatok hatékonyabban használhassák az elosztott számítást és memóriát. A vállalat szerint ez különösen fontos olyan fejlett útválasztási technikáknál, mint az expert parallelism vagy a WideEP, ahol különböző szakértők különböző GPU-kon helyezkednek el, és nagy sebességű, zökkenőmentes szinkronizációra van szükség a teljes rackben.
A memória-interfész áttervezése szilíciumterületet szabadíthat fel
Az NVIDIA szerint az egyedi AI-szilíciumnál minden négyzetmilliméter számít. A gyorsítótervezőknek el kell dönteniük, mennyi terület jut mátrixmotorokra, vektoregységekre, chipen belüli SRAM-ra, gyorsítótár-hierarchiára, vezérlőlogikára, memória-interfészekre, hálózat a chipen belül megoldásokra és scale-up kapcsolódásra.
A bejegyzés alapján az NVHBM a memória-interfészhez szükséges terület csökkentésével adhat nagyobb mozgásteret. A megtakarítás fő forrása az áttervezett fizikai memória-interfész, vagyis a PHY. A standard HBM szélesebb interfészkapcsolatokra támaszkodik, ami növeli a teljes csomag helyigényét. Az NVHBM ezzel szemben egy hatékonyságra optimalizált egyedi base die-t használ, amelynél a memória-vezérlő a 3D HBM stackbe kerül, és egyedi PHY integrálódik.
Az NVIDIA szerint ez a kialakítás a JEDEC HBM4e szabványhoz képest akár 67 százalékkal csökkenti a PHY és a támogató területek méretét. A keskenyebb interfész az interposer útvonalvezetését is egyszerűsíti, ami a teljes elrendezésben akár 80 százalékkal több használható szilíciumot biztosíthat. A vállalat azt írja, hogy a memória-interfész kapcsolatainak zsugorítása lehetővé teszi a központi AI compute die kiterjesztését a felszabadult területre, így akár 30 százalékkal nőhet a fő die-en elérhető szilíciumterület számításra vagy más funkciókra.
Energiafogyasztás és rack-szintű teljesítmény
Az NVIDIA a teljesítmény mellett az energiafogyasztást is kulcskorlátnak nevezi a modern AI-infrastruktúrában. A HBM fogyasztása hatással van a gyorsító energia-keretére, a csomag hőtervezésére, a rack energiahatáraira és az adatközpont hűtési tervére.
A vállalat szerint az NVHBM akár 15 százalékkal alacsonyabb HBM-fogyasztást tesz lehetővé a standard HBM4e-hez képest. XPU-szinten ez javíthatja a wattonkénti teljesítményt, és teret adhat több számításnak vagy magasabb tartós kihasználtságnak. Rack-szinten csökkentheti az energiaellátási és hűtési rendszerekre nehezedő nyomást. AI-gyár méretben a memória-alrendszer szerényebb fogyasztáscsökkenése is összeadódhat több ezer gyorsítón.
Az NVIDIA példája szerint egy teljes, 1 gigawattos adatközpontban, 2,000W teljesítményű XPUs eszközökkel számolva az energiamegtakarítás akár 15,000 további XPU számítási mozgásterét teheti lehetővé. A vállalat szerint ez különösen fontos nagy modellű inferenciánál, ahol az XPUs eszközöknek ismételten kell olvasniuk a modellsúlyokat és a KV-cache adatokat, miközben alacsony késleltetéssel és nagy áteresztőképességgel szolgálják ki a felhasználókat.
Az NVIDIA állítása szerint az NVLink Fusion és az NVHBM együtt, a 30 százalékos memória-sávszélesség-növekedés, a 25 százalékkal nagyobb die-terület és a 15 százalékos HBM-energiamegtakarítás összeadódó hatásával, XPU-nként 30 százalékos teljes, végponttól végpontig mért teljesítménynövekedést eredményezhet.
Mit jelenthet ez az AI-infrastruktúra szereplőinek
A bejelentés fő üzenete a hyperscalereknek és az AI-natív vállalatoknak szól: az NVIDIA olyan infrastruktúra-utat kínál, amelyben a saját XPUs és CPUs fejlesztések illeszthetők az NVIDIA AI-platformjához. A forrás alapján ennek gyakorlati értéke a fejlesztési és telepítési bonyolultság mérséklése, a nagy sávszélességű memória validált integrációja, valamint a rack-szintű architektúra használata.
A felhasználói oldalon a hatás közvetetten jelenhet meg. Az NVIDIA szerint a nagyobb HBM-sávszélesség és az alacsonyabb adatmozgatási energia gyorsabb nagy modellű inferenciát, nagyobb batchméreteket és a telepített energia hatékonyabb felhasználását támogathatja. A piacon ez azoknak a szereplőknek lehet lényeges, amelyek saját AI-gyorsítóval dolgoznának, de közben nagy léptékű, NVIDIA-alapú adatközponti környezetbe szeretnék illeszteni azokat.
NVIDIA Developer: NVIDIA NVLink Fusion Brings NVHBM to Next-Generation AI Infrastructure