Az NVIDIA PAIR a helyi hálózaton osztja szét az AI-kéréseket
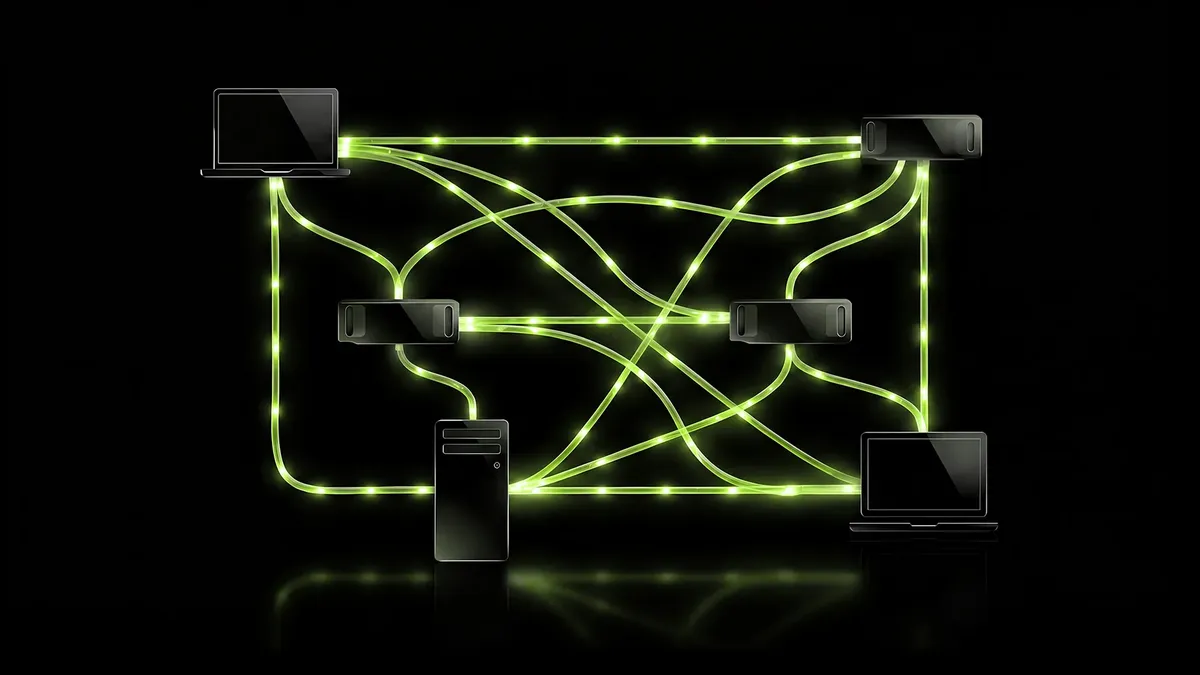
Az NVIDIA 2026. szeptember 3-án bemutatta a Personal AI Router, röviden PAIR bétáját, amely a helyi hálózaton elérhető kompatibilis gépek között irányítja az önálló AI-inferenciakéréseket. A megoldás az Ollama és az LM Studio ismert felületeivel működik, az NVIDIA szerint az ügynököket futtató keretrendszerek módosítása nélkül.
- Az NVIDIA PAIR a helyi hálózaton lévő kompatibilis rendszerek között irányítja az önálló inferenciakéréseket.
- A béta az Ollama és az LM Studio felületeivel működik, az NVIDIA szerint ügynökkeretrendszer-módosítás nélkül.
- Támogatottak a GeForce RTX 20 Series és újabb GPU-k, RTX PRO munkaállomás-GPU-k, DGX Spark és Apple M4+ silicon rendszerek.
- Egy öt alügynökös demóban a három eszközös PAIR-klaszter 8 perc 48 másodperc alatt végzett, szemben az egy RTX Spark laptopon mért 18 perccel.
- A rendszer mDNS-alapú helyi felfedezést, biztonságos párosítást és élő ütemezést használ a csomópontok állapota alapján.
A többügynökös munkák szűk keresztmetszetére céloz
Az NVIDIA fejlesztői blogja szerint az AI-ügynökök egyre gyakrabban dolgoznak együtt: egy vezető ügynök részfeladatokra bonthat egy összetett munkát, majd ezeket specializált alügynököknek adhatja ki. A felhasználók emellett több ügynökmenetet is futtathatnak párhuzamosan. Ez a megközelítés gyorsíthatja a feladatok elvégzését és javíthatja a válaszok minőségét, de a GPU-nál torlódást okozhat, ha egyszerre sok kérés érkezik.
Erre kínál megoldást az NVIDIA Personal AI Router, amely minden önálló inferenciakérést egy elérhető, helyi hálózaton lévő rendszerhez irányít. A PAIR az NVIDIA leírása szerint az olyan helyi inferenciaszolgáltatásokkal működik, mint az Ollama és az LM Studio, így a felhasználók bővíthetik az ügynök rendelkezésére álló számítási kapacitást anélkül, hogy magát az ügynököt újra kellene tervezniük.
A béta támogatott Windows, macOS és Linux rendszereken érhető el grafikus és terminálos felületen. A kompatibilis hardverek közé tartoznak az NVIDIA GeForce RTX 20 Series és újabb GPU-k, a Turing architektúrás és újabb NVIDIA RTX PRO munkaállomás-GPU-k, valamint az NVIDIA DGX Spark és az Apple M4+ silicon.
Nem új inferenciamotor, hanem virtuális útválasztó
Az NVIDIA hangsúlyozza, hogy a PAIR nem új inferenciamotor, hanem virtuális inferenciaútválasztó. A modellt továbbra is az Ollama vagy az LM Studio futtatja a kiválasztott gépen. A PAIR feladata a részt vevő rendszerek felismerése, annak követése, hogy melyik gép áll készen egy kérés fogadására, az önálló munkák ütemezése, majd a válasz visszajuttatása ahhoz az alkalmazáshoz, amely a kérést indította.
A működés lényege, hogy az ügynök a megszokott helyi felületen küld kérést. A PAIR a proxyján keresztül fogadja ezt, azonosítja az inferenciamotort és a modellkövetelményeket, majd kiválaszt egy alkalmas csomópontot. A kiválasztott gép a kérést elejétől a végéig végrehajtja, és a választ a PAIR-en keresztül küldi vissza. Az ügynök közben egyetlen kapcsolatot lát, miközben az elhelyezést a PAIR kezeli a háttérben.
A rendszer nem vezet be új API-t: kompatibilis Ollama és LM Studio felületeket proxyz. Az NVIDIA szerint a kliensek rugalmasan csatlakozhatnak a kapacitáshoz, amikor elérhetők, majd kieshetnek például kikapcsolás vagy hibernálás miatt. A vállalat azt is kiemeli, hogy a PAIR-t úgy tervezték, hogy a promptok, az adatok és az inferenciaforgalom a felhasználó meglévő helyi hálózatán maradjon.
Hogyan dönt a PAIR, melyik gép dolgozzon?
A PAIR-t az NVIDIA nem adatközpontszerű, állandóan bekapcsolt környezetre írja le, hanem otthoni AI-klaszterekre, ahol a gépek állapota gyakran változik. Egy játékra használt PC éppen leterhelt lehet, egy laptop alvó állapotba kerülhet vagy elhagyhatja a hálózatot, egy munkaállomáson megvan a kért modell, egy másik gépen pedig nincs.
A rendszer helyi hálózati felfedezést használ mDNS-sel, támogatott eszközöket párosít a privát hálózaton, és élő képet tart fenn arról, mely csomópontok tudnak új munkát fogadni. Szükség esetén egy csomópont IP-cím alapján is hozzáadható, a felhasználó pedig jóváhagyja a biztonságos párosítási kérést a megbízható helyi csomópontok létrehozásához. A forrás összefoglalója MTLS titkosítást is említ a biztonságos párosítás részeként.
Új kérésnél a PAIR több tényezőt mérlegel. Ilyen, hogy egy párosított csomópont online és készen áll-e, engedélyezve van-e rajta támogatott inferenciamotor, jelen van-e pontosan a kért modell, mekkora a csomópont és a motor aktuális terhelése, hány aktív feladat fut, valamint mennyi a GPU-kihasználtság, például fut-e grafikaigényes alkalmazás vagy eszköz.
Fontos korlát, hogy a PAIR nem futtat egyetlen inferenciakérést több GPU-n egyszerre. Minden kérés egy alkalmas csomópontot kap, és teljes élettartama alatt ott marad. Ez munkaszintű párhuzamosságot jelent: ha elég sok önálló részfeladat van, a kérések több gép között oszthatók szét.
A bemutatóban 18 perc helyett 8 perc 48 másodperc volt a futásidő
Az NVIDIA egy Hermes Desktop és Ollama alapú bemutatót is közölt. A feladatban a Hermes egy szintetikus háztartási postafiókot elemzett, majd egy megbízható Sunday Reset tervet készített arról, minek kell megtörténnie aznap este, azon a héten, később, illetve minek nem kell megtörténnie, minden lényeges következtetéshez bizonyítékot társítva.
Az öt alügynökös futásban a Hermes öt specialistát hozott létre az egymástól független bizonyítékrészek áttekintésére, az ellentmondások feloldására és az összevont terv visszaadására. A feladat felbontása, delegálása és összefoglalása a Hermeshez tartozott, az inferencia útválasztása a PAIR-hez, a kérések végrehajtása pedig az Ollamához.
Qwen 3.6 35B A3B modellel, egyetlen NVIDIA RTX Spark laptopon az azonos öt alügynökös munkaterhelés átlagosan 18 perc alatt készült el. Egy három eszközből álló PAIR-klaszterrel, amely egy RTX Spark laptopból, egy DGX Sparkból és egy RTX 5090-ből állt, az átlagos futásidő 8 perc 48 másodperc volt.
Az NVIDIA külön jelzi, hogy ez nem általános benchmark és nem lineáris skálázódási ígéret, hanem nem hivatalos, konfigurációspecifikus demó. Az eredmények a munkaterhelés párhuzamosíthatóságától, a modelltől, a motorbeállításoktól, a hardvertől, a hálózattól és a csomópontok elérhetőségétől függenek. A blog szerint a PAIR Jobs nézete mutatja hitelesen, hol futott az inferencia, és a többcsomópontos végrehajtás csak akkor állítható, ha a PAIR telemetriája több alkalmas csomóponton futó munkákat mutat.
Mit jelent ez a helyi AI-t futtató felhasználóknak?
A PAIR azoknak lehet hasznos, akik több kompatibilis gépet tartanak a helyi hálózaton, és helyben futtatott ügynökökkel vagy több párhuzamos AI-munkamenettel dolgoznak. A forrás alapján a megközelítés akkor tud előnyt adni, ha a feladat több független modellhívásra bontható, mert ezek egy része a fő PC-n, más része további párosított csomópontokon futhat.
Az NVIDIA szerint ez csökkentheti a sorban állást és javíthatja a teljes feladat befejezési idejét, miközben a fő PC szabadabban maradhat grafikaigényes játékra, tartalomkészítésre vagy más interaktív munkára. A rendszer ugyanakkor a mindennapi otthoni használathoz igazodik: nem feltételezi, hogy minden gép azonos, folyamatosan elérhető vagy állandóan inferenciára van fenntartva.
A következő lépésként az NVIDIA a PAIR béta letöltését ajánlja támogatott Windows, macOS vagy Linux rendszerre, valamint a Personal AI Router tárának megtekintését kódellenőrzéshez, hibajelentéshez vagy fejlesztési hozzájáruláshoz.
NVIDIA Developer: NVIDIA PAIR Virtual Inference Router Expands Available Compute on Your Local Network